[논문리뷰] MemInStream: Memorizing or Merely Recognizing? Rethinking Streaming Video Memory Evaluation
링크: 논문 PDF로 바로 열기
저자: Zhenqi He, Dunyuan Xu, Yang Bo, et al. (HKUST, CUHK, Huawei Research, CityU)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Memory Solvability: 정답에 필요한 historical evidence를 직접 줬을 때 모델이 문제를 풀 수 있는지를 뜻한다. 이를 통과하지 못한 문항에서는 오답이 나와도 memory failure인지, visual understanding failure인지 구분할 수 없다.
- Memory Necessity: 과거 evidence 없이는 문제를 풀 수 없는지를 뜻한다. linguistic prior, answer-option cue, 최근 frame만으로 답할 수 있는 shortcut을 걸러내는 기준이다.
- Evidence Interval (EI): 각 질문의 query timestamp (t_q) 이전에 있으면서 정답에 필요한 시각 정보가 담긴 시간 구간 ([s_i, e_i])이다. 질문마다 여러 개가 annotation될 수 있다.
- Post-EI setting: 마지막 evidence interval이 끝난 시점부터 query 시점까지의 영상만 모델에 주는 조건이다. evidence 이후의 관찰만으로 답을 복원할 수 있는지 검사한다.
- Exact-match Accuracy: single-answer와 multiple-answer를 섞은 형식에서, 예측한 option 집합이 ground-truth 집합과 완전히 일치해야만 정답으로 인정하는 지표다. 정답 개수는 모델에 알려주지 않는다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 streaming video benchmark의 QA accuracy만으로는 모델이 실제로 기억(memorizing)하는지, 단순히 인식(recognizing)하는지를 구분할 수 없다는 것이 이 논문이 다루는 핵심 문제다. 저자들은 두 가지 모호성을 지적한다.
- Unverified Memory Solvability: 최신 video understanding 모델은 필요한 evidence interval을 직접 받고도 OVO-Bench, StreamingBench, S-EMBER의 문항 중 거의 4분의 1을 틀린다. 이 경우 오답을 forgetting 탓으로 돌릴 수 없다.
- Unverified Memory Necessity: text-only baseline이 기존 benchmark에서 꽤 경쟁력 있는 accuracy를 낸다. 또한 최근 4 frame만 쓰는 SimpleStream이 memory 기반 방법인 FluxMem보다 오히려 성능이 높다 [Figure 1].
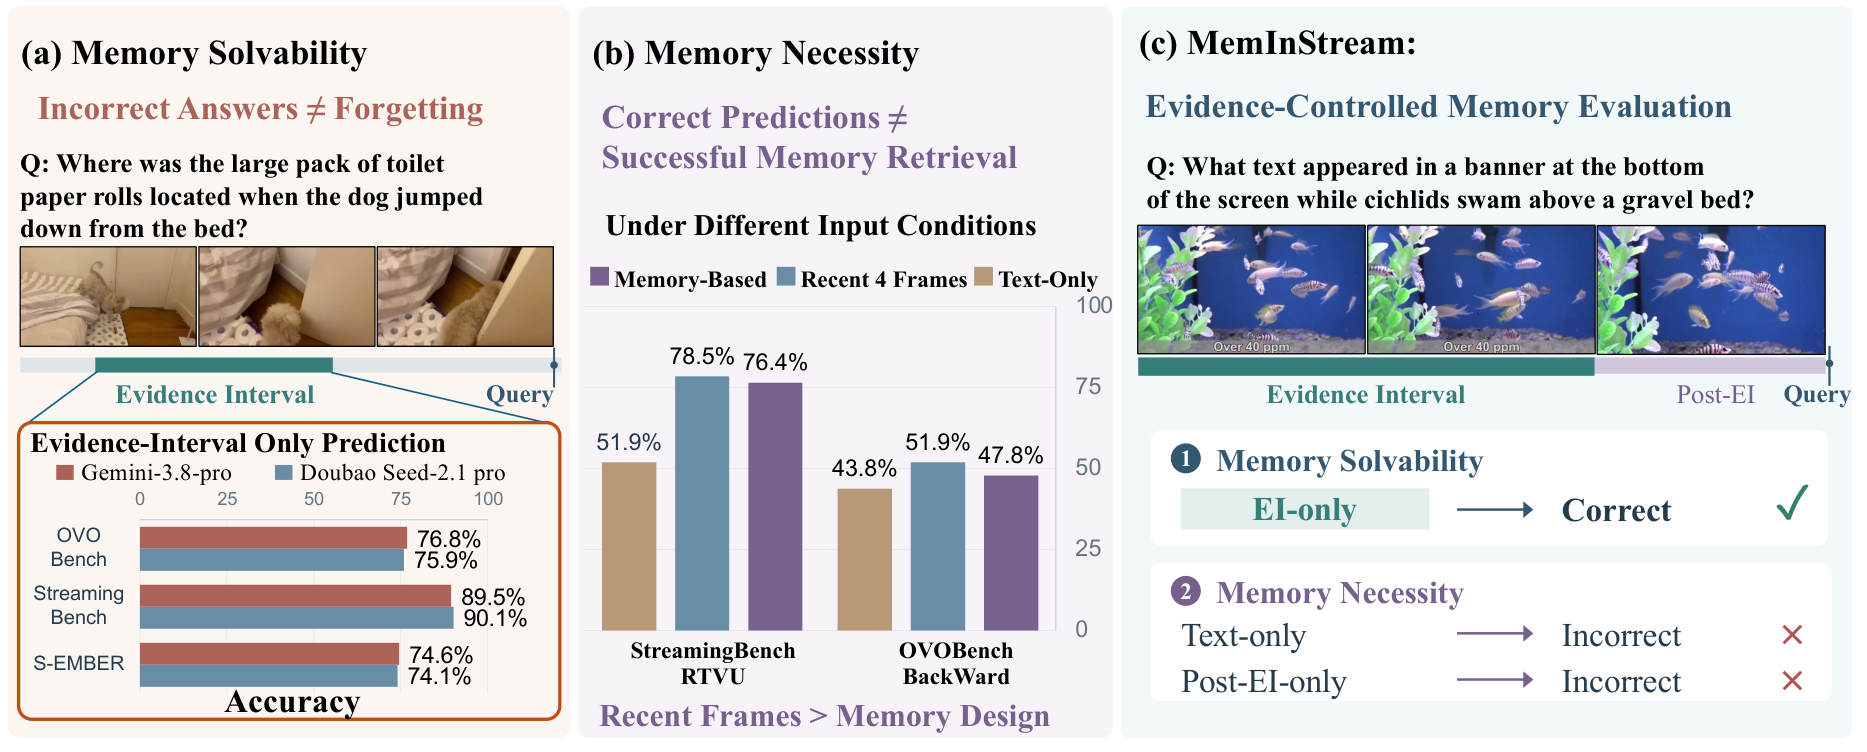
Figure 1 — 기존 평가 문제와 검증 개요
StreamingBench, OVBench, OVO-Bench, TeleEgo, PhoStream, EgoStream, S-EMBER 등 기존 benchmark는 memory 관련 문항을 포함하지만, evidence의 sufficiency와 necessity를 체계적으로 검증하지 않는다. 따라서 memory를 우회하는 shortcut을 막을 수 없고, 이를 해결할 새로운 평가 체계가 필요하다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 streaming video memory 평가 전용 benchmark인 MemInStream과, 그 핵심 장치인 evidence-controlled validation protocol을 제안한다 [Figure 1].
문제 정식화
- 모델은 (M_t = \mathcal{U}(M_{t-1}, v_t))로 memory를 순차적으로 갱신한다.
- query 시점에는 원본 영상이나 미래 frame에 접근할 수 없고, 자신이 유지한 memory만으로 답해야 한다.
Taxonomy (4개 category, 17개 fine-grained task)
- Episodic Retrieval: 6개 task (예: Attribute Recall, Temporal Fact Recall)
- State Tracking & Updating: 4개 task (예: Latest-State Retrieval, Correction/Revision Memory)
- Multi-Evidence Integration: 5개 task (예: Counting, Multi-hop Memory Binding)
- Contextual Memory: 2개 task (Entity–Identity Binding, Conversational Context Memory)
Construction pipeline [Figure 2]
- 기존 5개 benchmark에서 memory 관련 문항을 수집한다.
- LLM으로 검색어를 만들어 web 영상을 추가로 모으고, VLM으로 새 QA를 생성한다.
- VLM으로 query timestamp와 evidence interval을 annotation한다.
- Gemini-3.8-Flash와 Doubao Seed-2.1-Pro 두 validation 모델로 아래 조건을 검사하고, 두 모델이 모두 기준을 만족한 문항만 남긴다.
- Solvability: evidence-only 조건에서 두 모델 모두 정답을 맞혀야 한다.
- Necessity: text-only 조건과 post-EI 조건에서 두 모델 모두 틀려야 한다.
- Contextual Memory 추가 검증: Relevant dialogue + EI에서는 정답, Irrelevant dialogue + EI와 Relevant dialogue + Post-EI에서는 오답이어야 한다.
- 마지막으로 human verification을 거친다.
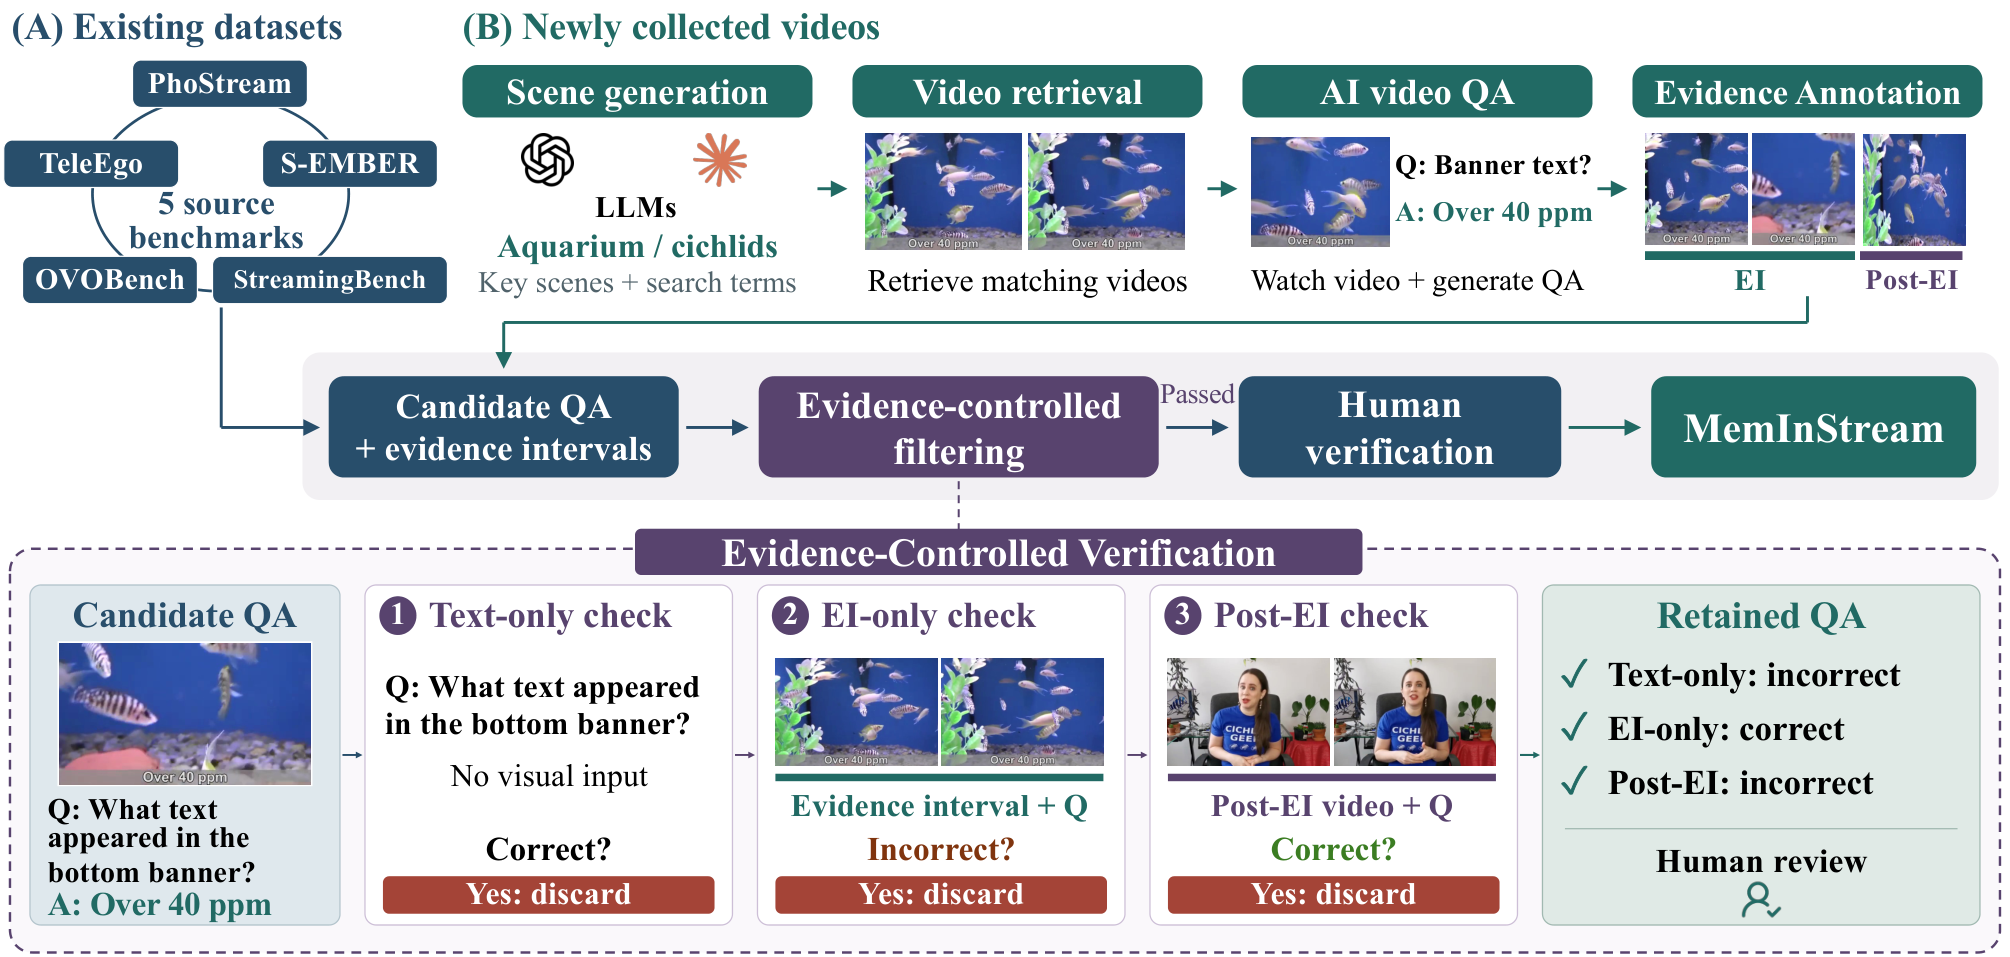
Figure 2 — Benchmark 구축 파이프라인
Benchmark 통계
- 최종 문항은 3,799개이고, evidence interval은 8,217개(문항당 평균 2.16개)다.
- 56.7%의 문항이 multi-evidence 문항이다.
- query까지의 median distance는 latest evidence 기준 36초, earliest evidence 기준 96초다.
주요 결과 (정량 결과는 HTML Table 2 기준)
- Online 모델 비교: training-based 모델인 StreamForest가 4개 category 모두에서 online 모델 중 가장 높은 평균을 기록했다. State Tracking & Updating 37.06%, Multi-Evidence Integration 37.34%로, 이 두 category에서는 proprietary 모델보다도 높다.
- 어려운 task: Multi-hop Memory Binding에서 Gemini-3.8-Flash (30 frames)는 13.07%, StreamForest는 23.86%에 그쳤다. StreamForest는 Entity–Identity Binding에서 52.54%를 얻었지만 Conversational Context Memory에서는 18.28%로 크게 떨어졌다.
- Frame 수의 효과: frame을 4개에서 30개로 늘리자 Episodic Retrieval에서 Gemini는 26.38% → 44.96%, Doubao는 20.93% → 38.63%로 올랐다. 다만 이 개선이 모든 category에서 일관되게 나타나지는 않았다.
- Backbone의 효과: FluxMem과 Response-G1은 backbone을 Qwen2.5-VL에서 Qwen3-VL로 바꾸자 4개 category 모두에서 크게 개선됐다.
- Evidence coverage 분석: 입력 window가 evidence를 완전히 포함할 때 Gemini는 90.6%(4 frames) / 86.2%(30 frames)를 기록했다. 포함하지 않을 때는 21.8% / 19.8%에 불과했다.
- Temporal distance 분석: 약 30초의 최근 영상만 보는 AURA는 30초를 넘어서자 accuracy가 36.6% → 18.0%로 급락했다.
- Memory 유무 비교: JoyAI-VL-Interaction에서 memory를 켜면 State Tracking이 28.6% → 43.9%, Multi-Evidence Integration이 22.3% → 32.6%로 올랐다. MemInStream이 memory의 효용에 민감하게 반응하는 benchmark임을 보여준다.
4. Conclusion & Impact (결론 및 시사점)
MemInStream은 visual understanding의 한계와 memory와 무관한 shortcut을 걸러내, streaming video memory를 더 신뢰성 있게 평가하도록 만든 benchmark다. 평가 결과 현재 streaming video 모델들은 시간적으로 떨어진 evidence를 통합하는 일(Multi-hop)과 dialogue 기반 context를 유지하는 일에서 특히 취약하다. 분석에서는 관련 evidence에 접근할 수 있는지가 정답률을 크게 좌우하지만, evidence를 갖고 있는 것만으로는 충분하지 않고 이를 식별하고 retrieve하는 능력이 함께 중요하다는 점이 드러났다.
이 연구는 "정답률 = memory 능력"이라는 암묵적 가정에 문제를 제기하고, benchmark 설계 단계에서 sufficiency와 necessity를 함께 검증해야 한다는 방법론적 기준을 제시한다. 이는 egocentric assistant 같은 장기 memory 기반 streaming agent 연구에서 평가 표준으로 활용될 수 있다. 저자들이 밝힌 한계는 현재 범위가 매우 긴 video stream을 충분히 다루지 못한다는 점이며, 향후 더 긴 영상과 더 큰 temporal separation으로 benchmark를 확장할 계획이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] A Simple Baseline for Streaming Video Understanding
- [논문리뷰] Execution Before Memory: Diagnosing Memory Failures in Video World Models
- [논문리뷰] VideoMemBench: How Well Do MLLMs Remember in Video Conversations?
- [논문리뷰] VideoZeroBench: Probing the Limits of Video MLLMs with Spatio-Temporal Evidence Verification
- [논문리뷰] OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
Review 의 다른글
- 이전글 [논문리뷰] MMFlash: Faster Speculative Decoding for Vision-Language Models
- 현재글 : [논문리뷰] MemInStream: Memorizing or Merely Recognizing? Rethinking Streaming Video Memory Evaluation
- 다음글 [논문리뷰] Mobile AI Factory: Building Specialized Language Models for Your Mobile Device
댓글