[논문리뷰] Agentic On-Policy Distillation Implicitly Reshapes LLMs' ReAct Patterns
링크: 논문 PDF로 바로 열기
저자: Deyang Kong, Zhaoyi Li, Sijian Ren, Yuan Wei, Ying Wei, Defu Lian, Shikun Zhang, Wei Ye
1. Key Terms & Definitions (핵심 용어 및 정의)
- OPD (On-Policy Distillation): Student가 직접 sample한 trajectory에 teacher가 token-level supervision을 제공하는 distillation 기법입니다. 본 논문에서는 student와 teacher 간 reverse KL을 sampled-token k1 approximation으로 추정하는 Policy-Gradient style OPD를 사용합니다. 이때 advantage는 log π_teacher − log π_student입니다.
- MOPD (Multi-Teacher OPD): 각 prompt를 해당 domain의 specialist teacher에게 routing하여 여러 domain의 능력을 하나의 student에 통합하는 OPD 확장 방식입니다.
- ReAct Interaction Patterns: Agent가 trajectory 안에서 Reasoning(답 도출), Acting(operation과 argument 선택), Observation acquisition(정보 요청 및 turn 양보)을 조직하는 방식입니다. 논문은 이 세 관점에서 OPD가 agent 행동을 어떻게 바꾸는지 분석합니다.
- Ask–call co-occurrence / Dependency-violation rate: Ask–call co-occurrence는 request-like text가 담긴 assistant output 중 tool call도 함께 생성한 비율입니다. Dependency-violation rate는 아직 받지 못한 user 정보나 authorization에 의존하는 call이 포함된 trajectory의 비율이며, LLM 기반 semantic review로 판정합니다.
- Signed-Δ Top-ρ Selection: Teacher의 domain-specific RL 전후 checkpoint로 각 token의 log-likelihood 차이 Δ_t = log(π_post/π_pre)를 계산합니다. 그런 다음 Δ 상위 ρ 비율의 token position에만 OPD loss를 적용하는 selective supervision 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문이 다루는 핵심 문제는 domain-specialized teacher로부터의 agentic OPD가 student의 ReAct pattern을 암묵적으로 바꾸고, 그 결과 다른 domain에 positive 또는 catastrophic negative transfer를 일으킨다는 점입니다. OPD와 MOPD는 LLM post-training pipeline의 표준 단계로 자리 잡았습니다. 그러나 기존 연구는 주로 target task accuracy, KL objective 설계, teacher–student mismatch 등에 집중했고, OPD가 multi-turn agent의 reasoning 경로, action 선택, 정보 획득 timing을 domain 간에 어떻게 바꾸는지는 체계적으로 분석하지 않았습니다.
실제로 ALFWorld-only OPD는 τ²-bench accuracy를 41.5% → 6.6%로 급락시켰습니다. 반면 Code-Interpreter(CI) OPD는 ALFWorld와 τ² 모두에서 성능을 높였습니다 [Figure 2]. 즉 cross-domain 효과는 source–target pair마다 방향이 다릅니다.
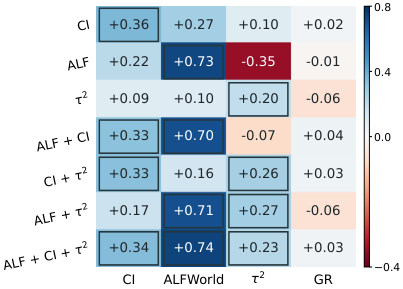
Figure 2 — Cross-domain 성능 변화
Task-matched teacher를 추가하는 MOPD는 해당 domain의 문제를 완화하지만, 학습 source에 없는 unseen domain까지는 보호하지 못합니다. 예를 들어 ALF+CI 조합에서도 τ² 성능은 하락했고 ask–call co-occurrence는 25.6%에 머물렀습니다. 모든 agentic task를 teacher로 열거할 수는 없으므로, source-domain trajectory만으로 negative transfer를 줄이는 원리적인 방법이 필요하다는 것이 저자들의 문제의식입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 OPD가 student에게 두 종류의 지식을 전달한다고 봅니다. 하나는 generic agentic abilities이고, 다른 하나는 task-specific ReAct patterns입니다. 그리고 후자에 대한 overfitting이 negative transfer의 주원인이라고 진단합니다.
실험 설정
- Student: Qwen3-4B-Instruct-2507
- Teacher: Qwen3-4B / Qwen3-30B-A3B-Instruct-2507에 domain-specific RL을 적용한 모델
- Domain: GR(tool 없는 수학), CI(Python interpreter 수학), ALFWorld, τ²-bench(airline/retail/telecom)
- Evaluation: AIME2026, BeyondAIME, ALFWorld, τ²-bench
Observation 1 (Reasoning route shift)
- GR-OPD는 CI 수학에서 tool attempt rate를 70.4% → 14.4%로 줄이면서 accuracy를 16.7% → 38.0%로 높였습니다.
- Tool 없이 맞힌 비율은 2.4% → 30.1%로 늘었고, loop-like code를 포함한 trajectory는 304 → 97로 줄었습니다.
- 반대로 CI-OPD는 73.0%의 tool attempt rate를 유지하며 52.4% accuracy를 달성했습니다.
Observation 2 (Action/Observation shift)
- CI-OPD는 ALFWorld accuracy를 12.9% → 40.2%로 높였고, adjacent action 반복은 4.5% → 0.7%로 줄었습니다.
- 같은 CI-OPD는 τ² accuracy를 41.5% → 51.0%로 높였으며, retail은 48.1% → 65.3%로 개선되었습니다.
- 반면 ALF-OPD student는 ask–call co-occurrence가 94.3%, dependency violation이 55.8%(Base 0.50%)에 달했습니다. User ID를 요청하자마자 답을 기다리지 않고 schema 예시 ID로 tool을 호출하는 식입니다.
- τ² teacher를 추가한 ALF+τ² MOPD는 τ² accuracy를 68.9%로 회복했습니다.
Mitigation: Selective OPD
- Student rollout의 각 token에 대해 teacher의 RL 전후 checkpoint로 signed Δ를 계산합니다. 이후 rollout 내에서 Δ 상위 ρ% position에만 OPD loss를 적용하고, 선택된 token 수 K로 normalize합니다 [Figure 12].
- 결과 (ALFWorld trajectory만 사용):
- 10%만 retain해도 ALF accuracy가 14.3% → 69.4%로 올랐습니다.
- 95%까지 늘리면 ALF는 76.6%까지 오르고 τ²는 안정적으로 유지되었습니다.
- 마지막 low-Δ 5%를 포함하면 τ²가 29.9% → 11.5%로 급락하고 ask–call은 24.3% → 97.1%로 급등했습니다.
- Random 95% 대조군은 τ² 성능 저하를 막지 못했습니다.
- 제외된 token 분석:
- Tool-call onset(
<tool_call>)의 제외율은 19.13%로, 전체 평균 대비 3.84× 높았습니다. - Tool-call payload는 제외율이 0.32%에 불과했습니다.
- Tool-call onset(
- 대안 기법 비교 (모두 Signed-Δ Top95보다 τ² accuracy가 낮음):
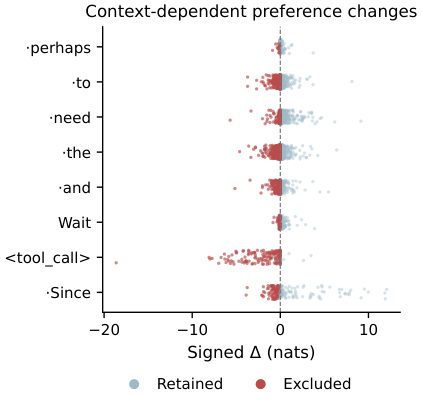
Figure 12 — Token별 signed Δ 분포
| 기법 | τ² accuracy | 비고 |
|---|---|---|
| Signed-Δ Top95 (제안) | 29.88% | ask–call 24.26% |
| Advantage Top95 | 23.50% | ask–call 82.68% |
| Absolute-Δ Top95 | 17.13% | |
| Delimiter masking | 4.88% | |
| Negative masking | 3.63% |
- GR→CI 확장: GR accuracy를 비슷하게 유지(46.02% vs 46.33%)하면서 CI tool attempt를 10.41% → 29.49%로 보존했습니다. 다만 CI accuracy 자체는 37.65% → 36.53%로 소폭 낮아졌습니다.
4. Conclusion & Impact (결론 및 시사점)
결론
- Agentic OPD는 domain을 넘나들며 LLM agent의 reasoning, acting, observation acquisition 방식을 바꾸고, 그 결과 positive와 negative transfer가 함께 나타납니다.
- Task-matched MOPD는 ALF supervision이 τ²에서 일으키는 conversational failure를 완화합니다.
- Source-only 설정에서는 RL 전후 teacher의 preference 변화(signed Δ)로 low-Δ tail을 제외하면 negative transfer를 크게 줄일 수 있습니다. 대신 source-domain 성능 일부를 희생하는 trade-off가 있습니다.
시사점
- MOPD 기반 post-training(multi-domain agent 통합)에서 accuracy만 보면 안 되고, interaction behavior(tool 사용 경로, turn-taking, dependency 준수)를 함께 평가해야 한다는 근거를 제시합니다.
- Teacher의 RL 전후 checkpoint를 활용한 token-level supervision selection은 transferable한 agentic 능력과 surface-level task habit을 분리하려는 새로운 방향입니다.
- 다만 이 방법이 항상 aggregate accuracy를 높이지는 않습니다(GR→CI 사례). 보다 원리적인 cross-domain 보존 기법은 후속 과제로 남습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Every Coin Has Two Sides: On the Dual Nature of Generalization in On-Policy Distillation of Large Language Models
- [논문리뷰] On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
- [논문리뷰] Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
- [논문리뷰] MOPD-Router: Rethinking Teacher Routing in Multi-Teacher On-Policy Distillation
- [논문리뷰] Beyond Teacher Assignment: Domain-Normalized Multi-Teacher On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] Zuse: A Decision Model for European Languages
- 현재글 : [논문리뷰] Agentic On-Policy Distillation Implicitly Reshapes LLMs' ReAct Patterns
- 다음글 [논문리뷰] AscendGYM: A Cost-Aware Kernel Optimization Benchmark for Real-World Workloads on Ascend NPUs
댓글