[논문리뷰] FastFrames: Video Generation at Interactive Latency
링크: 논문 PDF로 바로 열기
저자: Gene Chou, Guandao Yang, Fujun Luan, et al. (Apple, Cornell University)
1. Key Terms & Definitions (핵심 용어 및 정의)
- End-to-End Per-Frame Latency: 새 입력 신호(예: steering command)가 들어온 시점부터 그 효과를 보여주는 첫 RGB frame이 표시될 때까지의 지연 시간입니다. KV cache update, diffusion sampling, pixel rendering의 critical path 전체를 포함합니다. 목표치는 ≤50 ms입니다.
- RPS (Responses Per Second): RPS = 1,000 / Latency(ms)로 정의되는 지표입니다. FPS는 한 batch에서 만든 여러 frame에 생성 시간을 나눠 계산합니다. 반면 RPS는 생성 단위 하나를 response 하나로 세기 때문에 interactive 반응성을 직접 측정합니다. 50 ms는 20 RPS에 해당합니다.
- Pixel Decoder (ConvNeXt head): VAE decoder를 대체하는 경량 readout입니다. 3개의 causal 3D ConvNeXt-style block이 DiT의 저해상도 token grid(21×30×52)에서만 연산합니다. 이후 linear layer 하나가 각 token을 4×16×16 RGB patch로 변환합니다.
- KV Refinement Network: 기존 baseline은 denoising이 끝난 latent로 DiT를 한 번 더 실행해 KV cache를 갱신합니다. 이 network는 그 추가 DiT pass를 대체합니다. 공유 feature extractor(경량 transformer block 4개)와 layer별 KV-repair head가 noisy KV에 대한 residual correction을 예측합니다.
- CF++ (Causal Forcing++): 논문이 profiling한 가장 빠른 few-step AR video diffusion baseline입니다. Wan 2.1 1.3B backbone을 사용하며, FastFrames-S의 초기화 checkpoint이기도 합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 기존 autoregressive(AR) video diffusion model들이 FPS 기준으로는 "real-time"이라고 주장하지만, 실제 input-to-response latency는 interactive 수준(약 50~60 ms의 지연 인지 threshold)에 크게 못 미친다는 문제를 다룹니다. 가장 빠른 baseline인 **CF++**도 480p에서 frame 하나를 만드는 데 271.8 ms가 걸립니다. 이 가운데 diffusion sampling은 약 30%에 불과합니다 [Figure 2].
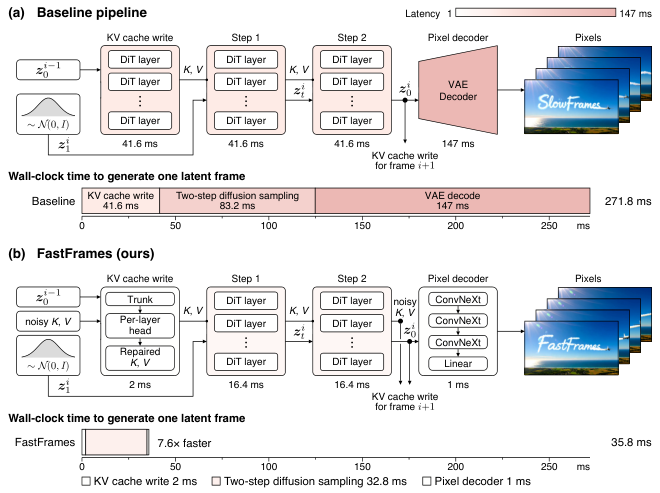
Figure 2 — 추론 파이프라인 및 latency
병목은 흔히 고정된 implementation detail로 취급되던 "accessory" 연산에 있습니다.
- VAE decoder: 하나만으로 147 ms가 걸려 DiT pass 약 3.5회에 해당하며, 그 자체로 50 ms 예산을 약 3배 초과합니다.
- KV cache 갱신: 매 생성마다 DiT evaluation을 한 번 더 실행합니다.
기존 경량 VAE 연구(TAESD, TAEHV 등)는 최대 약 4× speedup을 얻는 대신 visual quality가 저하됩니다. Batching이나 pipeline parallelism은 throughput은 높이지만 per-frame latency는 개선하지 못합니다. 따라서 denoising 자체가 아니라 inference pipeline 전체의 critical path를 재설계하는 접근이 필요합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
FastFrames는 non-denoising 구성요소를 경량 대안으로 바꾸고 hardware-aware system 최적화를 더해, 품질을 유지하면서 처음으로 ≤50 ms latency를 달성했습니다 [Figure 2].
1) VAE decoder 제거
- 처음에는 linear layer 하나로 VAE를 대체해 봤습니다. 결과물은 흐릿했지만 장면을 알아볼 수는 있었고, 이는 비싼 decoder가 꼭 필요하지 않다는 근거가 되었습니다.
- 최종 ConvNeXt pixel decoder의 parameter 수는 63.9M으로 VAE의 73.3M과 비슷하지만, 속도는 1 ms vs. 147 ms로 약 147배 빠릅니다. 머리카락이나 빗방울 같은 thin structure도 재현합니다 [Figure 3].
- 학습 시 peak memory가 약 68 GB에서 5 GB로 줄어 pixel-space adversarial training이 실용적이 되었습니다. Loss 구성은 다음과 같습니다.
- Reconstruction loss: L1, MSE, gradient, temporal, motion-weighted 항
- Adversarial loss: frozen DINOv3 ViT-S/16 기반 spatial/temporal discriminator head 6개와 relativistic softplus objective
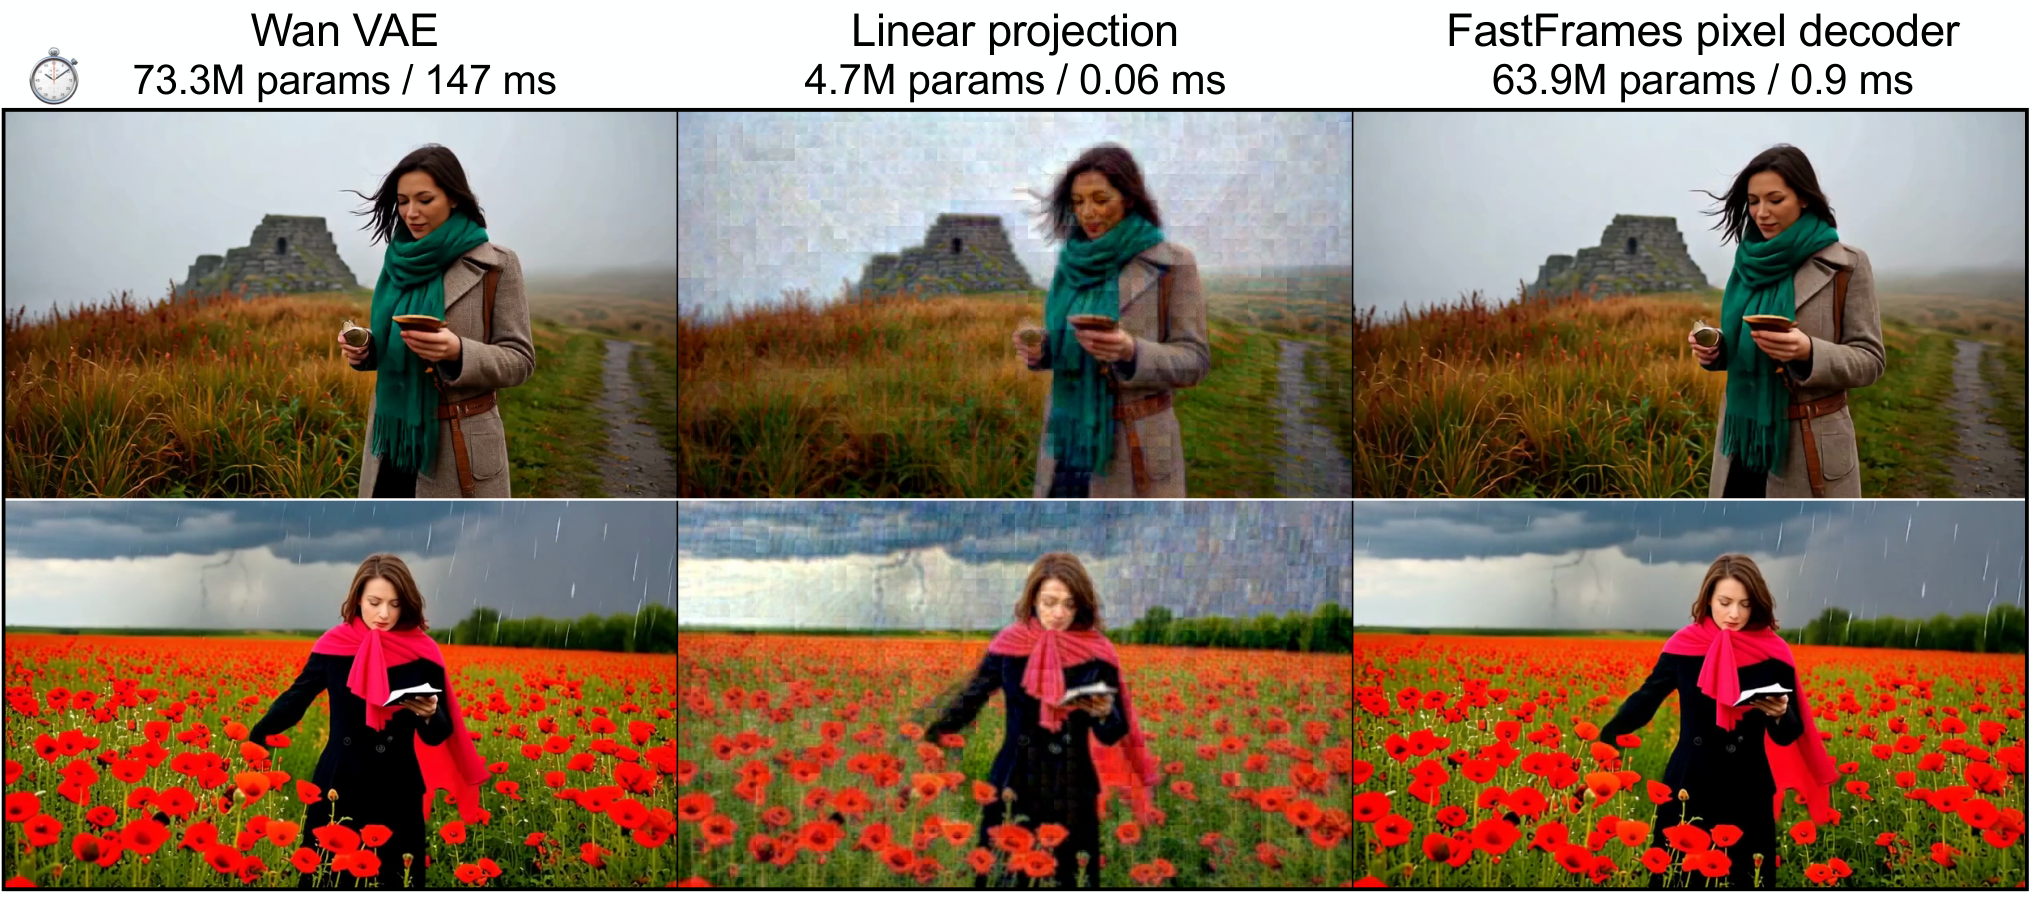
Figure 3 — Pixel decoder 비교
2) KV cache 갱신 가속
- KV Refinement Network는 원래 DiT refinement pass의 KV를 target으로 학습합니다. Loss는 cosine distance, relative ℓ2, attention-output loss를 사용합니다.
- 소요 시간은 1.3B 기준 약 2 ms(약 20× 빠름), 14B 기준 약 6 ms(약 12× 빠름)이며, 품질은 원래 refinement pass와 비슷합니다.
3) Systems-level 최적화
- Persistent KV buffer, RoPE·condition precompute, QKV fusion을 적용했습니다.
- KV sequence를 segment로 나눠 병렬 처리하고 softmax merge로 합쳤습니다. 5개 segment로 나누면 latency가 13% 줄었습니다.
- CUDA graphs로 GPU 작업 launch 오버헤드를 줄였습니다.
- 이를 통해 DiT evaluation 시간이 1.3B에서 41.6 ms → 16.4 ms, 14B에서 89.2 ms → 75.6 ms로 줄었습니다.
- 8× B200에서는 Context Parallelism (CP)와 NVLink symmetric-memory gather를 사용해 1.3B는 5.8 ms, 14B는 20.3 ms까지 낮췄습니다.
핵심 결과 (VBench, B200 GPU, 480p)
| Model | 환경 | Latency | RPS | VBench Total |
|---|---|---|---|---|
| FastFrames-S (1.3B) | B200 1장 | 36 ms | 27.8 | 84.23 |
| CF++ (1.3B) | B200 1장 | 272 ms | 3.68 | 84.11 |
| FastFrames-S (1.3B) | 8 GPU | 14 ms | 71.4 | 84.23 |
| FastFrames-L (14B) | 8 GPU | 45 ms | 22.2 | 84.44 |
| Krea-Realtime (14B) | B200 1장 | 1,675 ms | 명시되지 않음 | 84.42 |
- FastFrames-S는 CF++와 같은 DiT weights를 쓰면서 약 7.6× 빠르고 VBench Total도 약간 높습니다. Quality score는 85.30 vs. 85.09로 앞서고, Semantic score는 79.92 vs. 80.20으로 소폭 낮습니다. 저자들은 품질 향상의 원인을 pixel-space adversarial training으로 봅니다.
- FastFrames-L은 Krea-Realtime과 비슷한 품질이면서 10배 이상 빠릅니다.
Interactive application [Figure 5]
- LingBot 1.3B (camera-conditioned): 842 ms(공식 최속 설정) → 52 ms, 16× 가속
- RealWonder 1.3B (physics-conditioned): 1,141 ms → 51 ms, 22× 가속
- LingBot 14B: 1,373 ms → 233 ms, 5.9× 가속
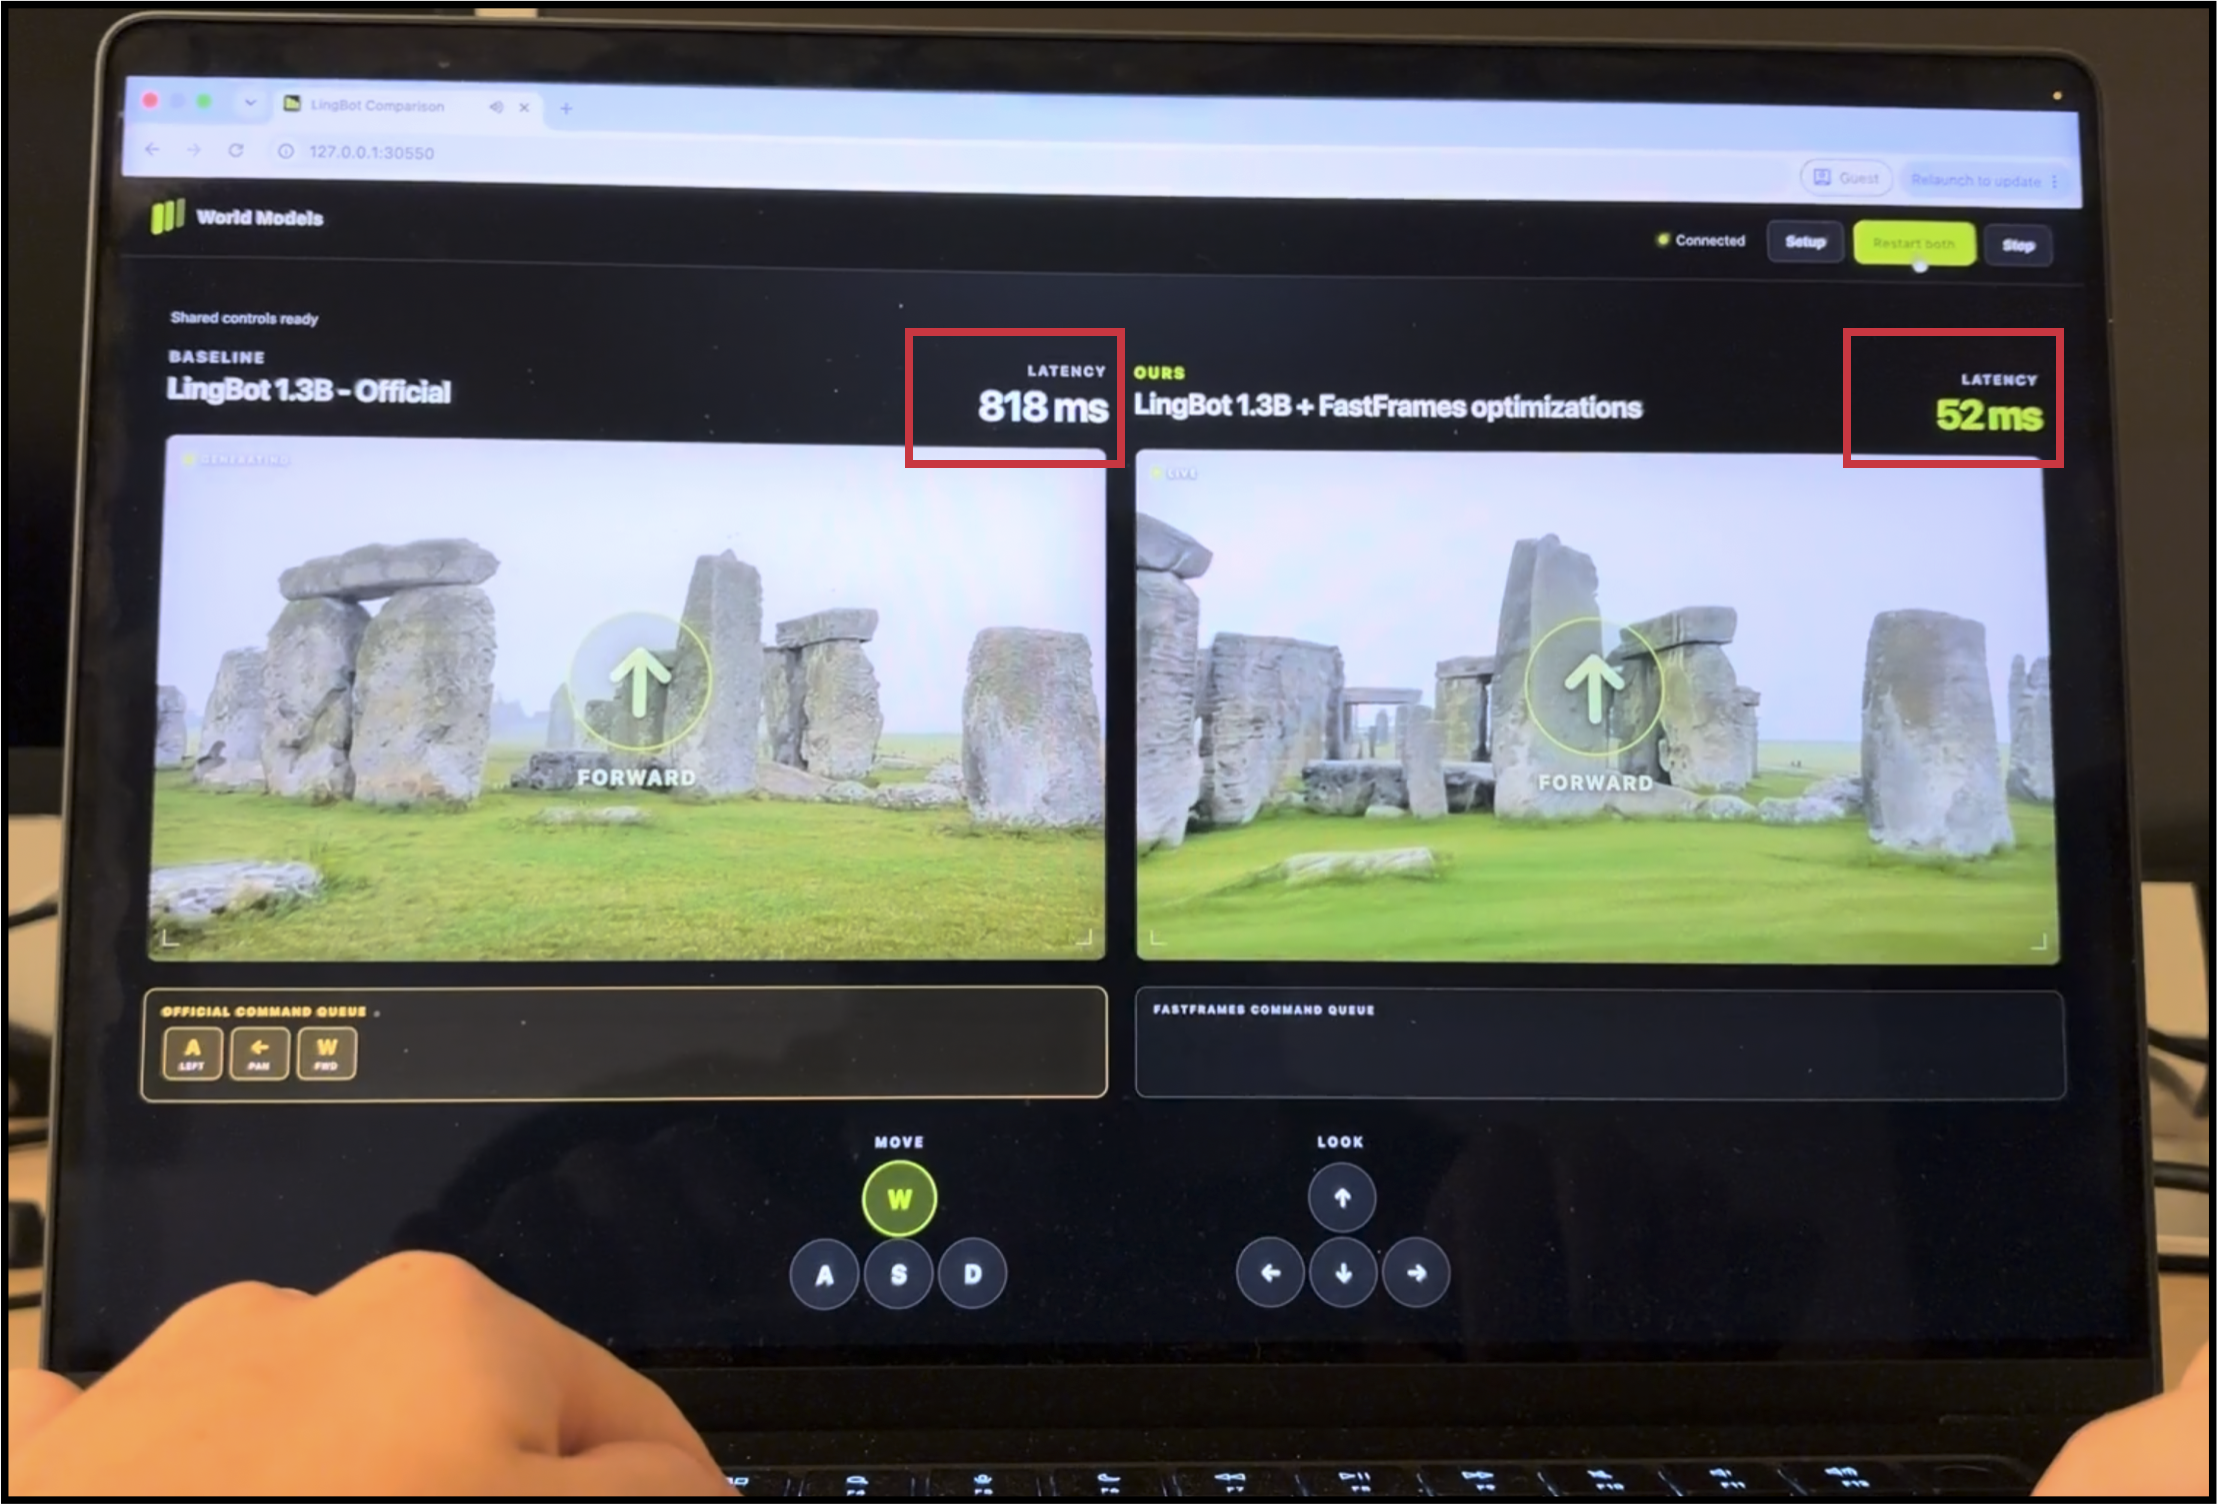
Figure 5 — Interactive 응용 결과
4. Conclusion & Impact (결론 및 시사점)
FastFrames는 VAE decoding과 KV cache 갱신처럼 "고정된 구성요소"로 여겨지던 연산을 경량 대안으로 바꿨습니다. 그 결과 1.3B와 14B 모두 baseline과 같거나 더 나은 품질을 유지하면서 interactive latency(≤50 ms)를 달성했습니다. 핵심 메시지는 few-step 시대에는 더 이상 iterative denoising이 병목이 아니라는 점입니다. Pixel decoding은 범용 reconstruction 문제가 아니라 특정 DiT에 맞춘 lightweight readout으로 다룰 수 있습니다.
산업적 시사점
- 이 기법들은 많은 AR video diffusion model이 공유하는 구성요소를 겨냥합니다. 그래서 hybrid attention이나 개선된 distillation 같은 backbone 측 발전과 함께 쓸 수 있습니다.
- LingBot, RealWonder 같은 off-the-shelf 모델에도 바로 적용되어, world simulation, game, robotics 예측 모델 등 실시간 interactive application의 실용성을 크게 높입니다.
한계
- Pixel decoder는 모델마다 따로 finetuning해야 합니다.
- 평가는 480p와 high-end GPU(B200) 환경에 한정되어 있습니다.
- 향후 과제로는 latency를 늘리지 않는 action conditioning, 고해상도 확장, 경량 hardware 지원, long-term consistency 개선이 제시되었습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Causal Forcing++: Scalable Few-Step Autoregressive Diffusion Distillation for Real-Time Interactive Video Generation
- [논문리뷰] Speculative Sampling in Interactive Video Generation
- [논문리뷰] Wan-Streamer v0.2: Higher Resolution, Same Latency
- [논문리뷰] Motion-Aware Caching for Efficient Autoregressive Video Generation
- [논문리뷰] ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU
Review 의 다른글
- 이전글 [논문리뷰] FMT: Lossless Image Compression in a Fixed Number of Parallel Steps
- 현재글 : [논문리뷰] FastFrames: Video Generation at Interactive Latency
- 다음글 [논문리뷰] ForceHarness: Turning Force into Action and Physics for Frozen Frontier Models
댓글