[논문리뷰] Don't Drop Dropout: Optimizing Layer Sparsity for Efficient LLM Training and Inference
링크: 논문 PDF로 바로 열기
The paper "Don't Drop Dropout: Optimizing Layer Sparsity for Efficient LLM Training and Inference" investigates the re-introduction and optimization of layer dropout for efficient Large Language Model (LLM) training and inference.
저자: Mostafa Elhoushi, Alex Pretko, Nolan Dey, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Layer Dropout (Stochastic Depth): Transformer 모델의 pre-training 과정에서 전체 layer (transformer block)를 확률적으로 건너뛰는 regularization 기법입니다. 이는 activation dropout과 달리 wall-clock speedup을 제공할 수 있는 structured sparsity를 유도합니다.
- Structured Sparsity: 모델 가중치나 activations에서 미리 정의된 구조(예: 전체 layer 또는 block)를 제거하여 얻는 sparsity입니다. 이는 fine-grained sparsity와 달리 하드웨어 효율성 이점을 가질 수 있습니다.
- FLOPs (Floating Point Operations): 모델 학습 및 추론에 필요한 연산량을 측정하는 지표입니다. 본 논문에서는 특히 non-embedding FLOPs를 지칭합니다.
- Early Exit: Inference 시점에서 모델의 최종 layer까지 모든 연산을 수행하지 않고, 특정 중간 layer에서 출력을 생성하여 연산량을 줄이는 기법입니다.
- Self-Speculative Decoding: LLM inference 속도를 가속화하기 위해, 전체 모델의 subset (draft model)을 사용하여 다음 token들을 예측하고, 더 큰 target model이 이를 병렬로 검증하는 lossless decoding 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM pre-training에 막대한 computational resource가 소요되며, time-to-accuracy 개선이 수백만 달러의 비용 절감과 탄소 배출량 감소로 이어질 수 있다는 문제의식에서 출발합니다. 과거 convolutional network 및 초기 transformer 모델에서 널리 사용되던 Dropout 기법은 LLM이 수십억 개의 parameter와 수조 개의 token으로 확장되면서 대부분 채택되지 않았습니다. 기존 연구에서는 대규모 dataset에 대해 단일 epoch으로 학습하는 경우 Activation Dropout이 성능을 저하시킬 수 있다고 보고되었기 때문입니다.
특히, Layer Dropout (Stochastic Depth)은 regularization 외에도 inference 시점에서 depth-wise optimization (예: early exit, intermediate layer skipping)에 대한 robustness를 부여할 수 있다는 잠재력을 가지고 있음에도 불구하고, 현대 LLM pre-training에서 그 역할이 체계적으로 확립되지 못했습니다. 기존 연구 결과는 모델 종류, dataset 크기, 구현 방식에 따라 파편화되어 있었고, 보고된 성능 저하가 최적화되지 않은 schedule이나 hyperparameter 때문일 수 있다는 의문이 제기되었습니다. 따라서 저자들은 Layer Dropout이 최신 대규모 LLM 학습에 사용되어야 하는지, 그리고 accuracy를 유지하면서 training 및 deployment 이점을 제공하기 위해 어떻게 구성되어야 하는지에 대한 근본적인 질문을 해결하고자 합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Layer Dropout의 효과를 체계적으로 평가하기 위해 2,400개 이상의 training experiment를 수행하여 최적의 hyperparameter, depth-wise distribution, temporal dropout schedule을 탐색했습니다. 저자들은 Layer Dropout 적용 시 rtrain=1/ρ (ρ는 layer density) 스케일링 팩터를 사용하는 것이 안정적인 hyperparameter transfer에 critical함을 입증했습니다 [Figure 2, Figure 3]. 또한, Layer Dropout이 sub-layer dropout보다 더 높은 accuracy를 제공하며 (Table 1), per-sequence dropout이 per-batch dropout보다 낮은 loss를 달성한다는 것을 발견했습니다 [Figure 4].
핵심 결과로, 저자들은 Increasing Linear Distribution (ILD) across layers와 Decreasing Time Schedule (DTS) over training steps를 결합한 Layer Dropout 구성을 제안합니다. 이 조합은 동일한 training FLOPs budget에서 validation loss를 dense baseline보다 낮거나 유사하게 유지하면서, 일부 경우에서는 오히려 능가하는 성능을 보였습니다 [Table 3]. 특히, 503M 및 906M 모델에서 5% FLOPs savings 조건에서 ILD+DTS 조합이 dense baseline보다 낮은 validation loss를 달성하여 더 적은 FLOPs로 더 나은 성능을 낼 수 있음을 최초로 시사했습니다 [cite: 1, Table 3].
이러한 Layer Dropout 적용은 inference 효율성에도 크게 기여합니다. Layer Dropout으로 pre-training된 모델은 Zero-Shot Early Exit 시에 dense baseline보다 항상 더 낮은 loss를 보였으며 [Figure 5], Layer Skipping 시에도 graceful degradation을 통해 작은 모델의 성능 수준으로 유연하게 적응할 수 있는 inherent elasticity를 가졌습니다 [Figure 6]. Post-training Early Exit Adapter를 사용한 실험에서도 Layer Dropout으로 pre-training된 모델이 dense baseline보다 일관되게 우수한 성능을 나타냈습니다 [Figure 7]. 또한, Self-Speculative Decoding 시에는 최대 1.55배의 inference speedup을 달성했으며, 이는 dense baseline에서는 달성하기 어려운 결과였습니다 [cite: 1, Table 4, Table 5]. 이러한 이점들은 271M부터 8.2B parameter에 이르는 다양한 모델 크기와 최대 160B token 데이터셋에 걸쳐 일관되게 나타나, 대규모 학습 환경에서도 Layer Dropout의 유용성을 입증합니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Layer Dropout이 현대 대규모 LLM pre-training 환경에서 유효한 기술일 뿐만 아니라, 아키텍처적 유연성을 위한 강력한 메커니즘임을 입증합니다. 저자들이 제안한 increasing distribution across layers와 decreasing schedule over time 조합은 training FLOPs를 크게 줄이면서도 dense baseline과 동등하거나 우수한 accuracy를 달성하며, zero-shot inference elasticity 및 speedup을 가능하게 합니다. 이러한 접근 방식은 기존 LLM pre-training stack에 비침습적으로 쉽게 통합될 수 있습니다.
이 연구는 1.8B, 3.9B, 8.2B 모델에 대한 대규모 실험(Hero Runs)을 통해 모델 크기가 커질수록 Aggressive Dropout Rate에 대한 내재적 resilience가 증가하며, 최대 25%의 cumulative training FLOPs 절감과 최대 1.55배의 inference speedup을 달성할 수 있음을 보여주었습니다 [cite: 1, Table 5]. 이는 이산적인 모델 크기 간의 성능 격차를 해소하고, 표준 dense 모델에서는 실패할 수 있는 self-speculative decoding과 같은 고효율 배포 전략을 가능하게 합니다. 궁극적으로 본 연구는 effective capacity를 학습 과정 전반에 걸쳐 점진적으로 증가시키는 model growing 전략이 우수한 결과를 가져온다는 통찰을 제공하며, Layer Dropout이 효율적인 대규모 pre-training의 핵심 요소로 재도입될 수 있음을 시사합니다.
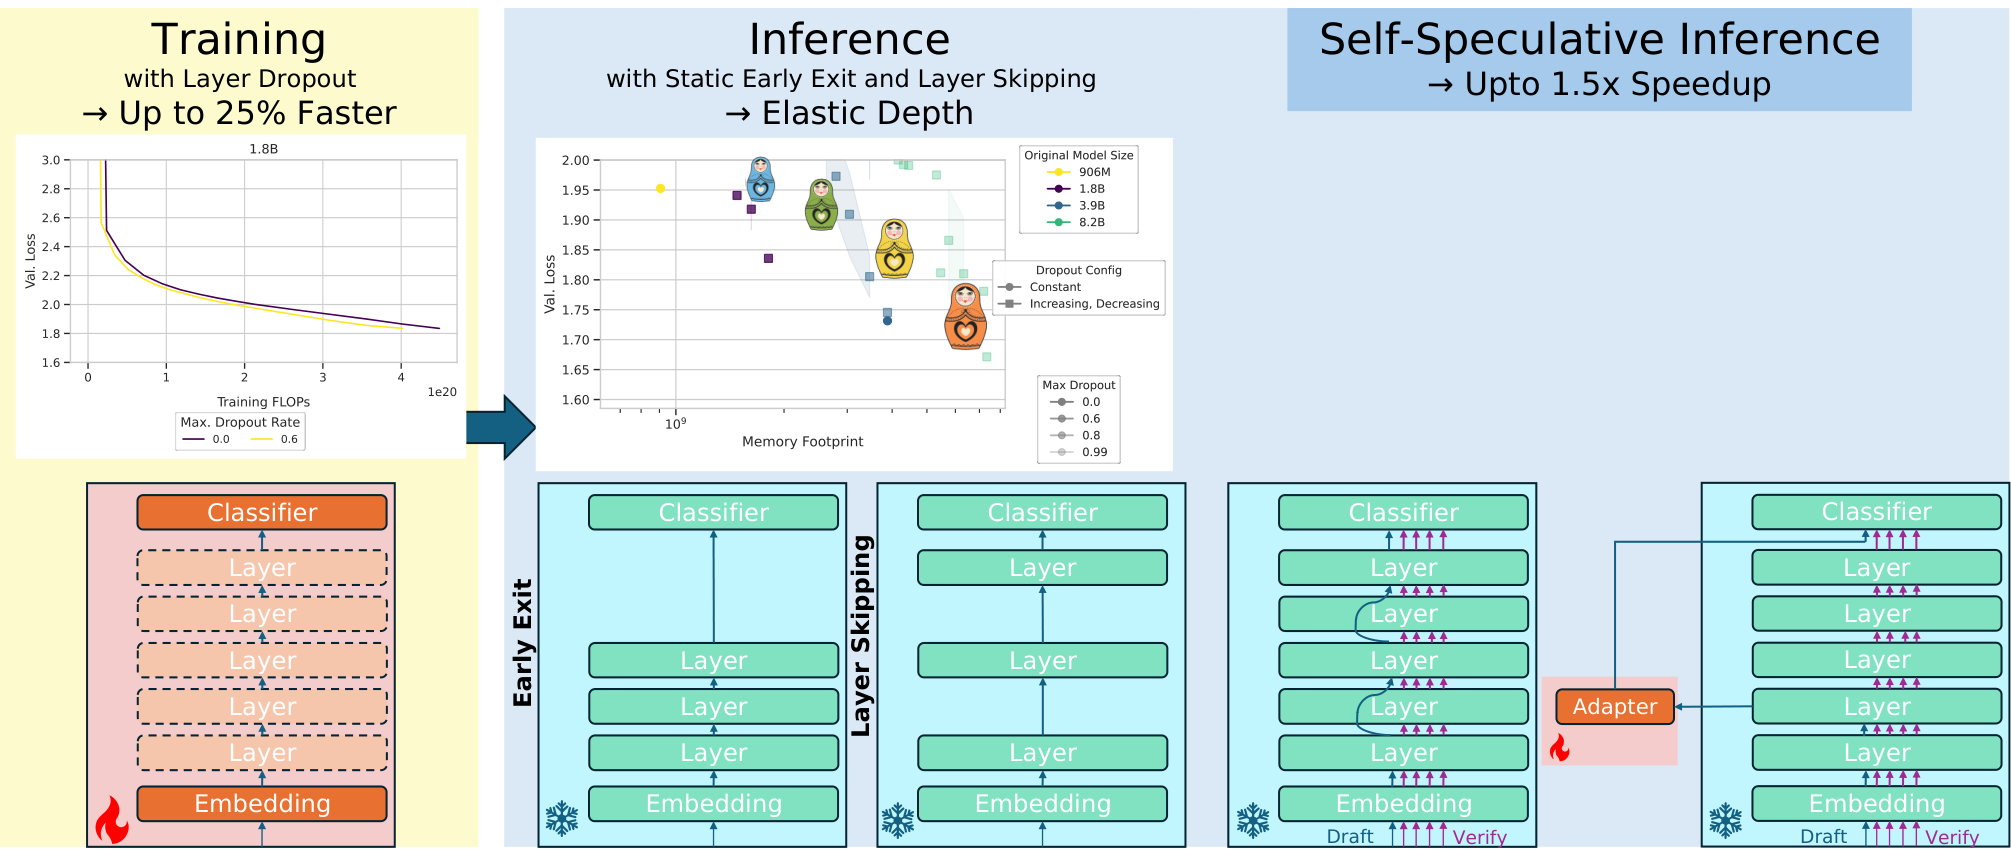
Figure 1 — 효율적인 LLM 학습 및 추론을 위한 Layer Dropout
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] The Handoff Tax: Continuing Non-Native Trajectories in LLM Agents
- [논문리뷰] An AI4AI Framework for Visual Token Pruning
- [논문리뷰] BlockPilot: Instance-Adaptive Policy Learning for Diffusion-based Speculative Decoding
- [논문리뷰] EfficientRollout: System-Aware Self-Speculative Decoding for RL Rollouts
- [논문리뷰] Retrospective Harness Optimization: Improving LLM Agents via Self-Preference over Trajectory Rollouts
Review 의 다른글
- 이전글 [논문리뷰] Bilevel Coordinated Reflection: A Game-Theoretic Approach to Multi-Agent LLM Systems
- 현재글 : [논문리뷰] Don't Drop Dropout: Optimizing Layer Sparsity for Efficient LLM Training and Inference
- 다음글 [논문리뷰] Dr. Claw: An AI Scientist Workspace for Vibe Research
댓글