[논문리뷰] Mask Forcing: Improving Autoregressive Video Diffusion Distillation via Dual-Noise Masking Rollout
링크: 논문 PDF로 바로 열기
저자: Zhuoran Zhao, Shengju Qian, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Autoregressive (AR) Video Diffusion Models: 실시간 비디오 생성을 가능하게 하기 위해 이전 생성된 비디오 청크에 조건화하여 다음 청크를 순차적으로 생성하는 모델입니다.
- Distribution Matching Distillation (DMD): 사전 학습된 다단계(multi-step) 교사(teacher) 확산 모델의 지식을 소수 단계(few-step) 학생(student) 모델로 증류(distill)하는 데 사용되는 방법론으로, 주로 역방향 KL(reverse KL) divergence를 최소화합니다.
- Mode Collapse: 생성 모델에서 모델이 실제 데이터 분포의 일부 모드(modes)만을 학습하여 생성되는 샘플의 다양성과 품질이 저하되는 현상입니다.
- Dual-Noise Masking Rollout: 제안된 전략으로, 공간적(spatial) 및 시간적(temporal) 축을 따라 무작위 마스크(random masks)를 통해 노이즈가 있는 롤아웃(rollout) 입력에 더 깨끗한(lower-noise) 신호를 주입하는 기법입니다.
- Self-Rollout: 훈련 시 모델이 이전에 스스로 생성한 프레임을 기반으로 다음 프레임을 생성하여 학습과 추론 간의 격차(train-test gap)를 해소하는 훈련 패러다임입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 Autoregressive (AR) video diffusion models이 실시간 비디오 생성에서 큰 잠재력을 보이지만, 생성된 비디오가 과도한 채도(over-saturation) 및 과도한 스무딩(over-smoothing) 문제로 인해 시각적 품질(visual quality)과 사실성(realism)이 제한되는 문제점을 해결하고자 합니다. 이러한 현상은 주로 DMD (Distribution Matching Distillation)의 reverse KL objective가 mode-seeking behavior를 보여 학생 분포가 교사 분포의 소수 모드에만 집중하게 되는 mode collapse를 유발하기 때문입니다. 또한, 중간 self-rollout 예측은 각 단계에서 명시적인 훈련 신호를 받지 못하여 error accumulation이 발생합니다. 기존 연구들은 real video data를 포함하거나 추가적인 post-training 단계를 도입하여 이러한 문제를 완화하려 했으나, 이는 복잡한 데이터 큐레이션(data-curation) 또는 다단계 훈련 파이프라인(multi-stage training pipeline)을 야기합니다. 따라서 저자들은 real video data 또는 추가 post-training 없이 AR video diffusion distillation의 성능을 향상시키는 방법을 모색했습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Mask Forcing이라는 Dual-Noise Masking Rollout 전략을 제안하여 AR video diffusion distillation에서 reverse KL objective에 의해 유도되는 mode collapse를 완화합니다. 이 방법의 핵심은 AR student self-rollout 과정 중에 공간적 및 시간적 축을 따라 무작위 마스크를 통해 노이즈가 있는 롤아웃 입력에 더 깨끗한 신호(cleaner signals)를 주입하는 것입니다. 이러한 섭동(perturbations)은 학생 롤아웃이 교사 분포의 더 많은 영역을 탐색하도록 유도하여, DMD가 학생이 이미 커버하는 모드를 넘어선 학습 신호를 제공하게 합니다. 또한, 더 깨끗한 토큰(cleaner tokens)은 노이즈가 더 많은 토큰(noisier tokens)에 대한 denoising guidance 역할을 하여 중간 롤아웃 예측(intermediate rollout predictions)을 개선하고 error accumulation을 줄입니다.
제안된 방법론은 다양한 AR 비디오 확산 증류 방법에 대해 광범위한 실험을 통해 효과를 입증했습니다. 정량적 평가에서 Mask Forcing은 Self Forcing, Causal Forcing, LongLive와 같은 baseline methods의 visual quality를 일관되게 향상시켰습니다. 예를 들어, chunk-wise 설정의 Self Forcing에서 HPSv3는 9.55에서 9.84로, VisionReward는 10.10에서 11.37로 개선되었습니다. 또한 Instruct. 및 MQ 점수도 크게 향상되었습니다. VBench 벤치마크에서도 모든 baseline methods를 Total Score, Quality Score, Semantic Score에서 능가했습니다. 특히, LongLive baseline과의 30초 long video generation 실험에서 HPSv3는 +0.67, Vision.은 +0.62 향상되었습니다. Ablation studies 결과, mask ratio 0.2와 timestep window Δ=250가 HPSv3와 Dynamic Degree 간의 최적의 균형을 제공함을 확인했습니다. 마지막으로, Mask Forcing은 HPSv3와 CMMD, VMMD 측면에서 모든 baseline의 convergence speed를 가속화했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 AR video diffusion distillation에서 mode-seeking reverse KL objective에 의해 발생하는 mode collapse를 완화하는 Mask Forcing이라는 Dual-Noise Masking Rollout 전략을 제시합니다. 이 방법은 공간적 및 시간적 축을 따라 무작위 마스크를 통해 노이즈가 있는 롤아웃 입력에 더 낮은 노이즈 신호(lower-noise signals)를 주입합니다. 이러한 섭동은 self-rollout 중 더 광범위한 탐색을 촉진하여 학생 분포가 교사 분포의 더 많은 영역을 커버하도록 유도하고, DMD가 이미 커버된 모드를 넘어선 학습 신호를 제공하게 합니다. 동시에, 더 깨끗한 토큰은 노이즈가 있는 토큰에 대한 denoising guidance 역할을 하여 중간 롤아웃 예측을 개선하고 self-rollout 과정 중 error accumulation을 완화합니다. 광범위한 실험은 여러 baseline에 걸쳐 제안된 방법의 효과성을 입증했으며, visual quality 및 convergence speed가 향상되었습니다. 이 연구는 real video data 또는 post-training 단계를 포함하지 않고도 AR video diffusion distillation을 개선하는 간단하고 효과적인 전략을 제공함으로써 해당 분야의 훈련 파이프라인을 단순화하고 효율성을 높이는 데 중요한 시사점을 줍니다.
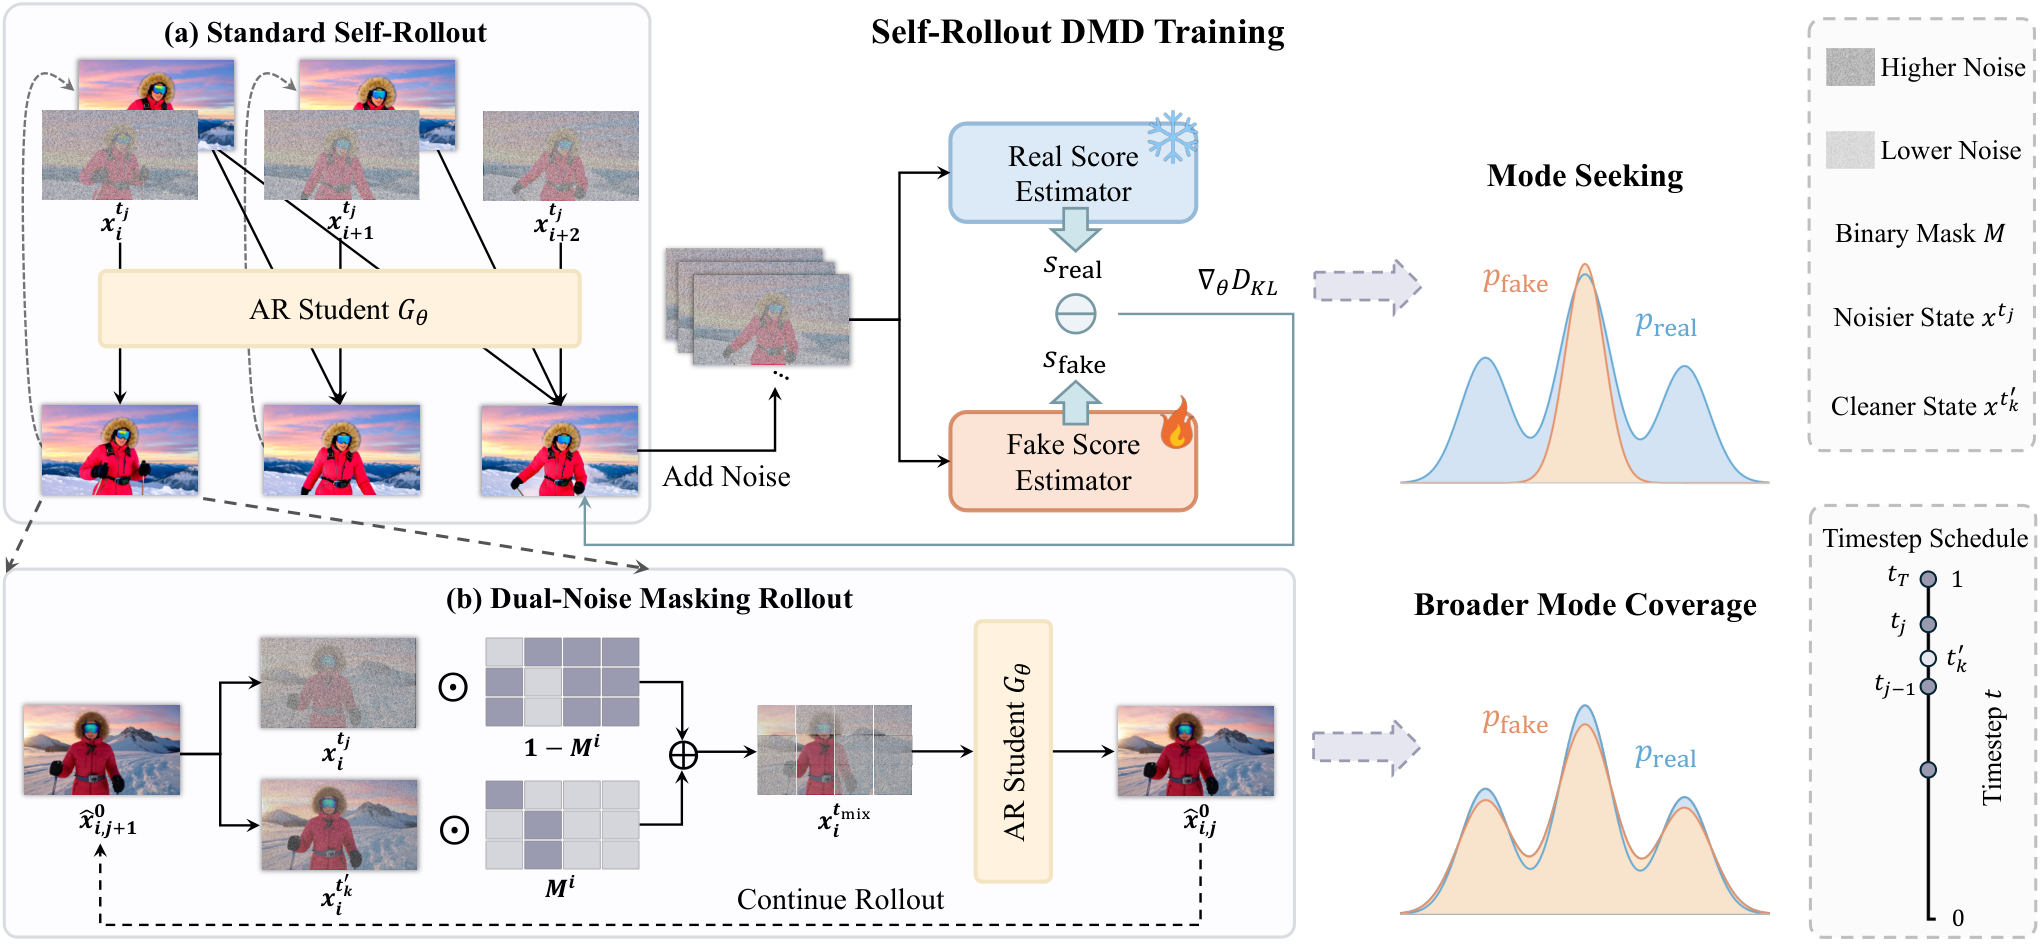
Figure 2 — 제안 방법의 개요
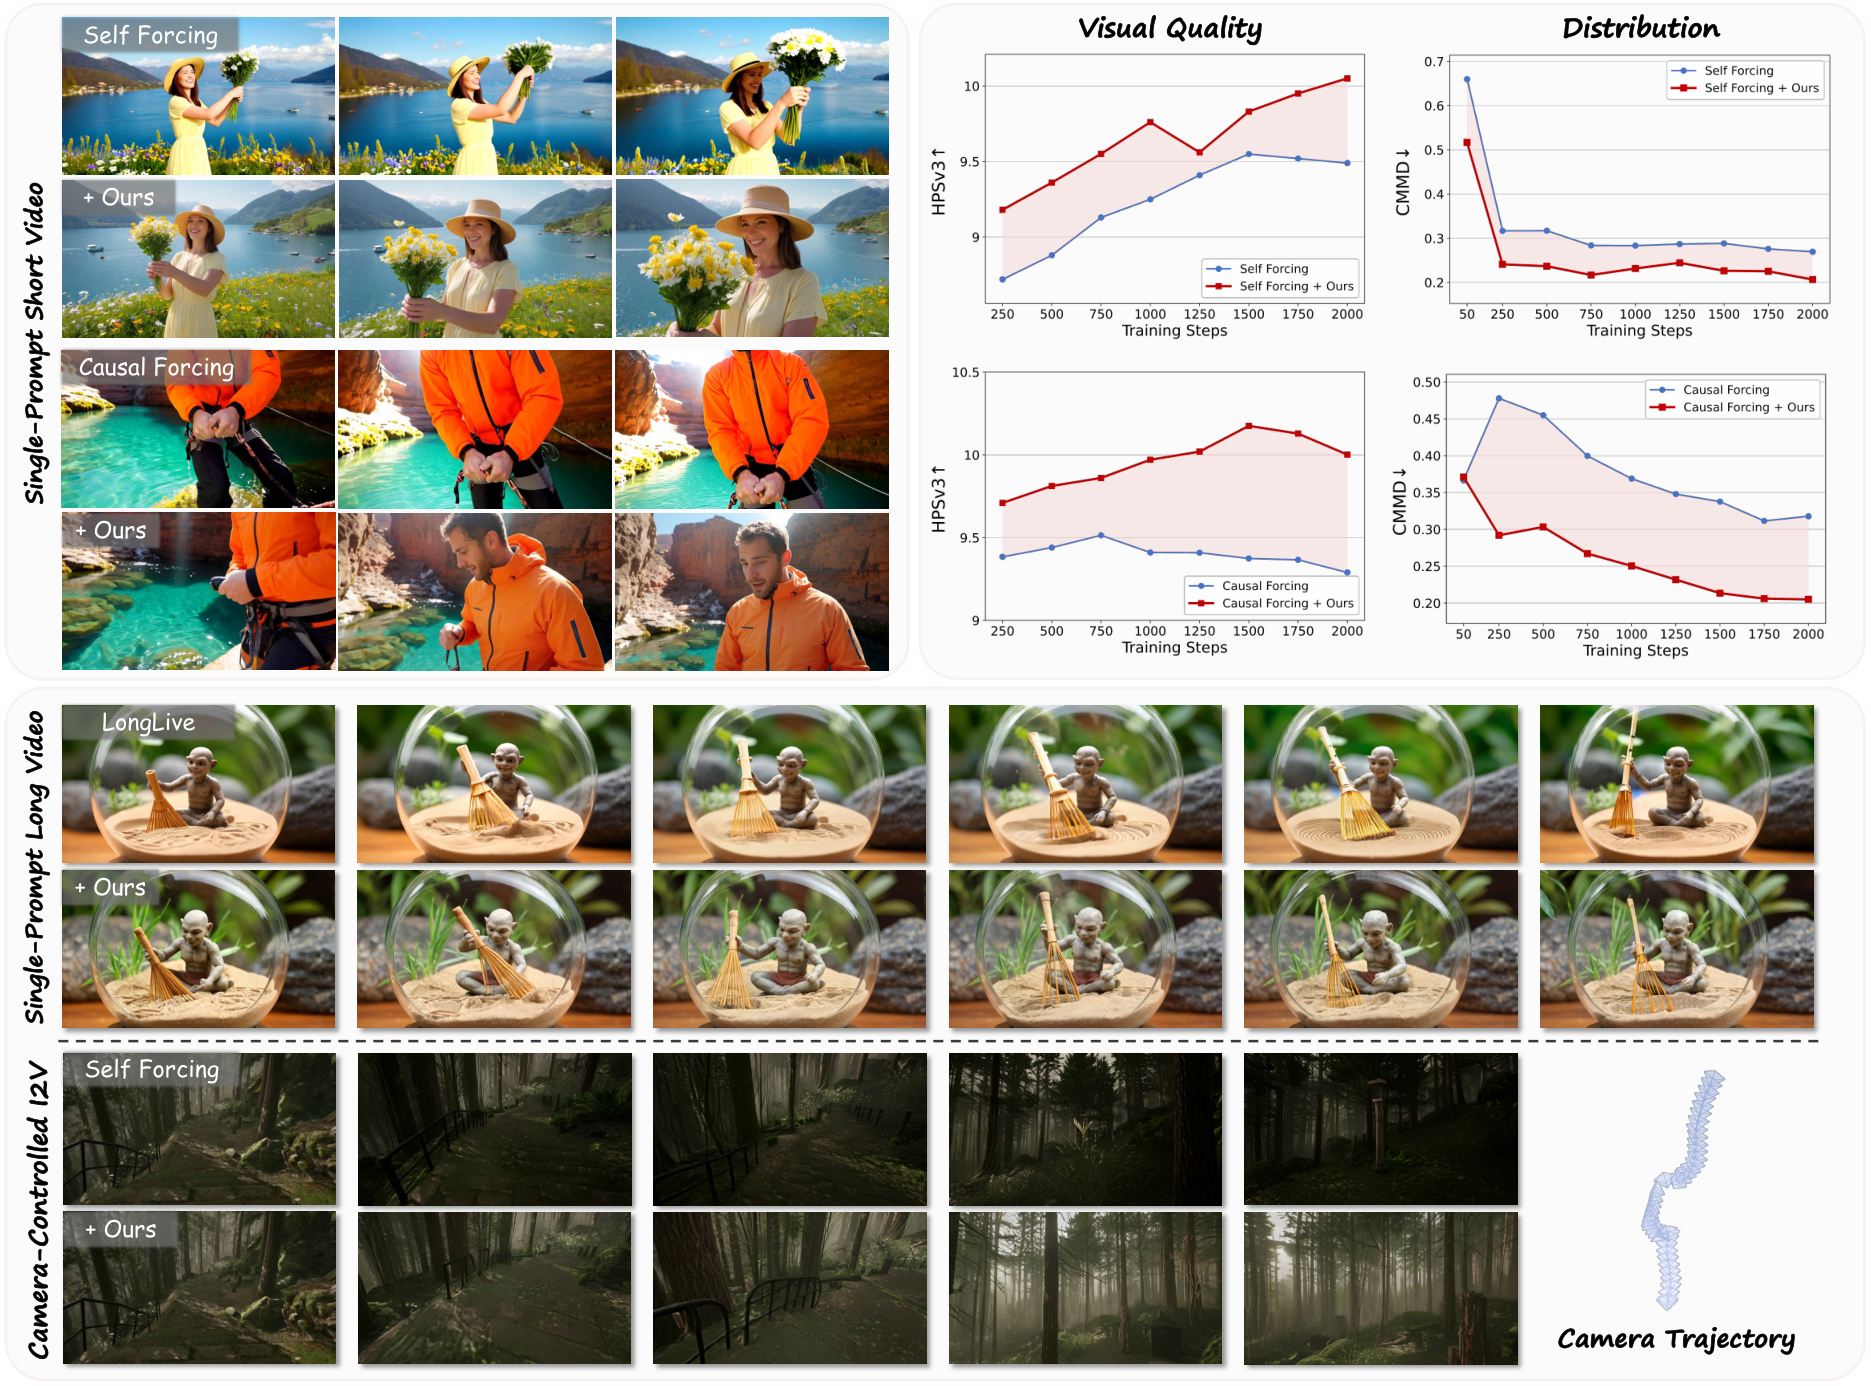
Figure 1 — Mask Forcing 개선 효과
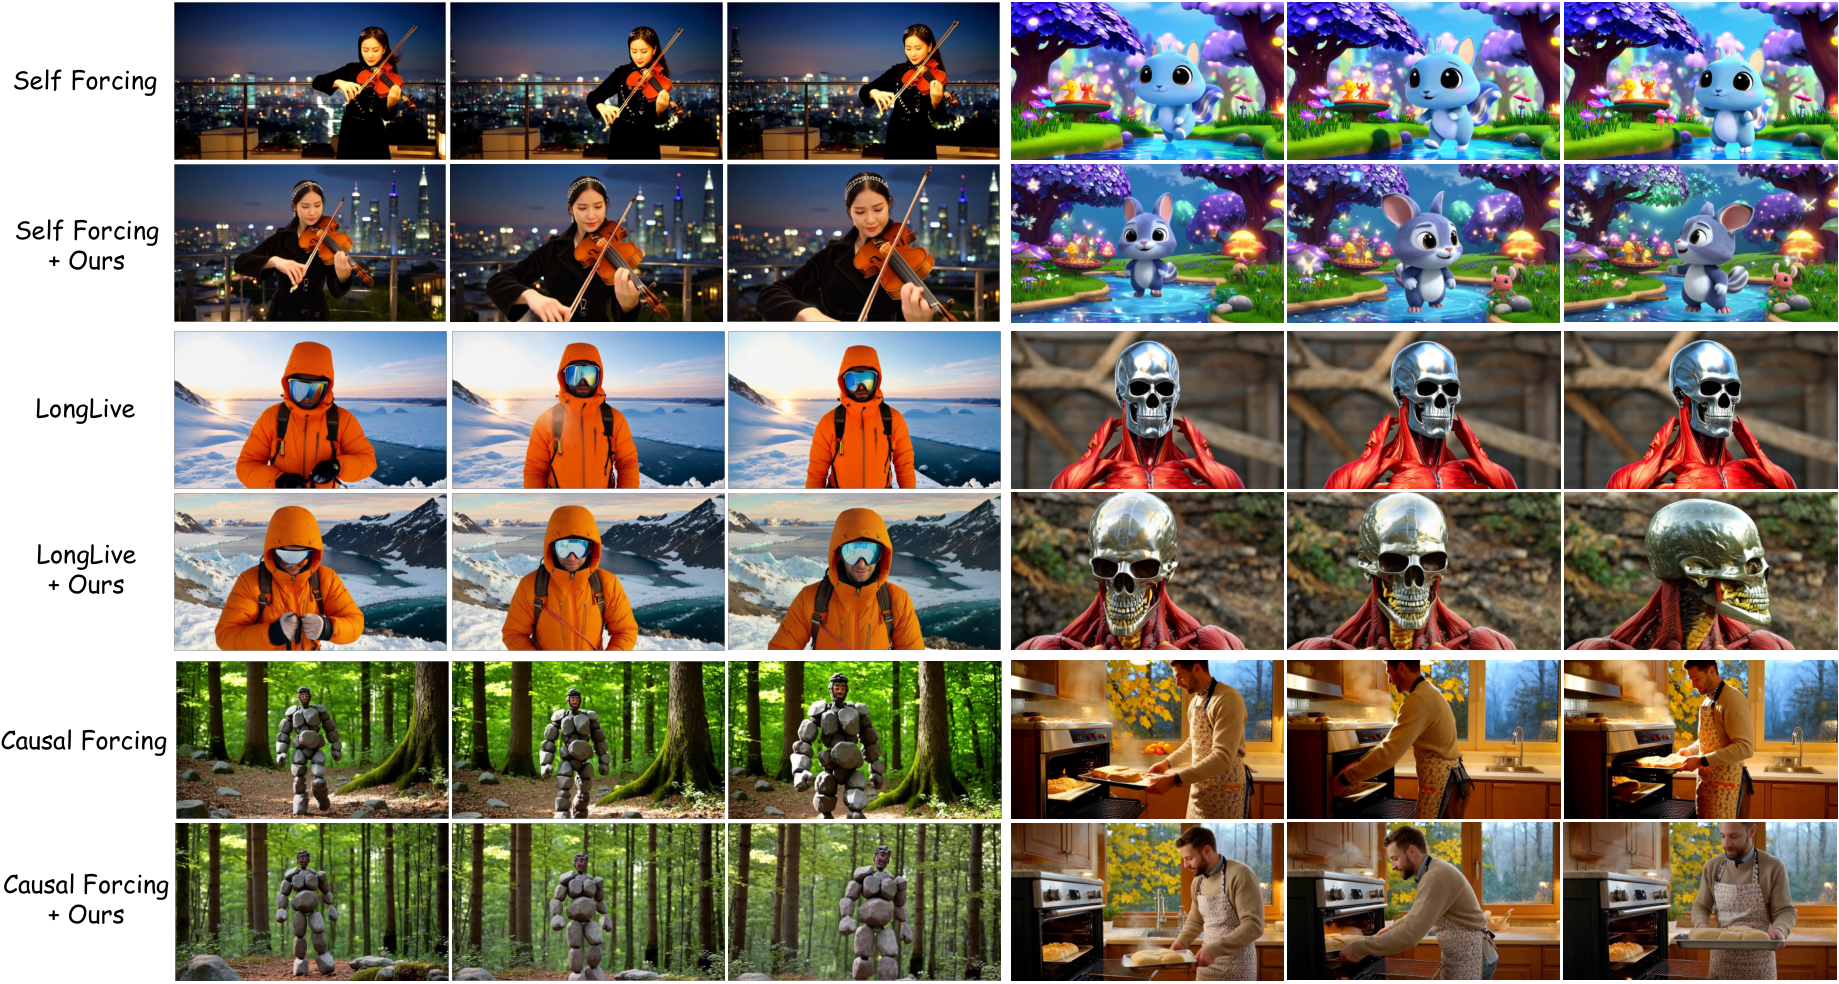
Figure 3 — 정성적 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldKV: Efficient World Memory with World Retrieval and Compression
- [논문리뷰] Forcing-KV: Hybrid KV Cache Compression for Efficient Autoregressive Video Diffusion Models
- [논문리뷰] World in World: Explore the World with World Models
- [논문리뷰] VidaForge: Open Research Infrastructure for Video Pretraining Data Recipes
- [논문리뷰] Principia: Relational Physics Tests for Video Models
Review 의 다른글
- 이전글 [논문리뷰] Marigold V2: Revisiting Diffusion Transformers for Monocular Depth Estimation
- 현재글 : [논문리뷰] Mask Forcing: Improving Autoregressive Video Diffusion Distillation via Dual-Noise Masking Rollout
- 다음글 [논문리뷰] MasterControl Seventeen Every Time
댓글