[논문리뷰] MLLMs Hallucinate when Information Distribution Drifts in Synergy Heads
링크: 논문 PDF로 바로 열기
저자: Meng'en Qin, Junye Chen, Jucheng Liu, Youlu Xing, Song Wang, Ruize Han
1. Key Terms & Definitions (핵심 용어 및 정의)
- MLLMs (Multimodal Large Language Models): 시각적 인식을 대규모 언어 모델과 결합하여 이미지 및 텍스트 입력을 기반으로 응답을 처리하고 생성하는 모델을 의미합니다.
- Hallucinations: MLLM이 시각적 맥락과 사실적으로 일치하지 않는, 그럴듯하게 들리는 응답을 생성하는 현상입니다.
- Synergy Heads: MLLM 내에서 시각 및 언어 정보 간의 개별 기여를 넘어 상당한 상호작용을 보이는 Attention Head를 지칭합니다.
- Causal Noise Intervention: Attention Head의 출력을 분포에 맞는 가우시안 노이즈로 대체하고, 그 결과 Layer representation의 변화를 측정하여 실제 인과적 기여도를 추정하는 기술입니다.
- Counterfactual Difference-in-Differences (DiD): Counterfactual input(예: 시각 또는 언어 토큰 마스킹)을 구성하여 Attention Head 내의 정보 분포를 분리하고 정보 내용을 정량화하는 메커니즘입니다.
- Equilibrium Factor (α): HEAL에서 도입된 하이퍼파라미터로, 모델의 시각-언어 정보 의존도를 동적으로 조절하여 출력 분포를 사실적 증거 방향으로 유도합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 MLLMs가 시각적 맥락과 사실적으로 불일치하는 그럴듯한 응답을 생성하는 Hallucinations 문제에 직면해 있음을 지적합니다. 기존의 Hallucination 완화 방법론, 특히 Attention 기반 접근 방식들은 간접적인 신호(예: Attention weights)에 의존하여 Hallucination 발생의 실제 정보 변화를 정확히 반영하지 못하는 한계를 가집니다. 또한, 단일 모달리티에 대한 Attention 강화는 "See-saw Dilemma"를 야기하여, 시각 Attention을 강화하면 응답이 잘리거나 창의성이 저하되고, 언어에 과도하게 의존하면 시각적 Hallucinations가 심화될 수 있습니다. 저자들은 Hallucinations가 Modality-specific heads의 양이나 강도와 강하게 상관되기보다는, Synergy Heads 내에서 정보 분포가 건전한 균형(Healthy equilibrium)에서 벗어날 때 발생한다는 핵심 통찰을 제시하며, 이를 해결하기 위한 새로운 접근 방식의 필요성을 강조합니다. [cite: 1, Figure 1]
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Autoregressive generation 과정에서 Hallucinations를 식별하고 완화하기 위한 HEAL (Head-lEvel information disentAnglement and caLibration)을 제안합니다. [cite: 1, Figure 3] HEAL은 먼저 Causal Noise Intervention을 사용하여 Multi-head output에서 인과적으로 불필요한(Causally redundant) Head를 걸러냅니다. 이어서, Counterfactual Difference-in-Differences (DiD) 메커니즘을 통해 남은 Head 내의 정보 분포를 분석하여 redundant, visual, language, 그리고 synergy의 네 가지 유형으로 Head를 분류합니다. 이러한 Head 분류는 MLLM 내부 메커니즘에 대한 Head-level의 세밀한 해석 가능성을 제공합니다 [Figure 2].
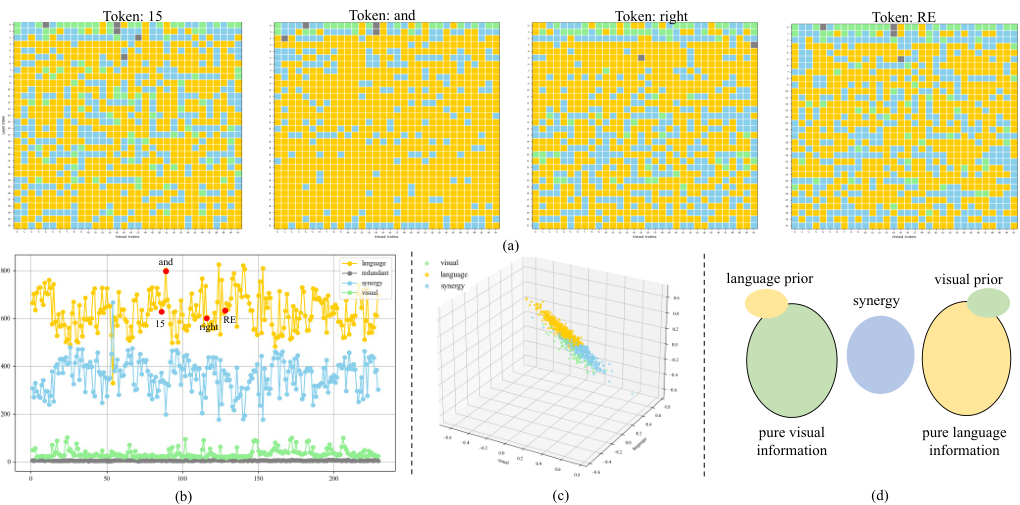
Figure 2 — Attention Head 분포 및 진화
Hallucinations가 Synergy Heads 내 정보 분포의 불균형에서 비롯된다는 발견을 바탕으로, HEAL은 추론 시 Dynamic Information Calibration 전략을 도입합니다. [cite: 1, Figure 3] 이는 Equilibrium Factor (α)를 사용하여 시각-언어 정보 의존도를 정밀하게 조절하고, Synergy Heads의 Value vectors에 동적 보정 요소(β, γ)를 주입하여 출력 분포를 사실적 증거 방향으로 유도합니다. 이론적으로, Theorem 1은 Value space Calibration이 Modality-wise information distribution Calibration과 동등함을 보장하며, Theorem 2는 Equilibrium Factor(α)가 출력과 시각 정보의 정렬에 단조적인 방향 효과를 가짐을 증명합니다. 효율적인 구현을 위해 HEAL은 Head 유형을 주기적으로 업데이트하고(예: 10단계마다), Calibration factor는 모든 디코딩 단계에서 계산하는 Periodic, Parallelized and Batched Implementation을 사용합니다.
실험 결과, HEAL은 여러 MLLM과 벤치마크에서 강력하고 일관된 성능 향상을 보였습니다. POPE-F1 스코어에서 LLaVA-1.5-7B 기준 87.7%를 달성하여 MemVR (87.1%) 및 LocoRE (86.9%)와 같은 최신 방법론들을 능가했습니다. [cite: 1, Table 1] 또한 CHAIR-S 메트릭에서는 LLaVA-1.5-7B 기준 36.7%를 기록하여 Hallucination을 효과적으로 감소시켰습니다. [cite: 1, Table 1] HEAL은 LLaVA-1.5-7B의 LLaVA-Bench 스코어를 72.5에서 75.2로, CHAIR_S를 51.0에서 36.9로 개선하는 등 다양한 MLLM 아키텍처(예: LLaVA-NeXT-7B, Qwen2.5-VL-7B, InternVL-7B)에서 Hallucination 관련 및 종합 메트릭을 일관되게 향상시켰습니다. [cite: 1, Table 2] 최근 벤치마크인 MMHal-Bench에서도 Qwen3-VL-8B의 Hallucination rate를 17.5에서 16.6으로, InternVL3.5-8B를 19.4에서 18.3으로 감소시키는 등 뛰어난 일반화 성능을 입증했습니다. [cite: 1, Table 16]
4. Conclusion & Impact (결론 및 시사점)
본 논문은 MLLMs의 Hallucinations가 Synergy Heads 내 정보 분포가 균형을 잃을 때 발생한다는 핵심적인 인과 관계를 밝혀냈습니다. 이를 해결하기 위해 저자들은 추론 시 Dynamic Information Calibration 전략인 HEAL을 제안하며, 이는 시각-언어 의존도를 효과적으로 조절하여 Hallucinations를 완화합니다. HEAL은 MLLM의 신뢰성을 향상시키는 간결하고 해석 가능한 경로를 제공하며, 다양한 MLLM과 포괄적인 벤치마크에서 일관된 성능 향상을 통해 강력한 일반화 능력을 입증했습니다. 이 연구는 MLLM의 내부 작동 방식에 대한 새로운 해석 가능한 시각을 제공하며, Hallucination 문제 해결에 있어 Modality-specific head의 역할보다는 Cross-modal synergy의 중요성을 강조합니다. 향후 연구는 더욱 적응적인 Calibration 정책과 모델 훈련과의 긴밀한 통합을 통해 현재의 한계점(예: 경험적 하이퍼파라미터 설정)을 극복할 수 있을 것으로 기대됩니다.
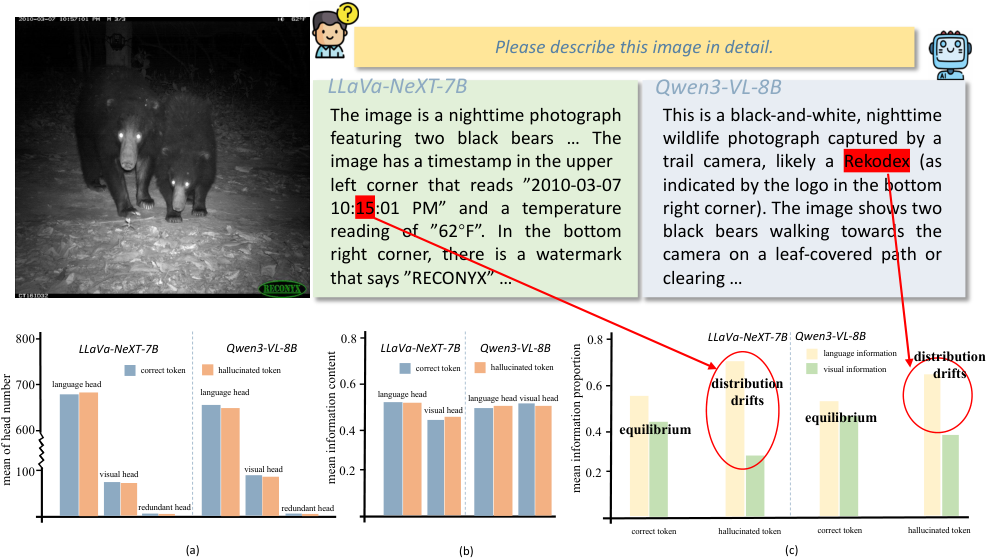
Figure 1 — Hallucination 시 Head 정보 분석
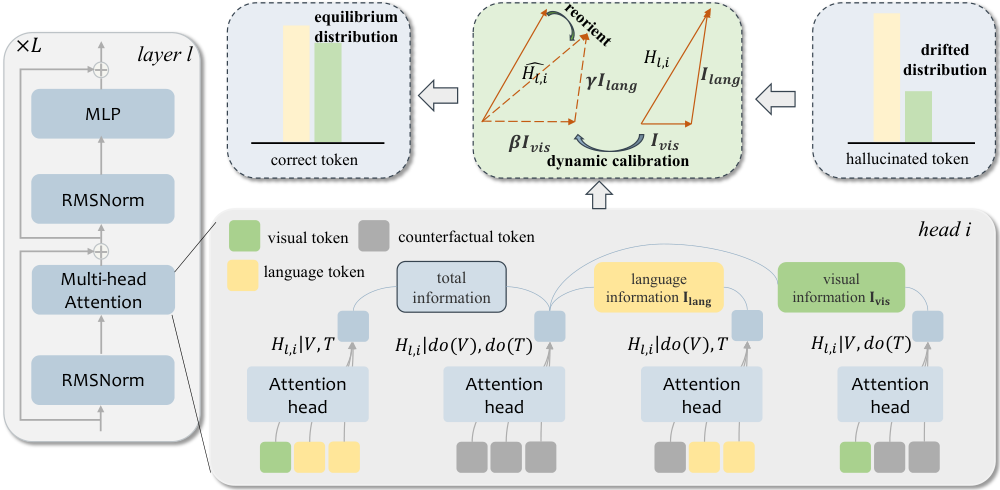
Figure 3 — 제안된 HEAL 방법론 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Taming Hallucinations: Boosting MLLMs' Video Understanding via Counterfactual Video Generation
- [논문리뷰] Paragraph Boundaries Are Not White Space:Compression Depth as the Signature of Hierarchical Structure
- [논문리뷰] VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control
- [논문리뷰] HarnessVLN: Unifying Training-Free Embodied Navigation through an Agent Harness
- [논문리뷰] Reason Through the Latent! Making Latent Visual Reasoning Necessary
Review 의 다른글
- 이전글 [논문리뷰] Learning Foresight without Explicit Trajectories for 3D Diffusion Policies
- 현재글 : [논문리뷰] MLLMs Hallucinate when Information Distribution Drifts in Synergy Heads
- 다음글 [논문리뷰] MintAct: A Unified Visual Agent for Digital Environments
댓글