[논문리뷰] HarnessVLN: Unifying Training-Free Embodied Navigation through an Agent Harness
링크: 논문 PDF로 바로 열기
저자: Yang Chen, Lirong Che, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Agent Harness: Multimodal Large Language Models (MLLMs), 툴, 메모리 및 환경 피드백을 통합 프레임워크 내에서 조율하는 메커니즘을 의미합니다.
- Spatiotemporal Graph (ST Graph): 에이전트가 축적한 경험의 환경 중심 추상화를 유지하며, 재사용 가능한 공간 증거, 관찰 출처 및 실패 기록에 대한 링크를 관리합니다.
- Hierarchical Event Memory: 에이전트의 상호작용 이력을 추적하는 태스크 중심 기록으로, Working memory, Progress memory, Reflection memory로 구성됩니다.
- MLLM (Multimodal Large Language Model): HarnessVLN에서 태스크 수준의 Planning, Instructions 해석, Targets 식별 및 Exploration 가이드를 담당하는 기반 모델입니다.
- Training-Free: 태스크별 Navigation Training 없이 Pretrained 모델의 Semantic knowledge와 Reasoning capabilities를 활용하는 접근 방식을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Training-based embodied navigation 방법론이 직면한 Generalization Challenge를 해결하고자 합니다. 기존 Training-based 방법들은 특정 태스크에 효과적이지만, 새로운 태스크나 환경으로 확장 시 추가 데이터와 Adaptation이 요구되는 한계가 있습니다. 또한, Multimodal Large Language Models (MLLMs) 기반의 Training-free 접근 방식들은 강력한 Semantic Reasoning을 제공하지만, 제안된 Actions을 Spatial evidence, Task progress 및 Execution failures와 조화시키는 메커니즘이 부족합니다. 이는 Planning이 실제 Task state와 Divergence를 일으키거나, 반복적인 시도, 부정확한 Termination으로 이어질 수 있는 핵심적인 문제로 작용합니다. 저자들은 의미론적으로 타당한 계획조차 공간적 증거(Spatial evidence)나 실행 지원(Execution support)이 부족하여 수행되지 못하는 문제가 존재하며, 이를 해결하기 위한 Runtime Mechanism의 필요성을 강조합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Training-free 방식으로 Instruction-following 및 Object-goal navigation을 통합하는 HarnessVLN 프레임워크를 제안합니다. HarnessVLN은 Agent Harness를 통해 Perception, Retrieval, Grounding, Navigation, Recovery, Termination을 Unified Tool Interface로 조정합니다 [Figure 2, cite: 1]. Harness는 MLLM Planner의 Proposal을 Spatial evidence, Geometric feasibility, Subgoal consistency에 기반하여 검증하며, 구조화된 Tool feedback을 다음 Decision에 통합합니다. Memory 측면에서는 태스크 중심의 Hierarchical Event Memory (Working, Progress, Reflection memory)가 태스크 진행 상황과 실행 이력을 추적하며, 환경 중심의 Persistent Spatiotemporal Graph (ST Graph)는 재사용 가능한 Spatial evidence 및 Failure annotation을 유지하여 Verification 및 Recovery를 지원합니다. Navigation Executor는 검증된 Target을 실행 가능한 Motions로 변환하며, Stop validation은 태스크 완료를 엄격하게 검증합니다.
실험 결과, HarnessVLN은 Training-free SOTA 성능을 크게 상회했습니다. Instruction-following navigation 벤치마크인 R2R에서 60.8%의 Success Rate (SR)를 달성하여 이전 SOTA 대비 5.8%p 향상되었으며, RxR에서는 53.9%의 SR을 기록하여 12.1%p 향상되었습니다 [Table 2, cite: 1]. Object-goal navigation 벤치마크인 HM3D-v2에서는 76.0% SR로 1.6%p 향상, HM3D-OVON에서는 59.3% SR로 9.1%p 향상된 결과를 보여주었습니다 [Table 3, cite: 1]. Ablation study를 통해 Hierarchical Event Memory는 SR을 R2R에서 8.0%p, HM3D-OVON에서 7.0%p 향상시켰고, ST Graph는 R2R에서 6.0%p, HM3D-OVON에서 1.0%p 추가적인 SR 향상을 보였습니다 [Table 4, cite: 1]. 또한, Stop validation은 SR을 각각 4.0%p와 2.0%p 추가로 높였습니다 [Table 4, cite: 1].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Training-free 방식으로 Instruction-following 및 Object-goal navigation을 Unified Agent Harness를 통해 통합하는 HarnessVLN 프레임워크를 성공적으로 제시합니다. HarnessVLN은 MLLM Planning, Hierarchical memory, Spatial evidence, 그리고 Validated tool execution을 효과적으로 조율함으로써, Semantic Reasoning과 Grounded Action 사이의 간극을 해소합니다. 벤치마크 실험 결과는 다양한 Navigation tasks에서 향상된 Task completion 능력을 입증했으며, Humanoid robot에 대한 Real-world deployment를 통해 실제 환경에서의 적용 가능성도 보여주었습니다 [Figure 3, cite: 1]. 이 연구는 복잡한 Embodied navigation task를 위한 Training-free, Generalizable, Robust한 시스템 개발에 중요한 기여를 하며, 향후 Self-evolving 메커니즘 연구의 기반을 제공합니다.
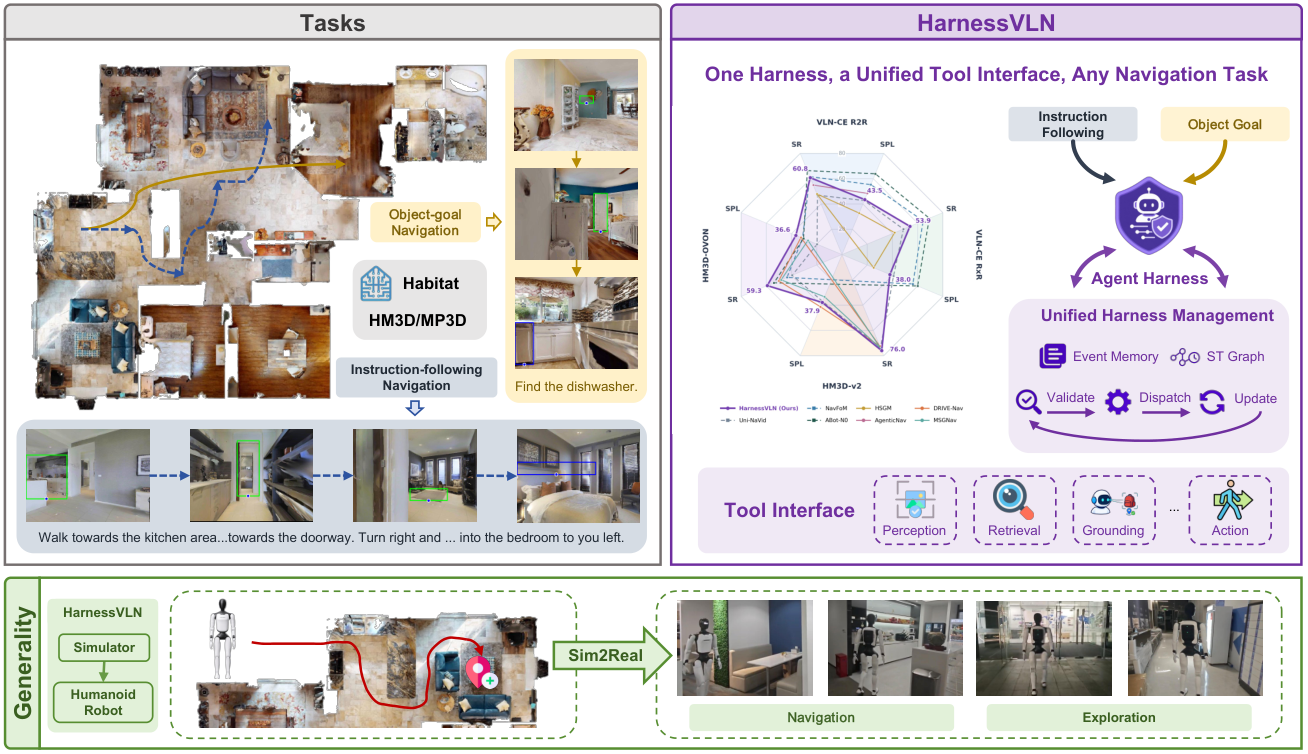
Figure 1 — HarnessVLN의 통합된 에이전트 하네스
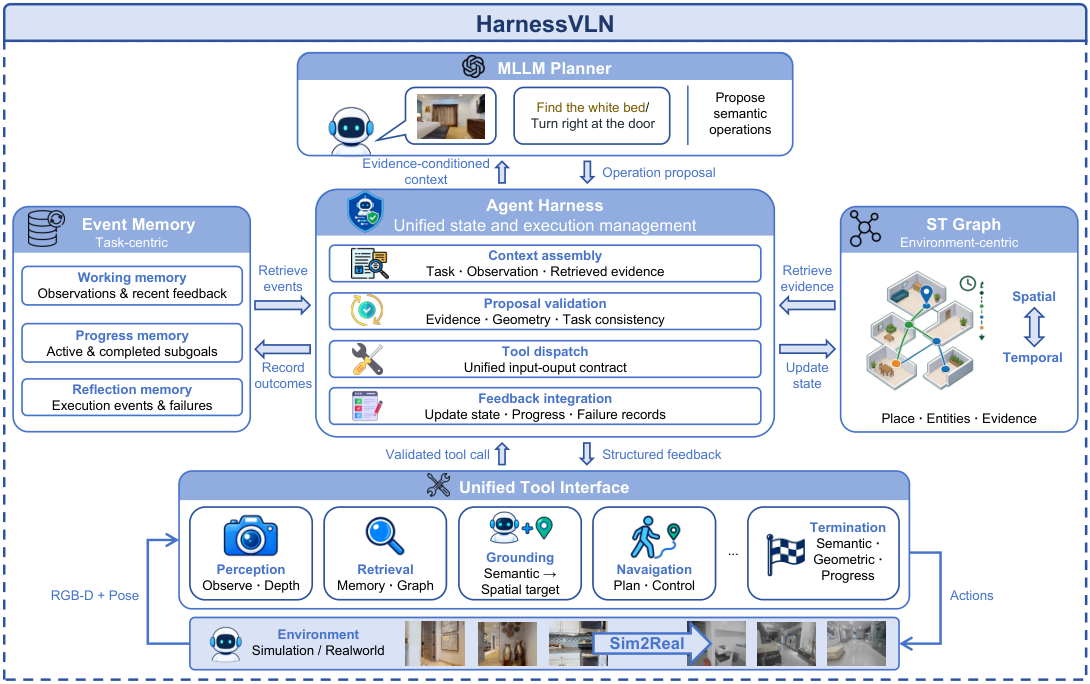
Figure 2 — HarnessVLN 프레임워크 개요
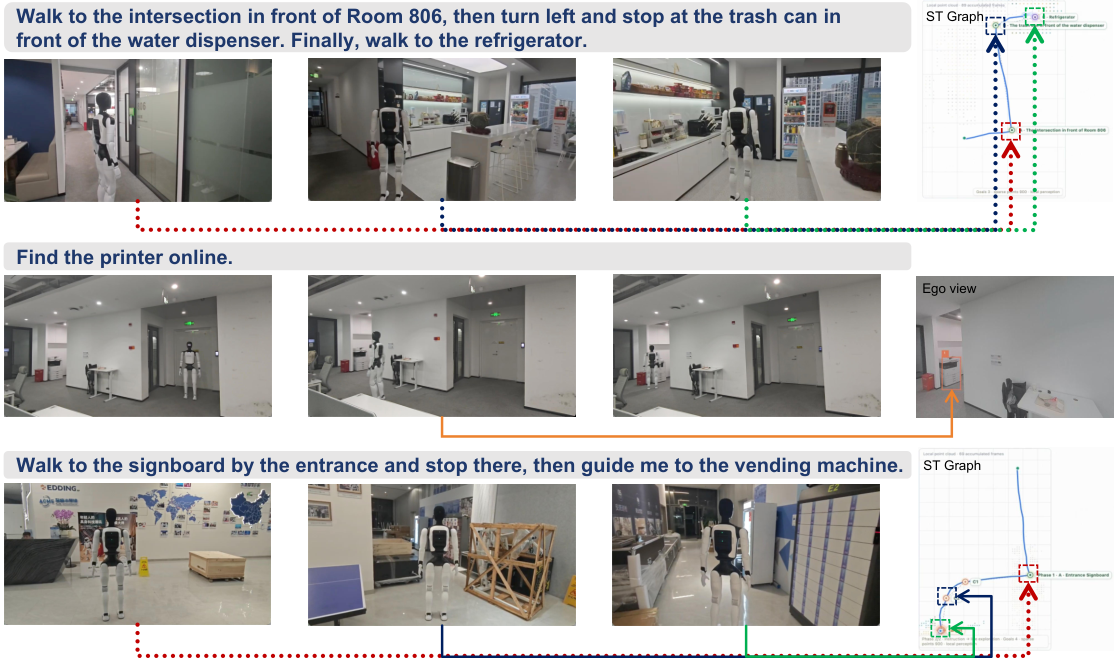
Figure 3 — 실세계 내비게이션 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MLLMs Hallucinate when Information Distribution Drifts in Synergy Heads
- [논문리뷰] VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control
- [논문리뷰] SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
- [논문리뷰] Reflect, Revise, Reuse: Training-Free Skill Evolution for GUI Agents
- [논문리뷰] CoVeR: Coverage-Based Token Pruning for Multi-View 3D Reasoning in VLMs
Review 의 다른글
- 이전글 [논문리뷰] Emergence World: Adversarial Stress-Testing of Long-Horizon Multi-Agent Systems
- 현재글 : [논문리뷰] HarnessVLN: Unifying Training-Free Embodied Navigation through an Agent Harness
- 다음글 [논문리뷰] ImpossibleRubrics: Stress-Testing Generated Rubrics as Reward Signals
댓글