[논문리뷰] Duplex-MPE: Benchmarking Multi-Party Interaction in Full-Duplex Dialogue
링크: 논문 PDF로 바로 열기
저자: Chengqian Ma, Wenhao Feng, Weixuan Jin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Full-Duplex Speech Models: 스피킹 중에도 리스닝이 가능하여, 고정된 턴(turn) 경계 없이 자연스러운 상호작용을 가능하게 하는 모델.
- Multi-Party Dialogue (MPE): 여러 명의 인간 화자와 하나의 어시스턴트가 참여하는 대화로, 참가자들이 서로, 다른 디바이스, 또는 어시스턴트에게 발화할 수 있는 환경.
- T (Direct Request): Aria에게 직접적으로, 아직 해결되지 않은 요청을 나타내는 턴 유형으로, 어시스턴트의 응답이 요구됨.
- N1, N2, N3 (Silence-Requiring Turns): 어시스턴트가 언급되었으나 아무것도 요청받지 않은 경우 (N1), Aria 이외의 다른 대상에게 발화된 경우 (N2), 또는 지정된 수신자가 없는 발화 (N3)를 포함하며, 이 턴들에서는 어시스턴트가 침묵을 유지해야 함.
- N4 (Answering-Window Yield): 인간 참가자가 요청을 해결했을 때 Aria가 발화를 중단해야 하는지를 평가하는 턴 유형.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 풀-듀플렉스(full-duplex) 음성 모델 벤치마크가 다자간 대화(multi-party dialogue) 환경에서 어시스턴트의 선별적 참여(selective participation) 능력을 충분히 평가하지 못하는 문제를 제기한다. 기존 벤치마크들은 주로 지정된 사용자(designated user)와의 일대일 상호작용, 즉 턴-테이킹(turn-taking)이나 인터럽션(interruption) 처리, 또는 비-지정 발화(non-addressed speech)의 rejection에 초점을 맞추어 왔다. 그러나 미팅룸이나 거실과 같은 실제 다자간 환경에서 어시스턴트는 여러 화자 간의 공유된 대화를 이해하고, 자신에게 요청된 것이 아닌 발화에서도 필요한 정보를 파악하며, 언제 응답해야 할지, 언제 침묵해야 할지, 그리고 심지어 다른 참가자가 요청을 해결했을 때 언제 발화를 중단해야 할지 결정해야 하는 복잡한 인지 및 발화 제어 능력이 요구된다. 이러한 다이내믹한 상황에서의 어시스턴트의 적절한 참여를 평가할 수 있는 벤치마크의 부재가 핵심적인 한계점으로 지적된다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 연속적인 다자간 오디오를 수신하는 음성 모델이 선별적으로 응답하는 능력을 평가하기 위해 Duplex-MPE 벤치마크를 제안한다. 이 벤치마크는 3-4명의 인간 화자와 1명의 어시스턴트(Aria)가 참여하는 2,000개의 연속적인 다자간 시나리오를 포함하며, 각 시나리오는 명시적(explicit) 및 암시적(implicit) 어드레싱(addressing) 조건으로 쌍을 이루어 총 4,000개의 평가 대화를 구성한다. 모델은 트랜스크립트나 턴 경계 같은 추가 정보 없이 지속적인 대화 오디오만을 입력으로 받는다.
데이터셋은 Claude Opus 5가 생성한 스크립트를 기반으로 Qwen3-TTS를 통해 음성을 합성하여 구축되었다 [Figure 2]. 평가는 다음 네 가지 핵심 지표를 사용한다:
- Fresh-onset response rate: 요청 종료 후 5초 이내에 새로운 발화를 시작한 T 요청의 비율.
- Conditional answer accuracy: 응답 창(response window) 내에 발화가 있는 T 요청 중 정답을 맞힌 비율.
- Silence preservation: N1, N2, N3 턴에서 침묵을 유지하거나 간단한
acknowledgement만 수행한 비율. - Answering-window yield: N4 이벤트 중 인간이 요청을 해결했을 때 발화를 중단한 비율.
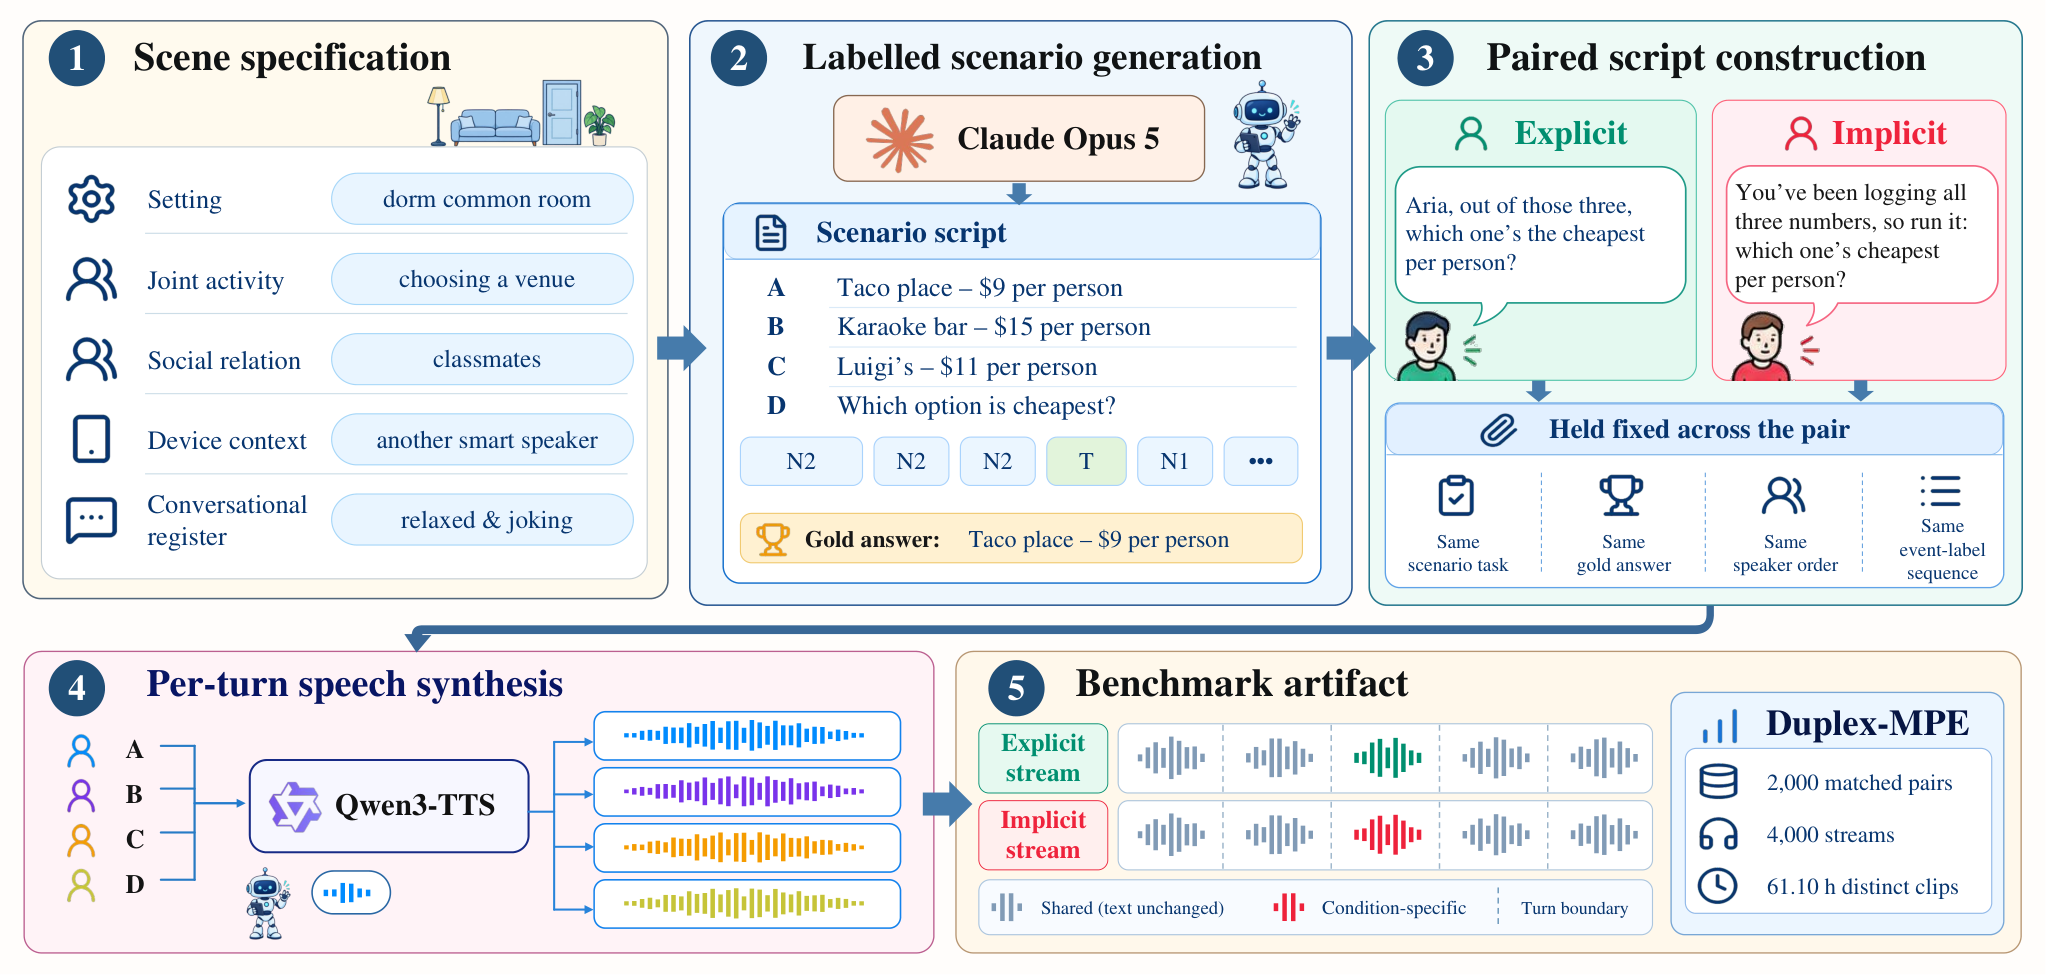
Figure 2 — Duplex-MPE 데이터셋 구축 과정
MiniCPM-o 4.5, Moshi, FLM-Audio, Voila, Freeze-Omni 등 5가지 오픈-웨이트 음성 시스템이 평가되었고, 텍스트 기반의 Gemini 3.1 Pro가 레퍼런스(reference) 모델로 사용되었다. 주요 결과는 다음과 같다:
- MiniCPM-o 4.5는 Fresh-onset response rate, Conditional answer accuracy, Silence preservation 세 가지 지표에서 선도적인 성능을 보였다. 예를 들어, 명시적 어드레싱 조건에서 Fresh-onset response rate는 0.9500, Conditional answer accuracy는 0.4730, Silence preservation은 0.9242를 기록했다.
- 다른 시스템들은 잦은 발화(
Response presence가 높음)에도 불구하고 부정확한 답변이나 침묵 유지 실패를 보였다. 특히 Freeze-Omni는 거의 완벽한Response presence(0.9955)를 보였으나, Silence preservation은 0.0002로 극히 낮아,Response presence만으로는 적절한 참여를 판단하기 어렵다는 점을 명확히 보여주었다. - Answering-window yield에서는 Voila가 명시적 조건에서 0.8484로 가장 높은 성능을 기록하여, 다른 참가자가 요청을 해결했을 때 발화를 효과적으로 중단하는 능력을 입증했다.
- Gemini 3.1 Pro (텍스트 기반 레퍼런스)는 명시적 요청에 대해 암시적 요청보다 64.3% 포인트 더 자주 응답했지만, 평가된 5개 음성 시스템에서는 통계적으로 유의미한 응답률 차이가 발견되지 않아, 음성 모델이 암시적 어드레싱 추론에 어려움을 겪음을 시사한다.
4. Conclusion & Impact (결론 및 시사점)
Duplex-MPE는 end-to-end 풀-듀플렉스 음성 모델이 연속적인 다자간 오디오 환경에서 addressee inference를 기반으로 발화 제어(speech-control) 결정을 내리는 능력을 평가하는 중요한 벤치마크이다. 본 연구는 fresh-onset response rate, conditional answer accuracy, silence preservation, answering-window yield와 같은 개별 지표의 중요성을 강조하며, 단순히 speech presence가 높다고 해서 모델의 적절한 대화 참여 능력을 의미하지 않음을 입증했다. missed requests, low-content responding, intrusion, near-continuous speech와 같은 다양한 실패 프로파일을 명확히 드러냄으로써, 이 벤치마크는 현존하는 음성 모델들이 다자간 대화의 미묘한 사회적 역학(social dynamics)과 addressee recognition에서 여전히 중대한 한계를 가지고 있음을 보여준다. 이 연구는 학계 및 산업계에서 보다 정교하고 인간과 유사한 대화형 AI 시스템 개발을 위한 명확한 개선 방향을 제시하며, 자동화된 생성 및 평가 파이프라인은 향후 대규모 평가 및 연구 확장을 위한 견고한 기반을 제공한다.
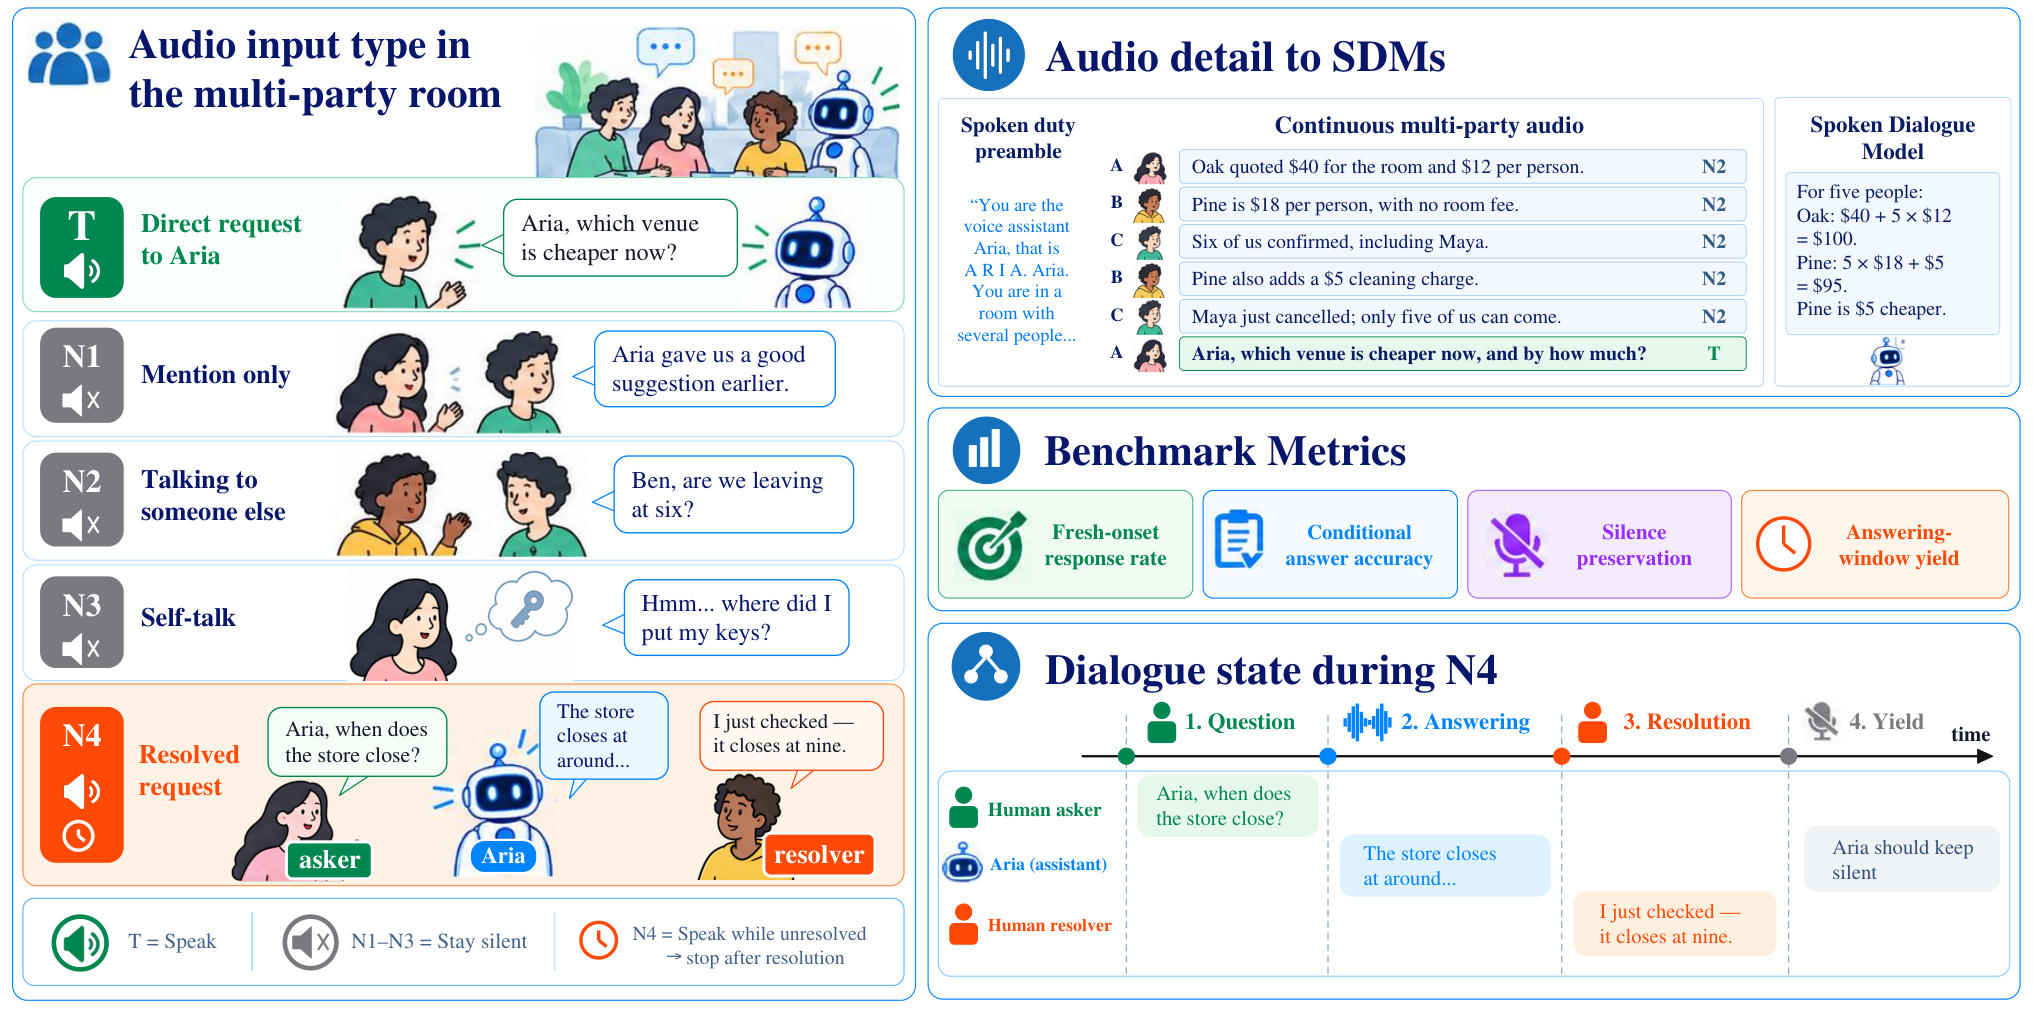
Figure 1 — Duplex-MPE 벤치마크 개요
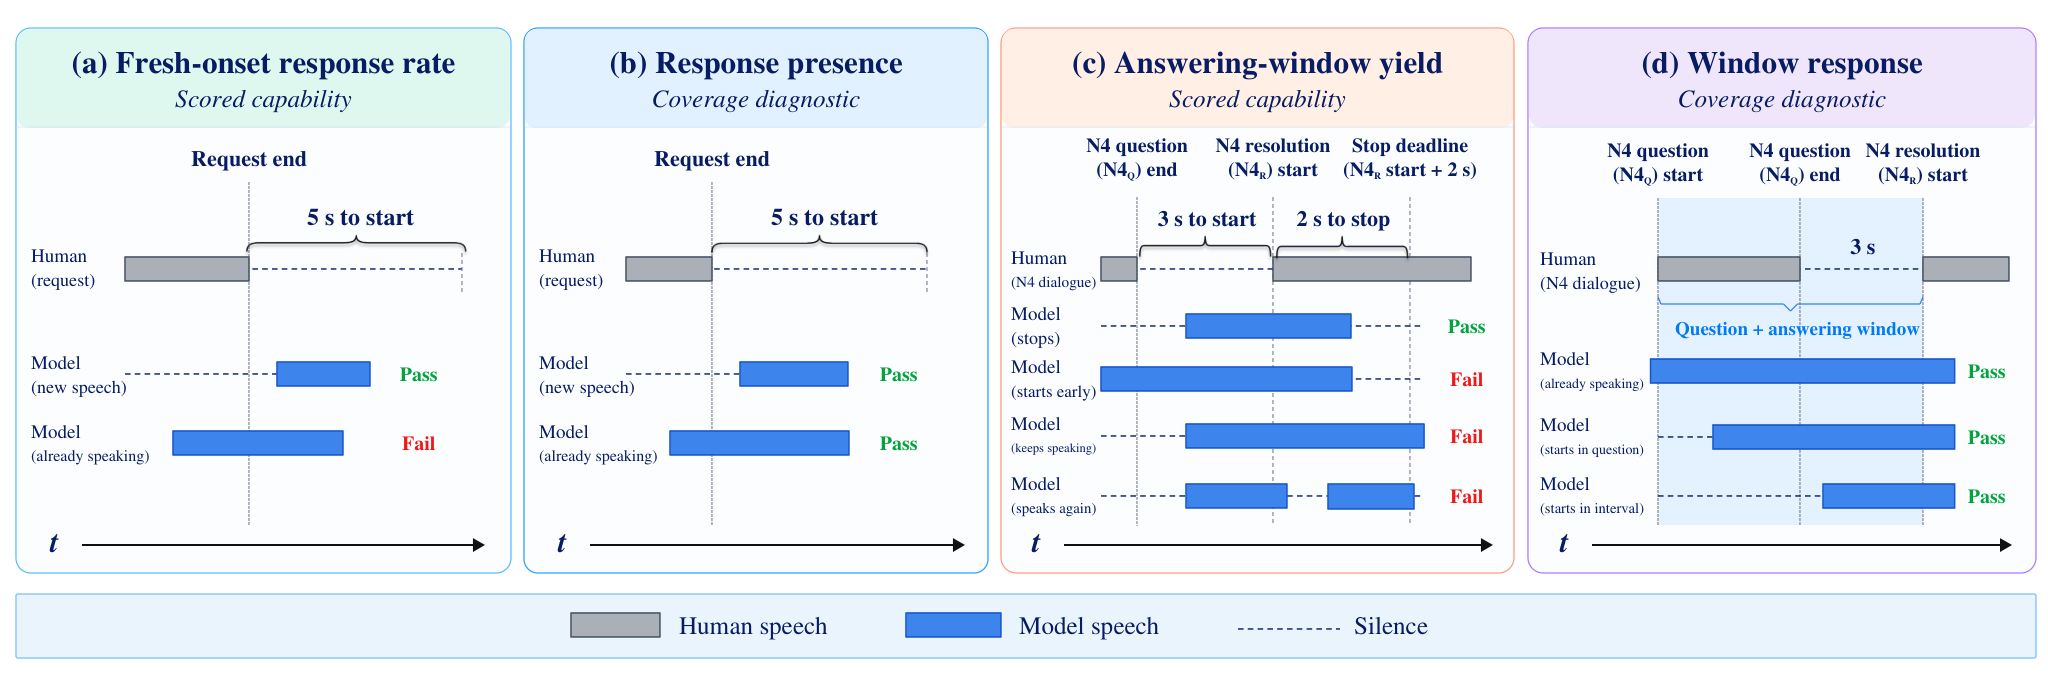
Figure 3 — 응답 타이밍 측정 스키마
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Voice Evaluation of Reasoning Ability: Diagnosing the Modality-Induced Performance Gap
- [논문리뷰] WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
- [논문리뷰] SolveEdit: Benchmarking Visual Problem Solving in Generative Models
- [논문리뷰] SciGen-Verifier: A Multimodal Reasoner for Explainable Verification in Scientific Image Generation
- [논문리뷰] OmniEcho: Spatial Audio Understanding for Embodied Agents
Review 의 다른글
- 이전글 [논문리뷰] Diffusion Reward Models
- 현재글 : [논문리뷰] Duplex-MPE: Benchmarking Multi-Party Interaction in Full-Duplex Dialogue
- 다음글 [논문리뷰] EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks
댓글