[논문리뷰] GeoVerse: World-Consistent Novel View Synthesis in Geometric Latent Space
링크: 논문 PDF로 바로 열기
저자: Kerui Ren, Tao Lu, Linning Xu, Changjian Jiang, Hunag Mu, Chunhua Shen, Mulin Yu, Bo Dai
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Geometric Latent Space: DA3 3D foundation model의 인코더 기능을 활용하여, 다중 뷰 간의 기하학적 일관성을 유지하며 생성 과정을 수행하는 잠재 공간입니다.
- Wan2.2 VACE: 강력한 appearance prior를 제공하기 위해 통합된 고성능 비디오 확산 모델(video diffusion model)입니다.
- Persistent Spatial Memory: 장기 시퀀스 생성 시 누적된 3D 기하학적 정보를 Global colored point-cloud 형태로 저장하여, 일관성 있는 뷰 생성을 유도하는 메커니즘입니다.
- Reflow Distillation: 다단계 노이즈 제거 과정을 4-step 수준의 효율적인 추론으로 단축하기 위한 지식 증류 기법입니다.
- ATE (Absolute Trajectory Error): 생성된 뷰 시퀀스와 실제 궤적 간의 일관성을 측정하는 지표로, GeoVerse의 기하학적 정확도를 증명하는 핵심 수치입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존 Novel View Synthesis (NVS) 기술이 직면한 기하학적 일관성과 상세한 생성 품질 사이의 불균형을 해결하기 위해 고안되었습니다. 기존의 geometry-based 방법론들은 고정된 구조 보존에는 강점이 있으나 미관측 영역의 복원이 미흡하고, video generative 모델들은 풍부한 표현력을 가지지만 시퀀스 생성 시 누적되는 오차와 일관성 붕괴 문제를 겪습니다. [Figure 1]에서 볼 수 있듯이, 생성된 관측치를 지속적으로 통합하지 못하면 긴 궤적에서 구조적 파괴가 발생합니다. GeoVerse는 이러한 한계를 극복하고자 geometric latent space 내에서 비디오 생성 모델의 사전 지식을 결합하여, 실시간 수준의 속도와 높은 수준의 세계 일관성을 동시에 달성하는 프레임워크를 제안합니다.
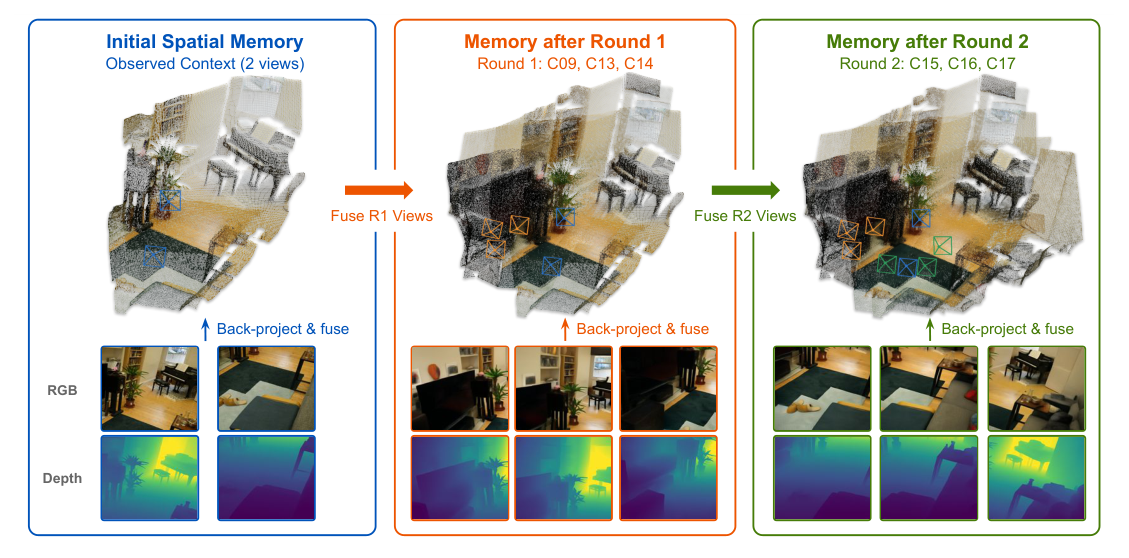
Figure 1 — 전체 프레임워크의 개념 및 긴 시퀀스에서 지속적인 기억을 통한 일관성 유지 메커니즘을 보여주는 핵심 그림
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
GeoVerse는 geometric latent diffusion 프레임워크를 기반으로 Wan2.2 VACE의 비디오 사전 지식을 ControlNet-style adapter를 통해 주입함으로써 구조적 완결성과 외형적 정교함을 극대화합니다. [Figure 2]는 관측된 문맥 정보가 어떻게 Global spatial memory로 통합되고, 이를 통해 타겟 뷰에 대한 RGB-D guidance가 제공되는지를 보여줍니다. 특히, 3D 기하학 정보를 담고 있는 잠재 공간과 비디오 생성 모델의 appearance prior를 결합하여 단일 패스에서도 안정적인 합성을 지원합니다. 또한 Reflow Distillation을 도입하여 추론 단계를 4단계로 단축함으로써 기존 GLD 대비 18배 이상의 속도 향상을 이루었습니다. 정량적 평가 결과, GeoVerse는 DL3DV 데이터셋에서 PSNR 기준 2.23 dB 향상된 성능을 기록했으며, Mip-NeRF360 데이터셋에서 ATE를 32.4% 낮추어 압도적인 기하학적 일관성을 증명하였습니다. [Table 1]을 통해 모든 지표에서 기존 최신 기법들보다 우월한 성능을 확인할 수 있습니다.
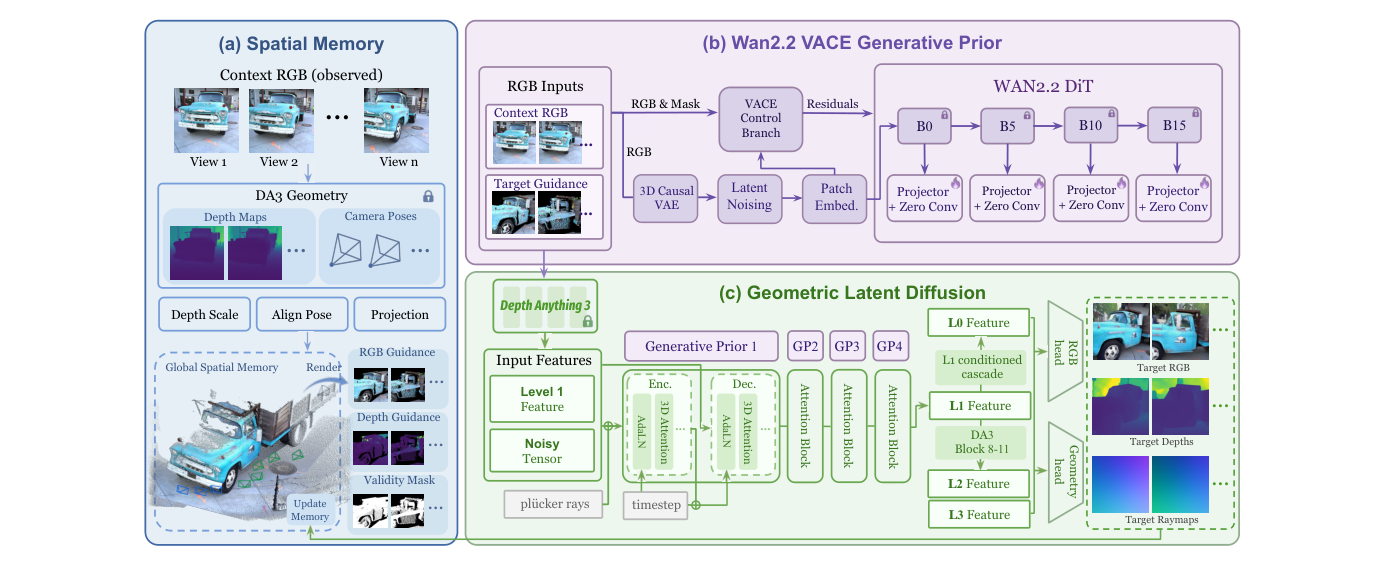
Figure 2 — 제안하는 모델의 상세 아키텍처와 Spatial Memory, Wan2.2 VACE, Geometric Latent Diffusion 간의 상호작용을 보여주는 핵심 다이어그램
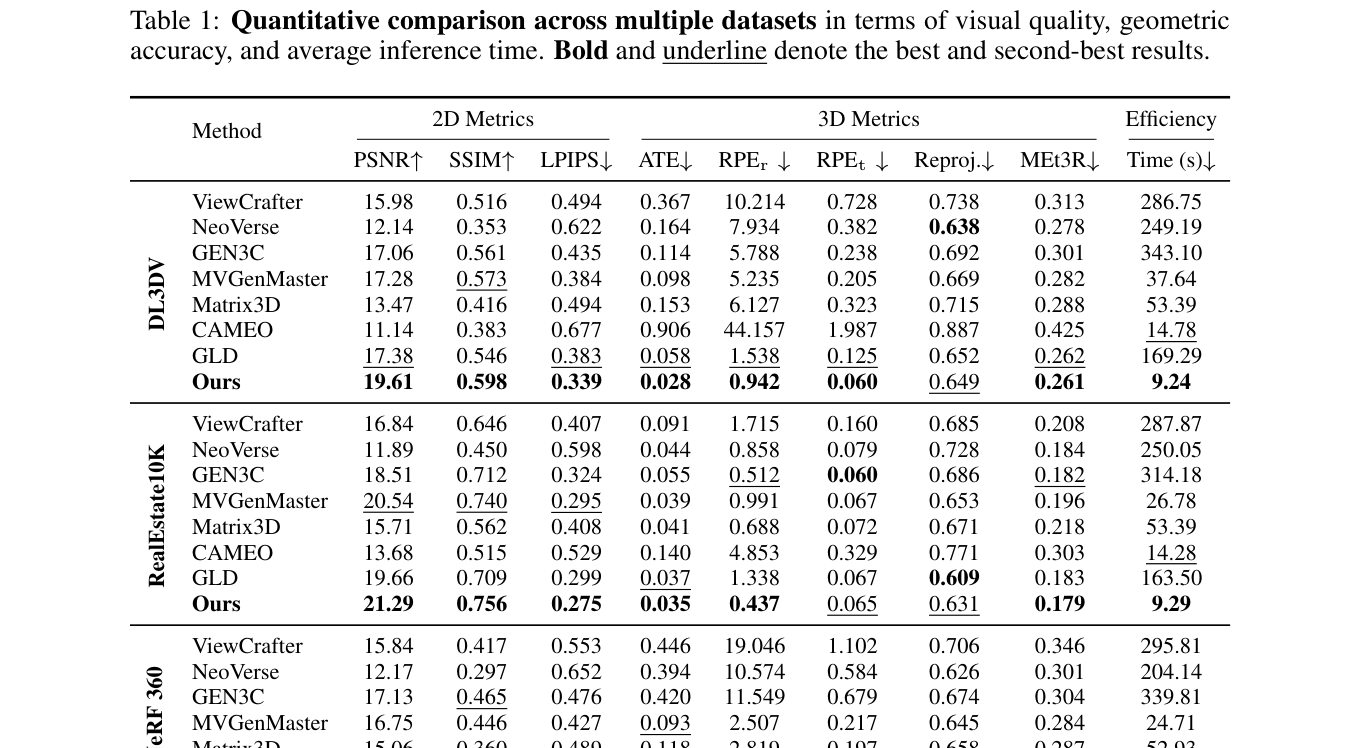
Table 1 — 다양한 데이터셋에 대한 성능 비교를 통해 모델의 우수성을 증명하는 핵심 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 geometric latent diffusion에 비디오 생성 사전 지식과 영구적 공간 메모리를 통합하여 세계 일관성을 유지하는 혁신적인 NVS 프레임워크를 정립하였습니다. 제안된 Global spatial memory는 긴 시퀀스 생성 시의 누적 오차를 방지하고, Reflow Distillation은 효율적인 실시간 추론을 가능하게 합니다. 이러한 성과는 학계에 고품질 3D 비디오 세계 모델을 위한 강력한 기틀을 제공하며, 향후 확장성 높은 3D 생성 인공지능 연구의 핵심 레퍼런스가 될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Fast Spatial Memory with Elastic Test-Time Training
- [논문리뷰] When Memory Lies: An Empirical Study of Spatial Memory Staleness in VLM Agents
- [논문리뷰] UniWorld-View: Large-Baseline View Synthesis via Video Diffusion Models
- [논문리뷰] AlayaWorld: Long-Horizon and Playable Video World Generation
- [논문리뷰] DF3DV-1K: A Large-Scale Dataset and Benchmark for Distractor-Free Novel View Synthesis
Review 의 다른글
- 이전글 [논문리뷰] FlowTool: Controlling Tool Parameter in Image Retouching via Flow Matching
- 현재글 : [논문리뷰] GeoVerse: World-Consistent Novel View Synthesis in Geometric Latent Space
- 다음글 [논문리뷰] Groupwise Agentic Grading and Advantage Redistribution for Code Agent RL
댓글