[논문리뷰] Just MLPs: Efficient Visual State Reconstruction for Multimodal Language Models
링크: 논문 PDF로 바로 열기
저자: Jingdi Lei, Junxian Li, Di Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MLLMs (Multimodal Large Language Models): 텍스트 추론을 넘어 시각적 인지 및 이해 능력을 갖춘
Large Language Models (LLMs)을 지칭합니다. - Visual Tokens:
Vision Encoder와Multimodal Projector를 통해 시각적 입력(I)이LLM의Hidden Dimension에 맞게 변환된Nv개의 임베딩(E) 시퀀스를 의미합니다. 이들은 텍스트 스트림에Visual Context를 제공하고,Transformer레이어 내에서 활성 상태로 진화합니다. - δ-Vision:
Visual Tokens의 반복적인Transformer업데이트 경로를 경량의Low-Rank Adapters로 대체하여Layer-Wise Visual Memory를 효율적으로 구축하는 제안된 프레임워크입니다 [cite: 1, Figure 2]. 모든Visual Token을Text Retrieval에 활용하면서 계산 비용을 절감하는 것을 목표로 합니다. - Low-Rank Adapters:
δ-Vision에서Layer-Wise Visual Memory를 생성하는 데 사용되는 경량의MLP기반 모듈입니다.Bottleneck Dimension (r)을 활용하여 시각적 정보 업데이트의 차원을 제한함으로써 효율성을 확보합니다. - Supervised-KD (Supervised Knowledge Distillation):
δ-Vision의 훈련Objective로, 원본MLLM을Teacher로,δ-Vision을Student로 활용하여Ground-Truth Answer Positions에서Teacher와Student의 예측 분포 간KL Divergence를 최소화하는 방식입니다 [cite: 1, Figure 2].
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Multimodal Large Language Models (MLLMs)에서 고해상도 이미지 및 비디오와 같은 긴 Visual Token 시퀀스로 인해 발생하는 막대한 계산 오버헤드 문제를 해결하고자 한다. 현재 MLLMs의 뛰어난 성능은 모든 Transformer 레이어에서 Visual Tokens가 반복적인 계산에 참여하기 때문에 상당한 Computational Overhead를 수반하며, 이는 Scalable Multimodal Inference의 중요한 도전 과제이다. 기존 접근 방식인 Visual Token Pruning은 중복 Visual Token을 제거하여 비용을 줄이지만, 이 과정에서 후속 레이어에서 유용할 수 있는 시각적 증거가 영구적으로 손실되는 결정적인 한계가 있다. 저자들은 이러한 Visual Token Pruning의 대안으로, 모든 Visual Token을 보존하면서도 LLM 내에서의 처리 비용을 줄이는 보완적인 방향을 탐색한다. 초기 분석을 통해, Visual-to-Text Attention이 차단된 상황에서 소수의 Directions만으로도 대부분의 Lost Accuracy가 회복되는 것을 확인하였으며, 이는 관련 시각적 영향이 Low-Dimensional Subspace에 집중되어 있음을 시사한다 [cite: 1, Figure 1]. 또한, Layer-Specific Visual States가 강한 예측 가능성을 보이며 경량 MLPs로 효과적으로 근사될 수 있다는 사실을 발견하여, 모든 Transformer 레이어에서 Full-Dimensional Visual States를 반복적으로 계산할 필요가 없음을 제안한다 [cite: 1, Figure 1].
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 앞선 분석 결과에 기반하여 δ-Vision을 제안하며, 이는 Visual Token의 기존 Transformer 업데이트 경로를 경량의 Low-Rank Adapters를 통한 Layer-Wise Visual Memory Prediction으로 대체한다 [cite: 1, Figure 2]. δ-Vision의 핵심은 Language Model Backbone을 Frozen 상태로 유지하면서, 각 Transformer 레이어에 필요한 Visual Memory (Ml)를 Low-Rank Adapter가 직접 구축한다는 점이다 [cite: 1, Figure 2]. 이 Visual Memory는 Read-Only Key-Value Context로 Textual Stream에 제공되어, 텍스트 쿼리가 모든 Visual Token에 계속 접근할 수 있도록 하면서도 Visual Queries, Visual Attention Outputs, Visual Feed-Forward Updates 등 불필요한 계산을 제거한다. Visual Memory 구축을 위해 Embedding Adapter와 Recurrent Adapter 두 가지 변형을 개발했는데, Embedding Adapter는 초기 Visual Embeddings에서 각 레이어의 Visual Memory를 직접 예측하고, Recurrent Adapter는 이전 Visual Memory로부터 점진적으로 업데이트한다 [cite: 1, Figure 2]. Training Objective로는 Supervised-KD를 사용하여 Frozen Backbone의 Output Behavior를 보존하도록 Adapter 파라미터만 최적화한다.
광범위한 실험 결과, δ-Vision은 다양한 MLLM Backbones와 이미지, Multi-Image, 비디오 벤치마크에서 강력한 Accuracy-Efficiency Trade-off를 입증했다. Qwen3-VL-4B 모델에서 δ-Vision (Embedding Adapter)은 평균 74.4점을 달성하며, 5% Visual Token Retention의 최강 Pruning Baseline인 DivPrune보다 9.1점 높은 Average Score를 기록했다 [cite: 1, Table 1]. 이는 20% Visual Token Retention에서 얻은 최상의 Pruning 결과와 유사하거나 더 나은 성능이다 [cite: 1, Table 1]. 효율성 측면에서 Video-MME 벤치마크를 통해 δ-Vision은 Uncompressed Model FLOPs의 17.90%만을 사용하며, 1.30배의 Total Speedup과 1.50배의 Prefill Speedup을 달성했다 [cite: 1, Table 2]. 이는 모든 Visual Token을 보존함에도 불구하고 Token-Pruning Baselines와 동등하거나 우수한 Prefill Efficiency를 보여준다 [cite: 1, Table 2]. 또한, Adapter Rank가 증가할수록 다운스트림 정확도가 완만하게 향상되는 경향을 보이며, 이는 Layer-Specific Visual-State Corrections 모델링에 추가 Capacity를 제공함을 시사한다 [cite: 1, Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Multimodal Large Language Models (MLLMs)에서 Visual Tokens가 Full Transformer Evolution을 거쳐야 한다는 기존의 가정에 이의를 제기하며, Layer-Wise Visual Representations가 Hidden-Channel Dimension에서 상당한 Redundancy와 Predictability를 가진다는 것을 실증적으로 보여주었다. 이러한 핵심 발견을 기반으로 저자들은 δ-Vision이라는 새로운 Visual Memory Prediction Framework를 제안하였다. δ-Vision은 모든 Visual Token을 Text Retrieval에 활용하면서도 Lightweight Low-Rank Adapters를 통해 Visual States를 효율적으로 재구성함으로써, Visual Token Pruning 방식과 유사하거나 더 낮은 Computational Budget에서 우수한 Accuracy-Efficiency Trade-off를 달성한다. 이 연구는 Multimodal Inference Cost 절감이 반드시 Visual Token 제거를 통해서만 이루어지는 것이 아님을 시사하며, Visual States의 효율적인 구축이 Sequence-Length Reduction과 상보적인 Efficiency Axis를 제공함을 보여준다. 이는 Scalable MLLMs 개발을 위한 새로운 연구 방향을 제시하며, 향후 Multimodal Language Model의 성능 향상과 자원 효율성 최적화에 중요한 영향을 미칠 것으로 기대된다.
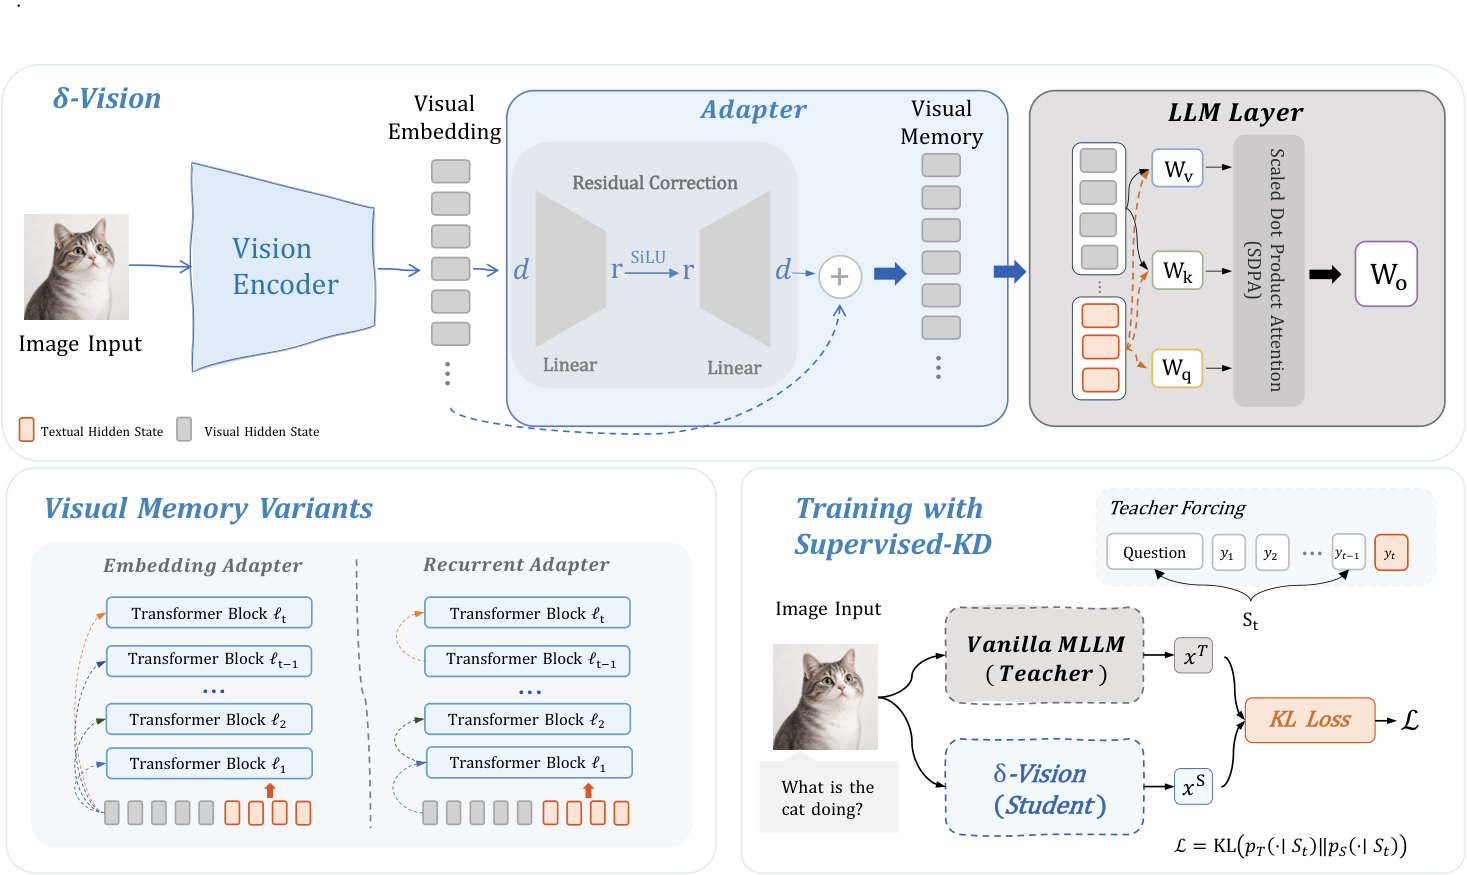
Figure 2 — δ-Vision 전체 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AdaCodec: A Predictive Visual Code for Video MLLMs
- [논문리뷰] R-4B: Incentivizing General-Purpose Auto-Thinking Capability in MLLMs via Bi-Mode Annealing and Reinforce Learning
- [논문리뷰] Fewer Tokens, More Self-Teaching: On-Policy Self-Distillation for Extreme Visual Token Reduction
- [논문리뷰] DeltaWAM: Delta World Action Models for Bimanual Manipulation
- [논문리뷰] Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents
Review 의 다른글
- 이전글 [논문리뷰] InfiniHand: Streaming World-Space Hand Motion Estimation from Egocentric Video
- 현재글 : [논문리뷰] Just MLPs: Efficient Visual State Reconstruction for Multimodal Language Models
- 다음글 [논문리뷰] Knowing When Thinking Is Not Enough: Teaching Small Reasoning Models to Reason Beyond Their Parametric Knowledge
댓글