[논문리뷰] Knowing When Thinking Is Not Enough: Teaching Small Reasoning Models to Reason Beyond Their Parametric Knowledge
링크: 논문 PDF로 바로 열기
저자: Chanuk Lee, Minki Kang, Sangwoo Park, Woongyeong Yeo, Jinheon Baek, Sung Ju Hwang
1. Key Terms & Definitions
- Small Reasoning Models (sRMs): 서비스 비용이 저렴하지만, 대규모 모델에 비해 추론 능력과 파라메트릭 지식이 부족한 소형 언어 모델입니다.
- Execution Bottleneck: 모델 자체의 추론 과정을 통해 올바른 솔루션에 도달할 수 있지만, 모델이 이를 안정적으로 실현하지 못하는 추론 실패 상태를 의미합니다.
- Knowledge Bottleneck: 올바른 솔루션에 필요한 정보가 모델의 내부 추론만으로는 안정적으로 접근, 재구성 또는 활용될 수 없는 추론 실패 상태를 지칭합니다.
- Epistemic Verbalizations (EVs): 모델이 자신의 추론을 재고하기 위해 잠시 멈출 때 사용하는 "wait", "hmm", "alternatively"와 같은 짧은 불확실성 표현 또는 확인 표현입니다.
- Selective Querying: sRM이 먼저 추론을 수행한 후, 해결되지 않은 부분을 진단하고, 지식 병목 현상이 발생했을 때 자체 파라메트릭 지식 범위를 넘어서는 더 강력한 외부 모델에 선별적으로 질의하는 프레임워크입니다.
2. Motivation & Problem Statement
본 논문은 테스트 타임 컴퓨테이션(test-time computation) 확장이 언어 모델 추론 성능 향상에 강력한 방법임에도 불구하고, 소형 추론 모델(sRMs)에서는 그 효과가 항상 충분하지 않다는 핵심 문제를 제기합니다. 기존 sRMs의 자가 개선(self-refinement) 방식은 주로 모델이 이미 도달 가능한 솔루션을 통합하는 데 그쳐, 파라메트릭 지식(parametric knowledge)의 부족으로 인한 한계를 해결하지 못합니다. 저자들은 추론 실패를 크게 두 가지 유형, 즉 올바른 경로가 내부적으로 도달 가능하여 추가 연산으로 해결될 수 있는 Execution Bottlenecks와 외부 정보가 필요한 Knowledge Bottlenecks로 구분합니다 [Figure 1]. 기존 시스템들은 외부 도움 요청 시 명시적인 병목 현상 진단 없이 도구 사용을 최적화하여, 외부 자원 사용의 비효율성을 초래했습니다. 따라서 저자들은 sRM이 추론 과정에서 이러한 병목 현상을 진단하고, 필요에 따라 적절한 수준의 외부 컴퓨테이션을 활용하여 필요한 정보를 획득할 수 있는지에 대한 질문을 중심으로 연구를 진행합니다.
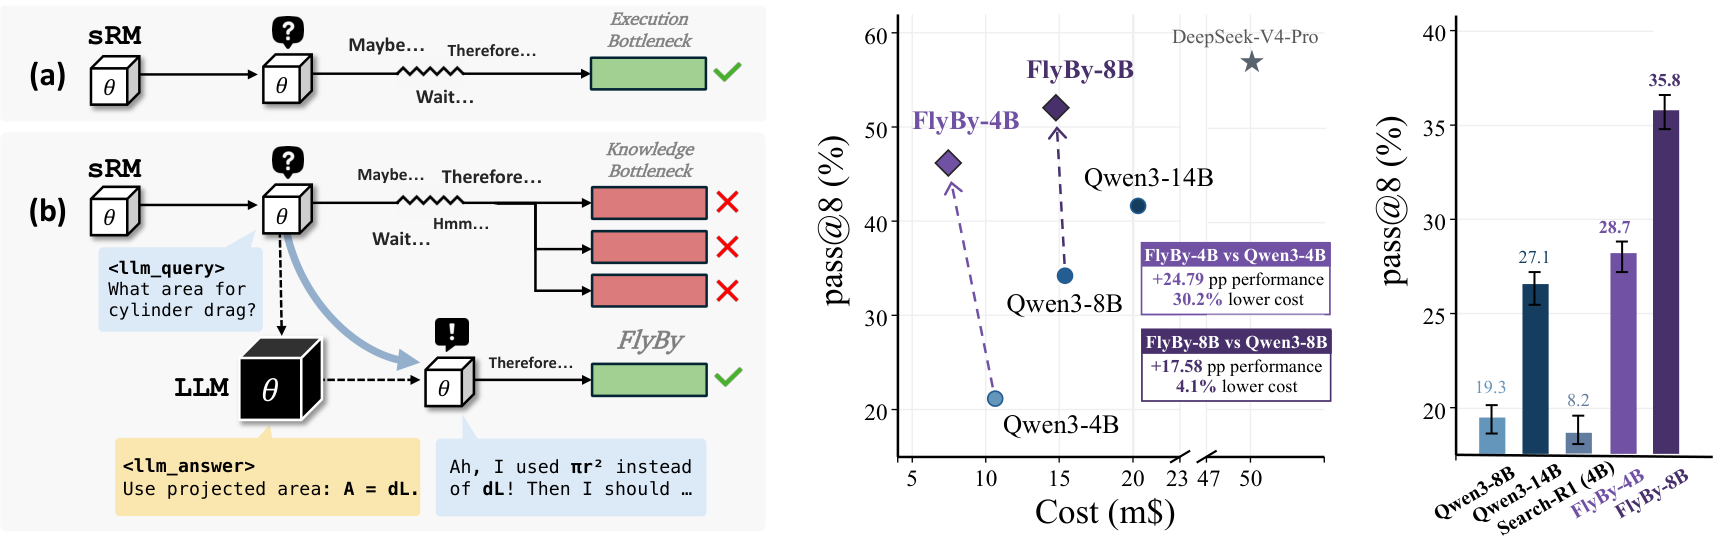
Figure 1 — FlyBy 프레임워크 개요
3. Method & Key Results
저자들은 sRM이 Knowledge Bottleneck에 도달했을 때 외부 모델로부터 누락된 지식을 선택적으로 습득하도록 훈련하는 FlyBy 프레임워크를 제안합니다. 이 방법론은 sRM이 먼저 로컬 추론을 수행하고, 해결되지 않은 문제를 진단한 다음, 외부 모델에 multi-depth query 액션을 사용하여 질의할지, 무엇을 질문할지, 그리고 얼마만큼의 외부 컴퓨테이션을 사용할지를 결정하게 합니다. 외부 모델은 질의만 볼 뿐 원본 문제를 알 수 없으며, sRM은 받은 정보를 바탕으로 추론을 재개합니다. FlyBy의 훈련은 두 단계로 이루어집니다: 첫째, 성공적인 구조 궤적(rescue trajectories)을 활용한 Supervised Fine-tuning (SFT)을 통해 질의 액션 공간을 부트스트랩합니다. 둘째, 비용 인지 강화 학습(cost-aware Reinforcement Learning, RL)을 적용하여 질의의 가치와 컴퓨테이션 할당량을 보정합니다. RL 목표 함수는 성공적인 궤적에 대해서만 비용 페널티를 부과하여, 효율적인 외부 정보 획득을 장려합니다.
실험 결과, FlyBy-4B는 6가지 벤치마크의 1,158개 고난도 문제에서 45.96% pass@8 성능을 달성했으며, 이는 Qwen3-14B (41.64%)를 능가하면서도 2.7배 낮은 (2.7× lower) 서빙 비용을 기록했습니다 [Table 2]. 또한, FlyBy-4B는 pass@1에서도 Qwen3-8B (15.31%)를 16.85%로 앞섰습니다. 특히, 학습된 질의 정책은 추가 내부 추론이 비효율적인 지점에서 정확하게 질의하는 경향을 보였으며, 이는 평균적으로 상태 값(state value)을 5.30 pp 증가시켰습니다 [Figure 6(a)]. RL은 SFT가 단일 질의 행동만 학습했음에도 불구하고, 모델이 다중 턴(multi-turn)에 걸쳐 반복적인 질의를 수행하도록 유도했으며 [Figure 6(b)], 적응형 깊이 할당(adaptive depth allocation)을 통해 거의 최상위 백엔드 성능을 최하위 백엔드 비용으로 달성했습니다 [Figure 6(c)]. FlyBy-8B로 스케일링했을 때는 pass@8이 51.81%로 더욱 향상되었습니다 [Table 2].
4. Conclusion & Impact
본 논문은 소형 추론 모델이 추가적인 내부 추론만으로 문제 해결에 실패하는 상황을 분석하며, "생각만으로는 충분하지 않을 때"를 아는 것의 중요성을 강조합니다. 저자들은 추론 실패를 내부적 자가 개선으로 회복 가능한 Execution Bottlenecks와 외부 정보가 필수적인 Knowledge Bottlenecks로 명확히 구분했습니다. 이러한 구분을 기반으로, 제안된 FlyBy 프레임워크는 sRM이 병목 현상을 효과적으로 진단하고, 필요한 외부 컴퓨테이션을 선택적으로 활용하여 상당한 성능 향상과 비용 효율성을 달성함을 입증했습니다. 이 연구는 더 강력하고 경제적인 sRM 개발에 중요한 시사점을 제공하며, sRM이 대규모 모델의 성능 격차를 줄이고, 적응적이고 효율적인 AI 추론 시스템을 구축하는 데 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DIVE: Scaling Diversity in Agentic Task Synthesis for Generalizable Tool Use
- [논문리뷰] DeepEyesV2: Toward Agentic Multimodal Model
- [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
- [논문리뷰] ScienceIDE: Turning World's Scientific Codebase into Agent Learnable Environments
- [논문리뷰] ARC: Fair Relative Advantage Comparison in Open-Ended Real-World Interaction
Review 의 다른글
- 이전글 [논문리뷰] Just MLPs: Efficient Visual State Reconstruction for Multimodal Language Models
- 현재글 : [논문리뷰] Knowing When Thinking Is Not Enough: Teaching Small Reasoning Models to Reason Beyond Their Parametric Knowledge
- 다음글 [논문리뷰] Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning
댓글