[논문리뷰] Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features
링크: 논문 PDF로 바로 열기
저자: Cunchun Li, Haonan He, Yifan Gao, Minglei Li, Jingqi Ye, Qingyu Yang, Peng Ye
1. Key Terms & Definitions (핵심 용어 및 정의)
- SCALE: 본 논문에서 제안하는 Selective Control of Adaptation via Local Entropy 기법으로, SFT 이후 학습된 LoRA delta를 freeze한 상태에서 entropy-guided gate를 통해 최적화하는 방법론입니다.
- Token Reweighting: SFT 과정에서 특정 token의 학습 기여도를 조절하는 기법으로, 기존 연구들은 비음수(nonnegative) 가중치만을 사용하여 한계가 있습니다.
- Suppression, Reversal, Extrapolate: SCALE이 수행하는 세 가지 delta 제어 방식으로, 각각 학습된 delta의 기여도를 감소(0~1), 반전(<0), 과장(>1)하는 것을 의미합니다.
- Predictive Entropy: 모델의 불확실성을 측정하는 지표로, SCALE에서는 이를 gate 최적화를 위한 핵심 신호(signal)로 활용합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 SFT(Supervised Fine-tuning) 방식이 모든 토큰을 동일하게 처리함으로써 발생하는 overfitting 및 노이즈 증폭 문제를 해결하고자 합니다. 기존의 Token-level reweighting 기법들은 가중치를 비음수 값으로 제한하여 학습된 delta의 영향력을 조절할 뿐, 잘못 학습된 특징을 역전(Reverse)하거나 부족한 특징을 확장(Extrapolate)하는 데는 한계가 있습니다. 특히 기존 기법들은 학습 도중에 개입하여 최적화 궤적을 변화시키지만, 저자들은 이미 완료된 SFT 결과를 바탕으로 특징을 사후 제어(post-hoc control)하는 프레임워크가 필요하다고 주장합니다. 이를 위해 SCALE은 모델의 불확실성을 활용하여 고정된 delta를 정교하게 조정하는 방식을 제안합니다 [Figure 1].
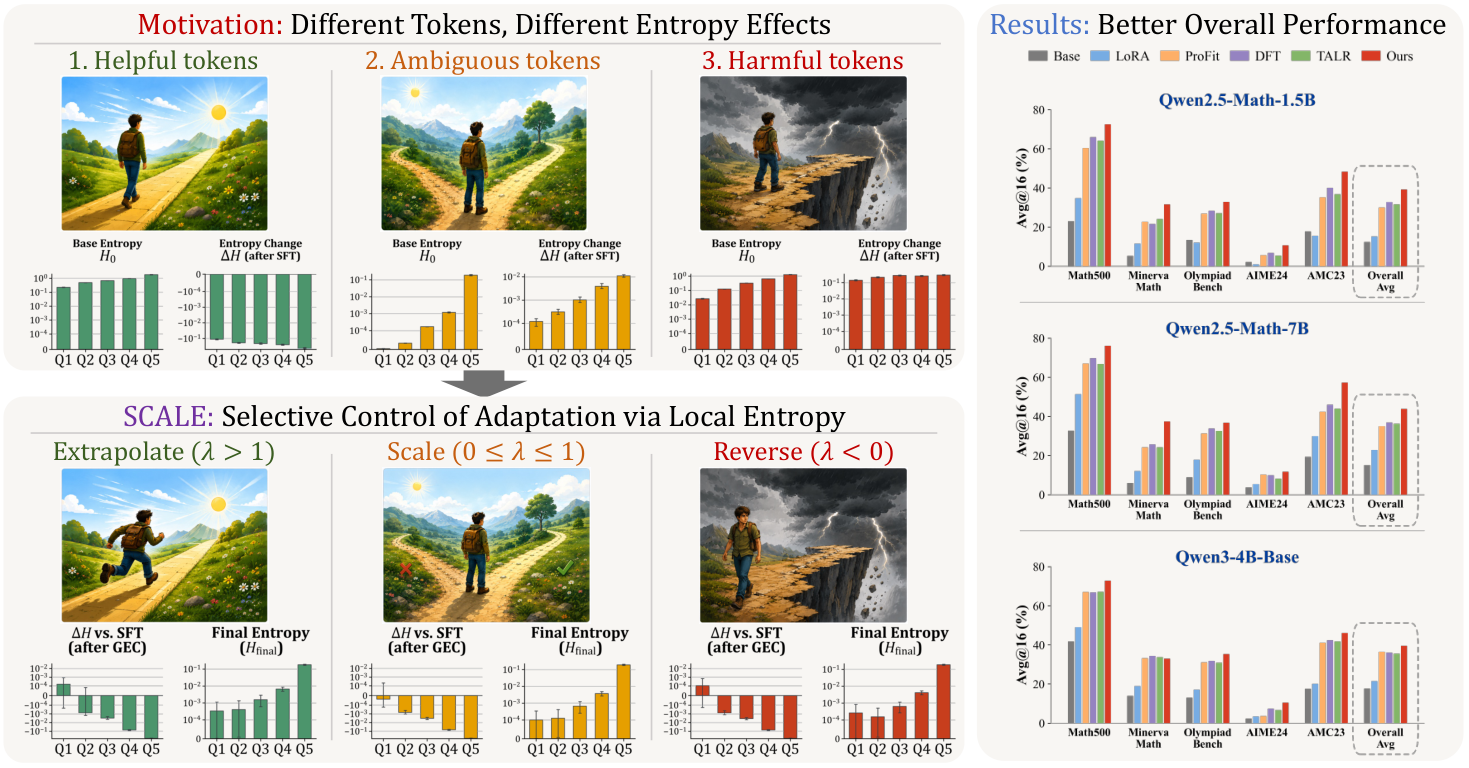
Figure 1 — SCALE 모델의 작동 원리
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문이 제안하는 SCALE은 두 단계로 구성됩니다: 첫째, 표준 SFT를 통해 LoRA adapter를 학습시키고 이를 고정합니다. 둘째, 입력 토큰 및 모듈별로 독립적인 signed gates ($\lambda_{\ell,t}$)를 도입하여, 고정된 delta의 영향력을 suppression, reversal, extrapolation을 통해 최적화합니다. 이 gate들은 모델의 predictive entropy를 최소화하는 방향으로만 학습되며, 어떠한 외부 라벨 없이 오직 entropy reduction을 지향합니다. 실험 결과, SCALE은 Qwen2.5-Math-1.5B/7B 및 Qwen3-4B-Base 모델에서 수학적 추론 능력을 각각 37.84, 43.60, 36.57로 개선하여 기존 baseline인 DFT를 큰 폭으로 상회했습니다. 또한, HumanEval, HumanEval+, MBPP를 포함한 코드 생성 벤치마크에서도 일관되게 가장 우수한 평균 성능을 기록하며, 모델의 범용적 성능(general retention)을 유지하면서 특정 도메인의 adaptation을 극대화함을 입증했습니다 [Table 1], [Table 2].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 SFT에서 학습된 잔차(residual)를 단순히 그대로 적용하는 것이 아니라, 이를 사후적으로 제어하는 것이 성능 향상에 필수적임을 성공적으로 입증했습니다. SCALE은 별도의 복잡한 학습 과정 없이도 entropy-guided gating을 통해 모델의 특징 추출 방향성을 정교하게 교정할 수 있음을 보여줍니다. 이러한 접근 방식은 향후 LLM post-training 파이프라인에서 adaptation의 유연성과 효율성을 극대화하는 새로운 표준이 될 것으로 기대됩니다. 또한, 도메인 특화 모델 개발 시 불필요한 feature overwriting을 방지하는 실용적인 대안을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SearchInstruct: Enhancing Domain Adaptation via Retrieval-Based Instruction Dataset Creation
- [논문리뷰] Memory as Weights: Internalizing Long-Term History for Streaming Videos
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- [논문리뷰] Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance
- [논문리뷰] X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
Review 의 다른글
- 이전글 [논문리뷰] RealCompanion: Benchmarking Human Understanding from Reasoning over Longitudinal Real-World Conversations
- 현재글 : [논문리뷰] Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features
- 다음글 [논문리뷰] Rollout-Marginal Distillation for Long-Horizon Autoregressive Video Generation
댓글