[논문리뷰] DiVeR: Decision-Critical Verifier Learning for VLA Test-Time Scaling
링크: 논문 PDF로 바로 열기
메타데이터
저자: Seongheon Park, Heecheol Kim, Shulin Tian, Lilika Makabe, Namiko Saito, Katsushi Ikeuchi, Sharon Li, Yasuyuki Matsushita
1. Key Terms & Definitions (핵심 용어 및 정의)
- VLA (Vision-Language-Action) Models: 멀티모달 데모 데이터를 학습하여 범용적인 로봇 정책을 수행하는 모델로, 본 논문에서는 고정된(frozen) 확률적 행동 생성기로 활용됩니다.
- Test-Time Scaling: 모델을 재학습하거나 데모 데이터를 추가하지 않고, 추론 시점에 여러 행동 후보를 샘플링하고 최적의 후보를 선택함으로써 성능을 개선하는 프레임워크입니다.
- Decision-Critical States: 행동 선택이 로봇의 최종 작업 성공 여부에 결정적인 영향을 미치는 상태를 의미하며, 일반적으로 샘플링된 행동 간의 차이가 큰 상태를 뜻합니다.
- Action-Expert Representation: VLA 모델 내부의 행동 전문가(Action-Expert)로부터 추출된 은닉 표현(Hidden Representation)으로, 후보 행동 간의 변동성(Dispersion)을 측정하여
Decision Criticality를 추정하는 데 사용됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 VLA 모델의 Test-Time Scaling 과정에서 기존의 분류 기반 Verifier가 모든 상태를 동일하게 학습하는 비효율성을 해결하고자 합니다. 기존 연구들은 전체 궤적의 성공/실패 결과만으로 Verifier를 학습시키는데, 이는 단순 동작(Routine states)과 결정적인 상태(Decision-critical states)를 구분하지 않아 결과적으로 중요도가 높은 상태의 학습 신호가 희석되는 문제를 야기합니다 [Figure 1]. 따라서 저자들은 작업 결과에 실질적인 영향을 미치는 sparse한 결정적 상태에 학습을 집중시키는 새로운 방법론의 필요성을 제기합니다.
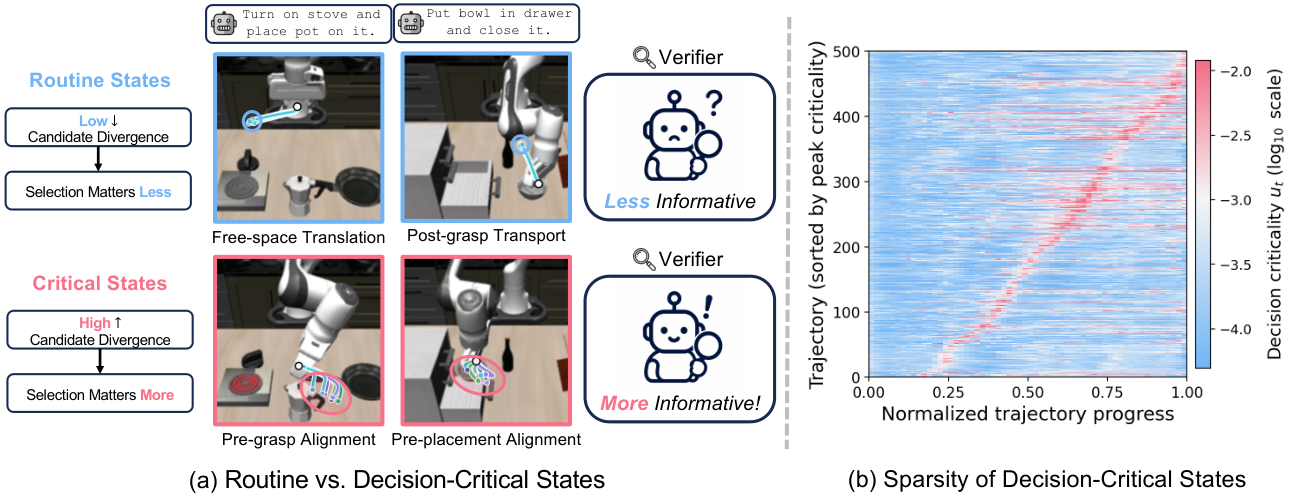
Figure 1 — Routine vs Critical 상태 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 DiVeR (Decision-criticality-weighted Verifier)를 제안하여, 고정된 VLA 모델에서 샘플링된 행동 후보들의 Action-Expert Representation 분산(Dispersion)을 통해 Decision Criticality를 추정합니다 [Figure 2]. 이 criticality 점수를 바탕으로 학습 데이터의 각 상태에 가중치(Weighting)를 부여하여, 후보 행동 간 차이가 뚜렷하여 의사결정이 중요한 상태의 학습 기여도를 높이는 Decision-weighted binary cross-entropy 손실 함수를 설계하였습니다 [Figure 3]. 실험 결과, DiVeR는 LIBERO, RoboCasa, 실제 Franka Research 3 로봇 환경에서 기존 베이스라인 대비 유의미한 성능 향상을 달성하였습니다 [Table 1, Table 3]. 특히 π0.5 정책 기준, 기존 베이스라인 대비 작업 성공률을 최대 +13.6% 개선하였으며, 기존의 VLM 기반 Verifier와 비교하여 성능은 +4.6% 우수하면서도 추론 지연 시간(Inference Latency)은 700배 이상 단축하는 성과를 보였습니다 [Table 3, Table 6].
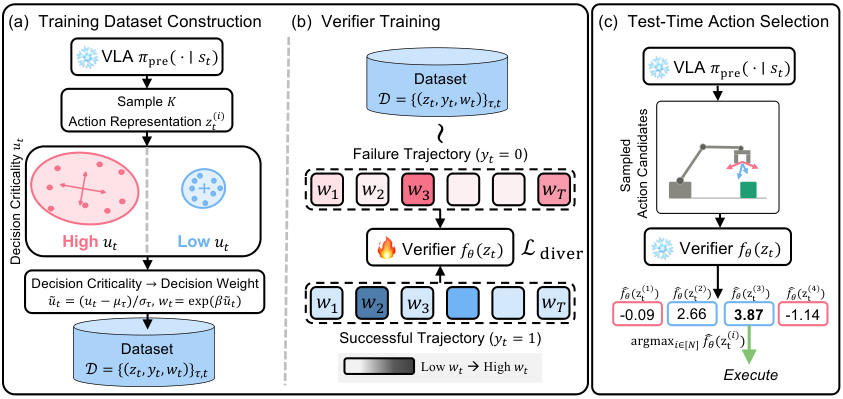
Figure 2 — DiVeR 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 로봇 제어의 Test-Time Scaling에서 '모든 상태가 동일하게 중요하지 않다'는 핵심 통찰을 바탕으로, 효율적이고 강력한 DiVeR 프레임워크를 정립하였습니다. 제안 방법은 복잡한 환경에서 별도의 단계별 주석(Step-level annotation) 없이도 모델의 내재적 변동성만을 활용하여 성공적인 행동 선택을 유도한다는 점에서 높은 실용성을 가집니다. 이 연구는 범용 로봇 정책이 적은 연산 자원으로도 고도의 작업 성공률을 달성하게 함으로써, 로봇 자동화 및 실환경 배치 분야의 효율성을 크게 향상시킬 것으로 기대됩니다.
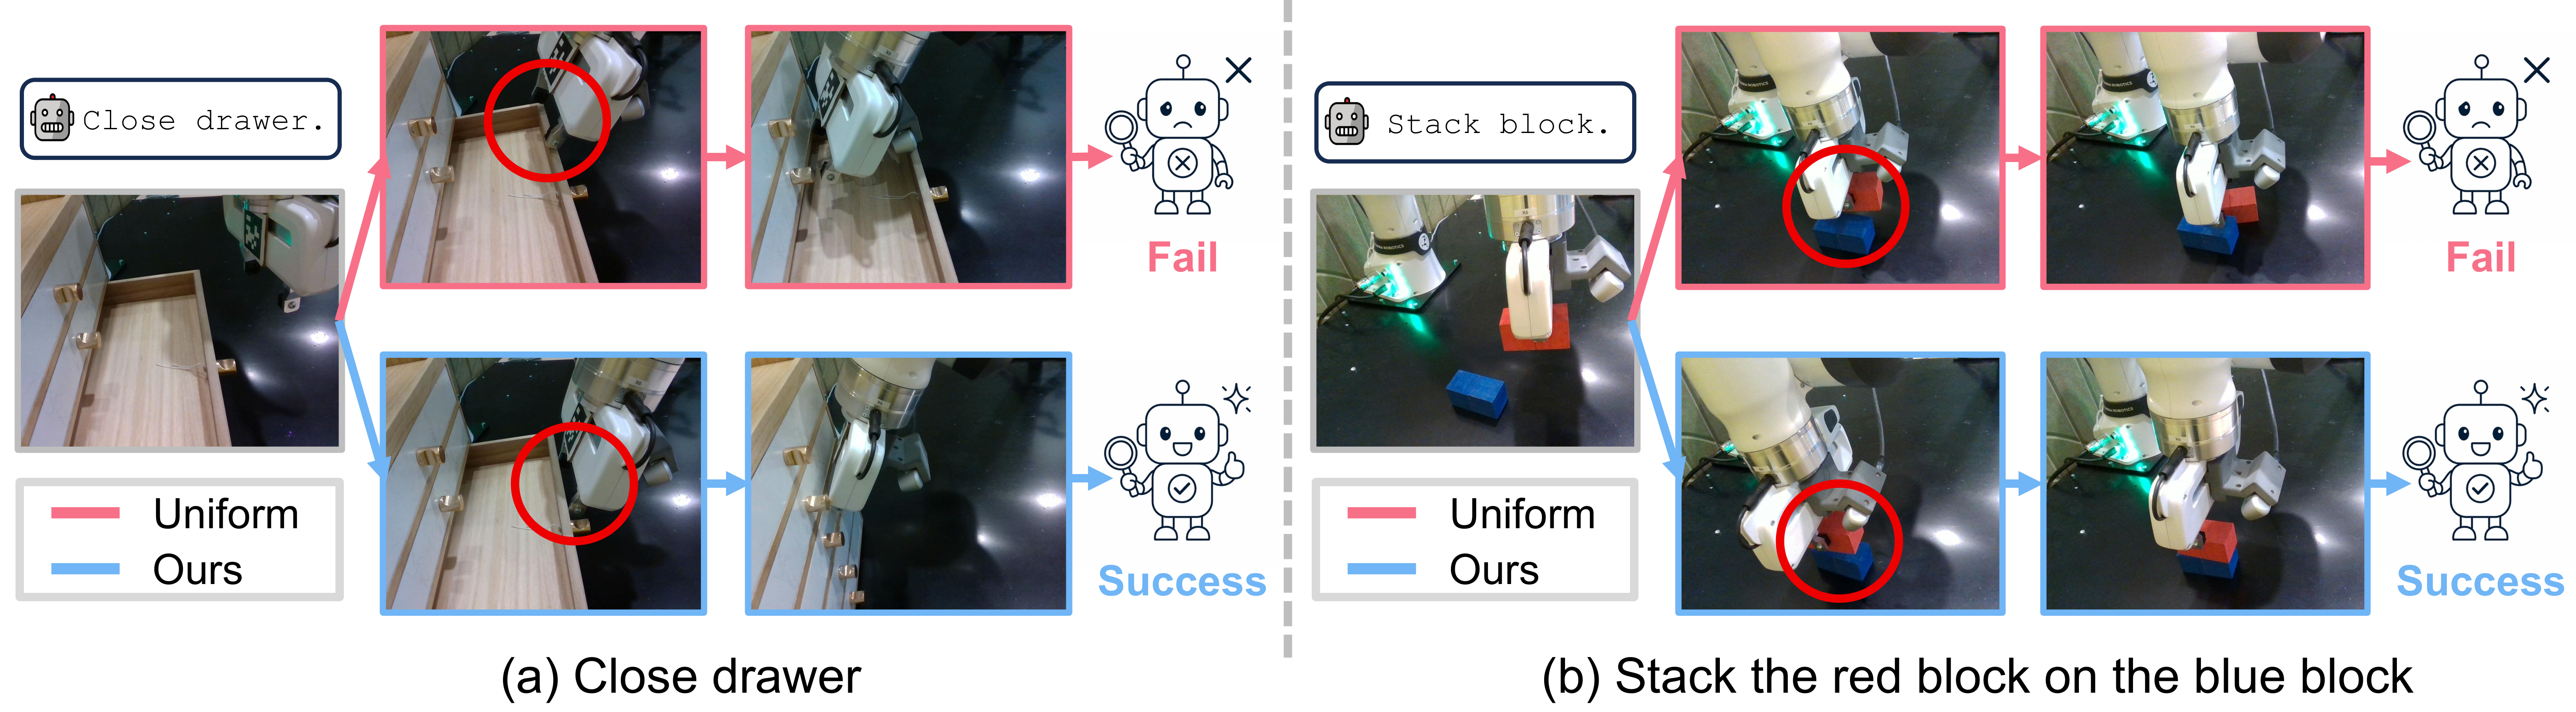
Figure 5 — 정성적 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
- [논문리뷰] RoboFollow: Unveiling the Instruction Following Mirage in Embodied Agents
- [논문리뷰] DreamX-Phi 1.0: Action-Conditioned Video World Model for Robotic Manipulation
- [논문리뷰] RL^2-VLA: Adaptive RL Latent Compositional Steering with Test-Time Scaling for Vision-Language-Action Models
- [논문리뷰] TurboVLA: Real-Time Vision-Language-Action Model at 32 Hz on an RTX 4090 with <1 GB VRAM
Review 의 다른글
- 이전글 [논문리뷰] DAEDALUS: Bootstrapping Agent Memory from Self-Generated Tasks
- 현재글 : [논문리뷰] DiVeR: Decision-Critical Verifier Learning for VLA Test-Time Scaling
- 다음글 [논문리뷰] DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
댓글