[논문리뷰] Chaos in the Text: Revealing the Modality Preference in Mixed-Modality Retrievers
링크: 논문 PDF로 바로 열기
저자: Yubo Sun, Chunyi Peng, Yukun Yan, Zhenghao Liu, Zhipeng Xu, Sen Mei, Linlin Xin, Zheni Zeng, Maosong Sun
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Chaos in the Text: 혼합 모달리티 말뭉치(Mixed-modality corpora)에서 관련성이 낮은 텍스트 문서가 관련성이 높은 이미지 문서를 순위에서 밀어내는 현상을 지칭합니다.
- Modality Preference: 검색 모델이 문서의 의미적 관련성보다 특정 모달리티(특히 텍스트)에 편향되어 더 높은 유사도 점수를 부여하는 체계적인 편향성을 의미합니다.
- Trident: 다중 긍정 뷰(text, image, fused)를 활용한 대조 학습 프레임워크로, 모달리티 간의 균형을 맞추어 모달리티 편향을 완화하는 모델입니다.
- Multi-Positive View InfoNCE: Trident에서 사용하는 손실 함수로, relevance discrimination과 positive-view balance를 통해 모달리티 간 점수 분포를 정규화합니다.
- NDCG@10: 모델의 검색 성능을 평가하는 주요 지표로, 관련성 순위의 정확도를 측정합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존의 멀티모달 검색 모델이 단일 모달리티 환경에서는 우수한 성능을 보이지만, 실제 환경과 같은 혼합 모달리티 말뭉치에서는 성능이 급격히 저하되는 구조적 한계를 해결하고자 합니다. 저자들은 이미지 문서와 텍스트 문서를 섞었을 때 검색 성능이 V-자 형태로 저하되는 현상을 발견했으며, 이는 검색 모델이 데이터의 의미적 관련성보다 문서의 모달리티를 먼저 판별하여 텍스트에 부당한 가중치를 부여하기 때문임을 밝혔습니다. 특히 [Figure 1]에서 볼 수 있듯이, 동일한 의미를 가진 문서임에도 불구하고 모달리티 구성이 변함에 따라 NDCG@10 성능이 0.94에서 0.65까지 급락하는 등, 모달리티 구성에 매우 민감한 모습을 보입니다. 이러한 현상은 관련 있는 이미지 정보를 Top-K 순위에서 밀어내게 되며, 기존의 일반적인 dense retriever들이 혼합 모달리티 설정에서 신뢰할 수 없는 검색 결과를 제공하는 주요 원인이 됩니다.
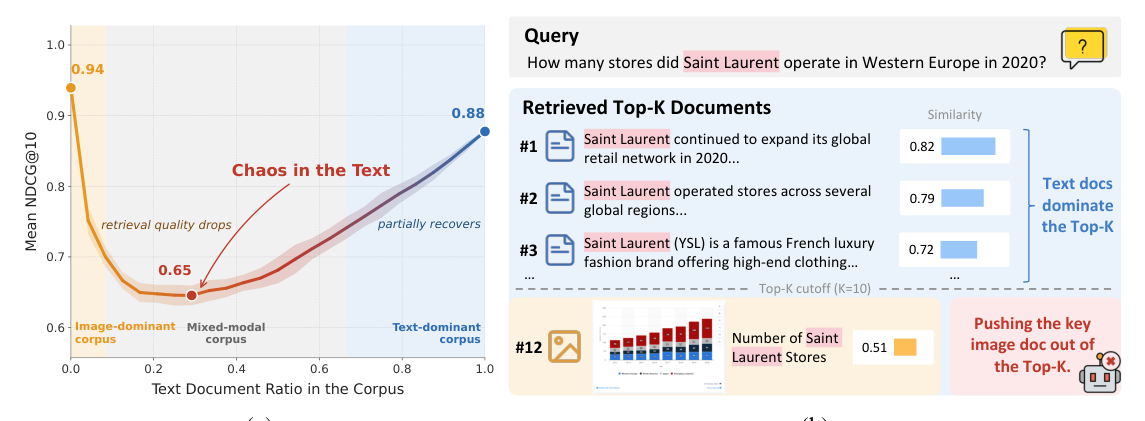
Figure 1 — 혼합 모달리티 환경에서 검색 성능의 급격한 저하와 텍스트 도미넌스 현상을 보여주는 핵심 동기
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 저자들은 이러한 모달리티 편향을 극복하기 위해 문서의 텍스트, 이미지, 그리고 이 둘이 결합된 퓨즈드(fused) 뷰를 3개의 동등한 긍정적 샘플(positive views)로 간주하는 Trident 학습 프레임워크를 제안합니다. Trident는 Multi-Positive View InfoNCE 손실 함수를 통해 각 모달리티의 점수를 공유된 정규화 공간에서 비교함으로써, 특정 모달리티에 확률 질량이 쏠리는 것을 방지하고 relevance discrimination을 강화합니다. [Table 1]에 따르면, Trident는 다양한 CLIP 기반 및 VLM 기반 아키텍처에서 기존 baselines 대비 훨씬 안정적인 검색 성능을 보여줍니다. 예를 들어, 혼합 모달리티(Mix) 데이터셋에서 Trident-JinaCLIP은 55.51의 평균 NDCG@10을 기록하여 기존 대비 압도적인 성능 향상을 보였고, VLM 기반 모델에서도 Trident-Qwen3VL-2B가 73.90을 달성하며 성능 우위를 입증했습니다. 이는 [Figure 6]에서 확인할 수 있듯이 기존 모델들이 보이던 성능 저하 구간(valley)이 학습 후 크게 완화되고 검색 성능의 편차가 줄어들어 모달리티 구성에 훨씬 견고해졌음을 의미합니다.
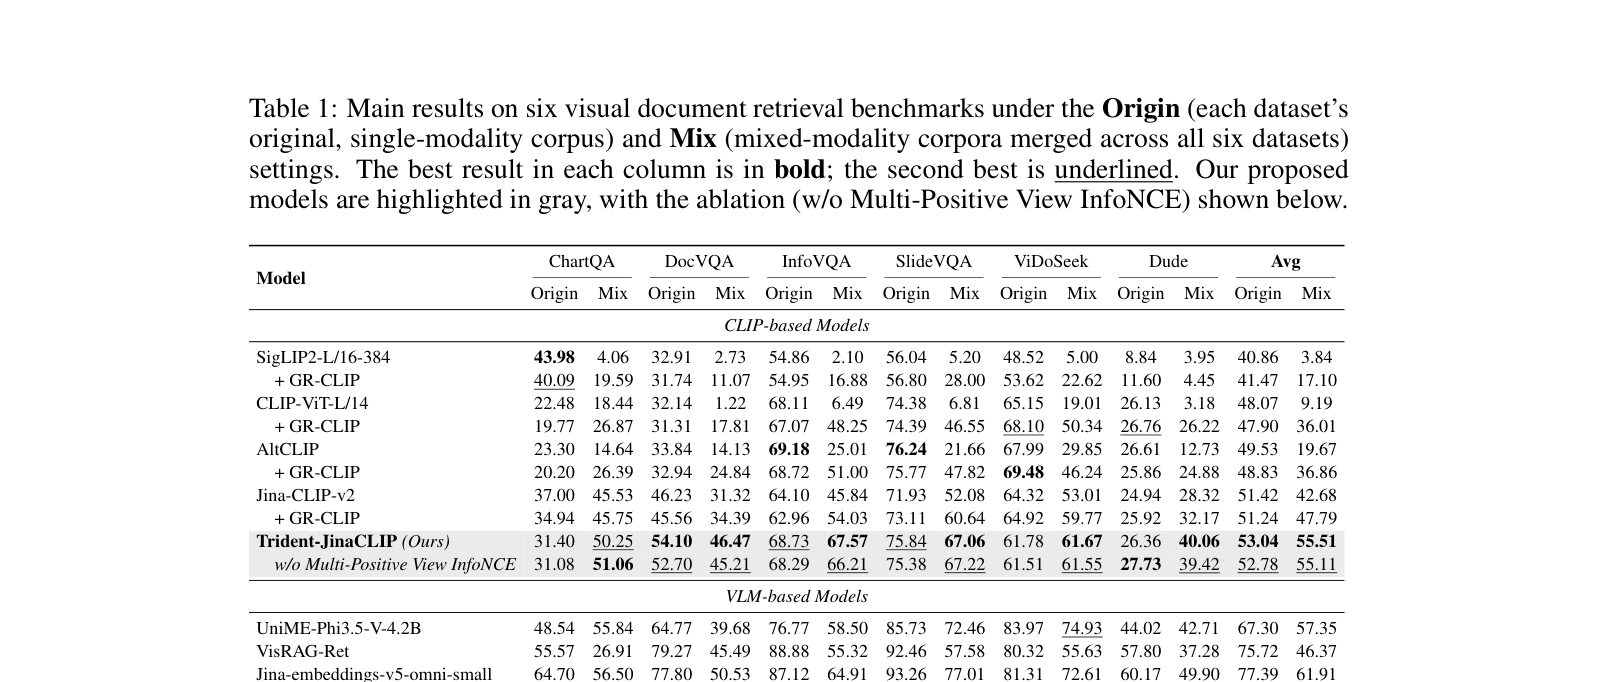
Table 1 — 제안 모델 Trident와 기존 모델들의 벤치마크 성능 비교
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 멀티모달 검색 모델의 핵심 취약점인 'Chaos in the Text' 현상을 정의하고 이를 해결하기 위한 모달리티 균형 학습 기법인 Trident를 제시함으로써 멀티모달 정보 검색 분야의 robustness를 한 차원 높였습니다. 이 연구는 단순히 geometric gap을 줄이는 것을 넘어, 실제 검색 순위에 영향을 주는 모델 내재적 모달리티 선호 현상을 직접적으로 완화한다는 점에서 큰 학술적 기여를 합니다. 향후 멀티모달 RAG 시스템이나 다양한 혼합 데이터 환경을 활용하는 대규모 검색 시스템 설계 시, Trident의 모달리티 균형 학습 방법론은 필수적인 지침이 될 것으로 기대됩니다.
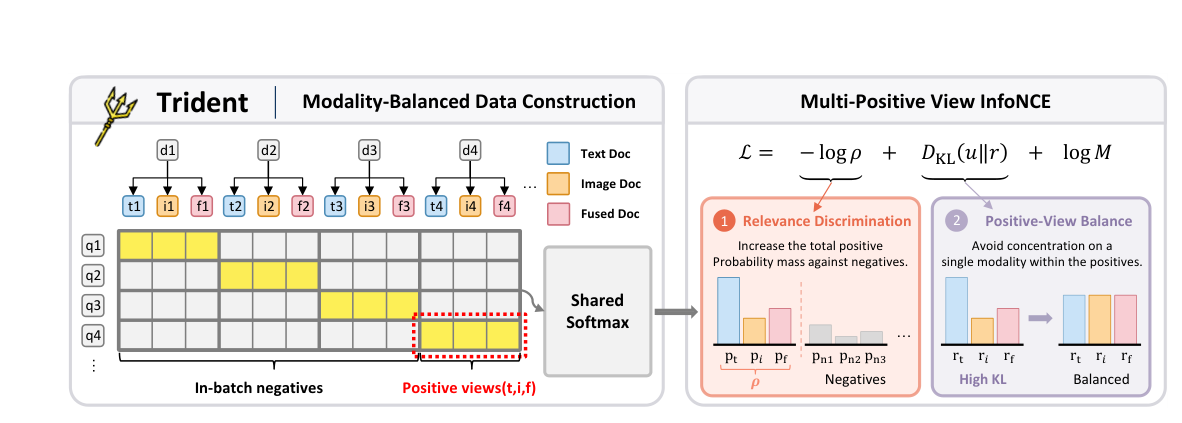
Figure 5 — Trident의 다중 모달리티 학습 프레임워크 및 손실 함수 구조를 설명하는 핵심 다이어그램
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Your Embedding Model is SMARTer Than You Think
- [논문리뷰] Qwen3-VL-Embedding and Qwen3-VL-Reranker: A Unified Framework for State-of-the-Art Multimodal Retrieval and Ranking
- [논문리뷰] Towards Mixed-Modal Retrieval for Universal Retrieval-Augmented Generation
- [논문리뷰] FG-CLIP 2: A Bilingual Fine-grained Vision-Language Alignment Model
- [논문리뷰] Harness^2: Recursive Agent Harnessing for an Open World
Review 의 다른글
- 이전글 [논문리뷰] Can AI Agents Make Open-Ended Scientific Discovery? Evidence from Station
- 현재글 : [논문리뷰] Chaos in the Text: Revealing the Modality Preference in Mixed-Modality Retrievers
- 다음글 [논문리뷰] Do LLMs Understand Sequential Structure? A Controlled Study of Inference and Generation
댓글