[논문리뷰] RSI-Anything: Unlocking Recursive Self-Improvement with World Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Taoyong Cui, Pinxian Zeng, Wanghan Xu, Hao Xiao, Shuhan Xue, Qiang Gao, Wanli Ouyang, Pheng Ann Heng, Zhenfei Yin, Yingcheng Wu, Ling Yang
1. Key Terms & Definitions (핵심 용어 및 정의)
- RSI (Recursive Self-Improvement): 시스템이 상호작용 경험을 통해 얻은 피드백으로 정책이나 작업 흐름(Workflow)을 지속적으로 수정하고, 개선된 시스템이 다음 학습에 영향을 미치는 폐쇄형 루프 학습 방식.
- JEPA-Anything: 도메인 간 일반적인 세계 모델(World Model) 구축을 위한 프레임워크로, OPF (Orthogonal Predictive Factorization)를 통해 잠재 타겟을 요인별로 분해하고 합성하여 예측하는 구조.
- Predictive Foundation: 시스템이 candidate action의 결과를 미리 예측하여, 제한된 외부 피드백 환경에서도 효과적인 선택과 계획을 가능하게 하는 세계 모델 기반의 토대.
- Component & Compatibility Checks: 개선된 정책이나 세계 모델이 실제로 성능 향상을 보장하는지, 두 구성요소(Policy-Model Pair)가 결합했을 때의 시너지가 적절한지를 검증하여 시스템 업데이트 여부를 결정하는 프로토콜.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 RSI의 핵심인 '경험의 지속적 개선'을 구현하는 데 있어, 외부 피드백 획득 비용이 높고 정책 진화에 따라 세계 모델의 예측 신뢰도가 저하되는 문제를 해결하고자 한다. 기존의 단순 self-training이나 정책 최적화 방식은 복잡한 환경에서의 탐색 제한과 시스템 간의 부조화(Coupled-update challenge)로 인해 전체적인 성능 향상을 보장하지 못한다. 저자들은 이러한 문제를 해결하기 위해 예측 기반의 세계 모델을 정책 개선 루프에 통합하는 새로운 프레임워크인 RSI-Anything을 제안한다 [Figure 1].
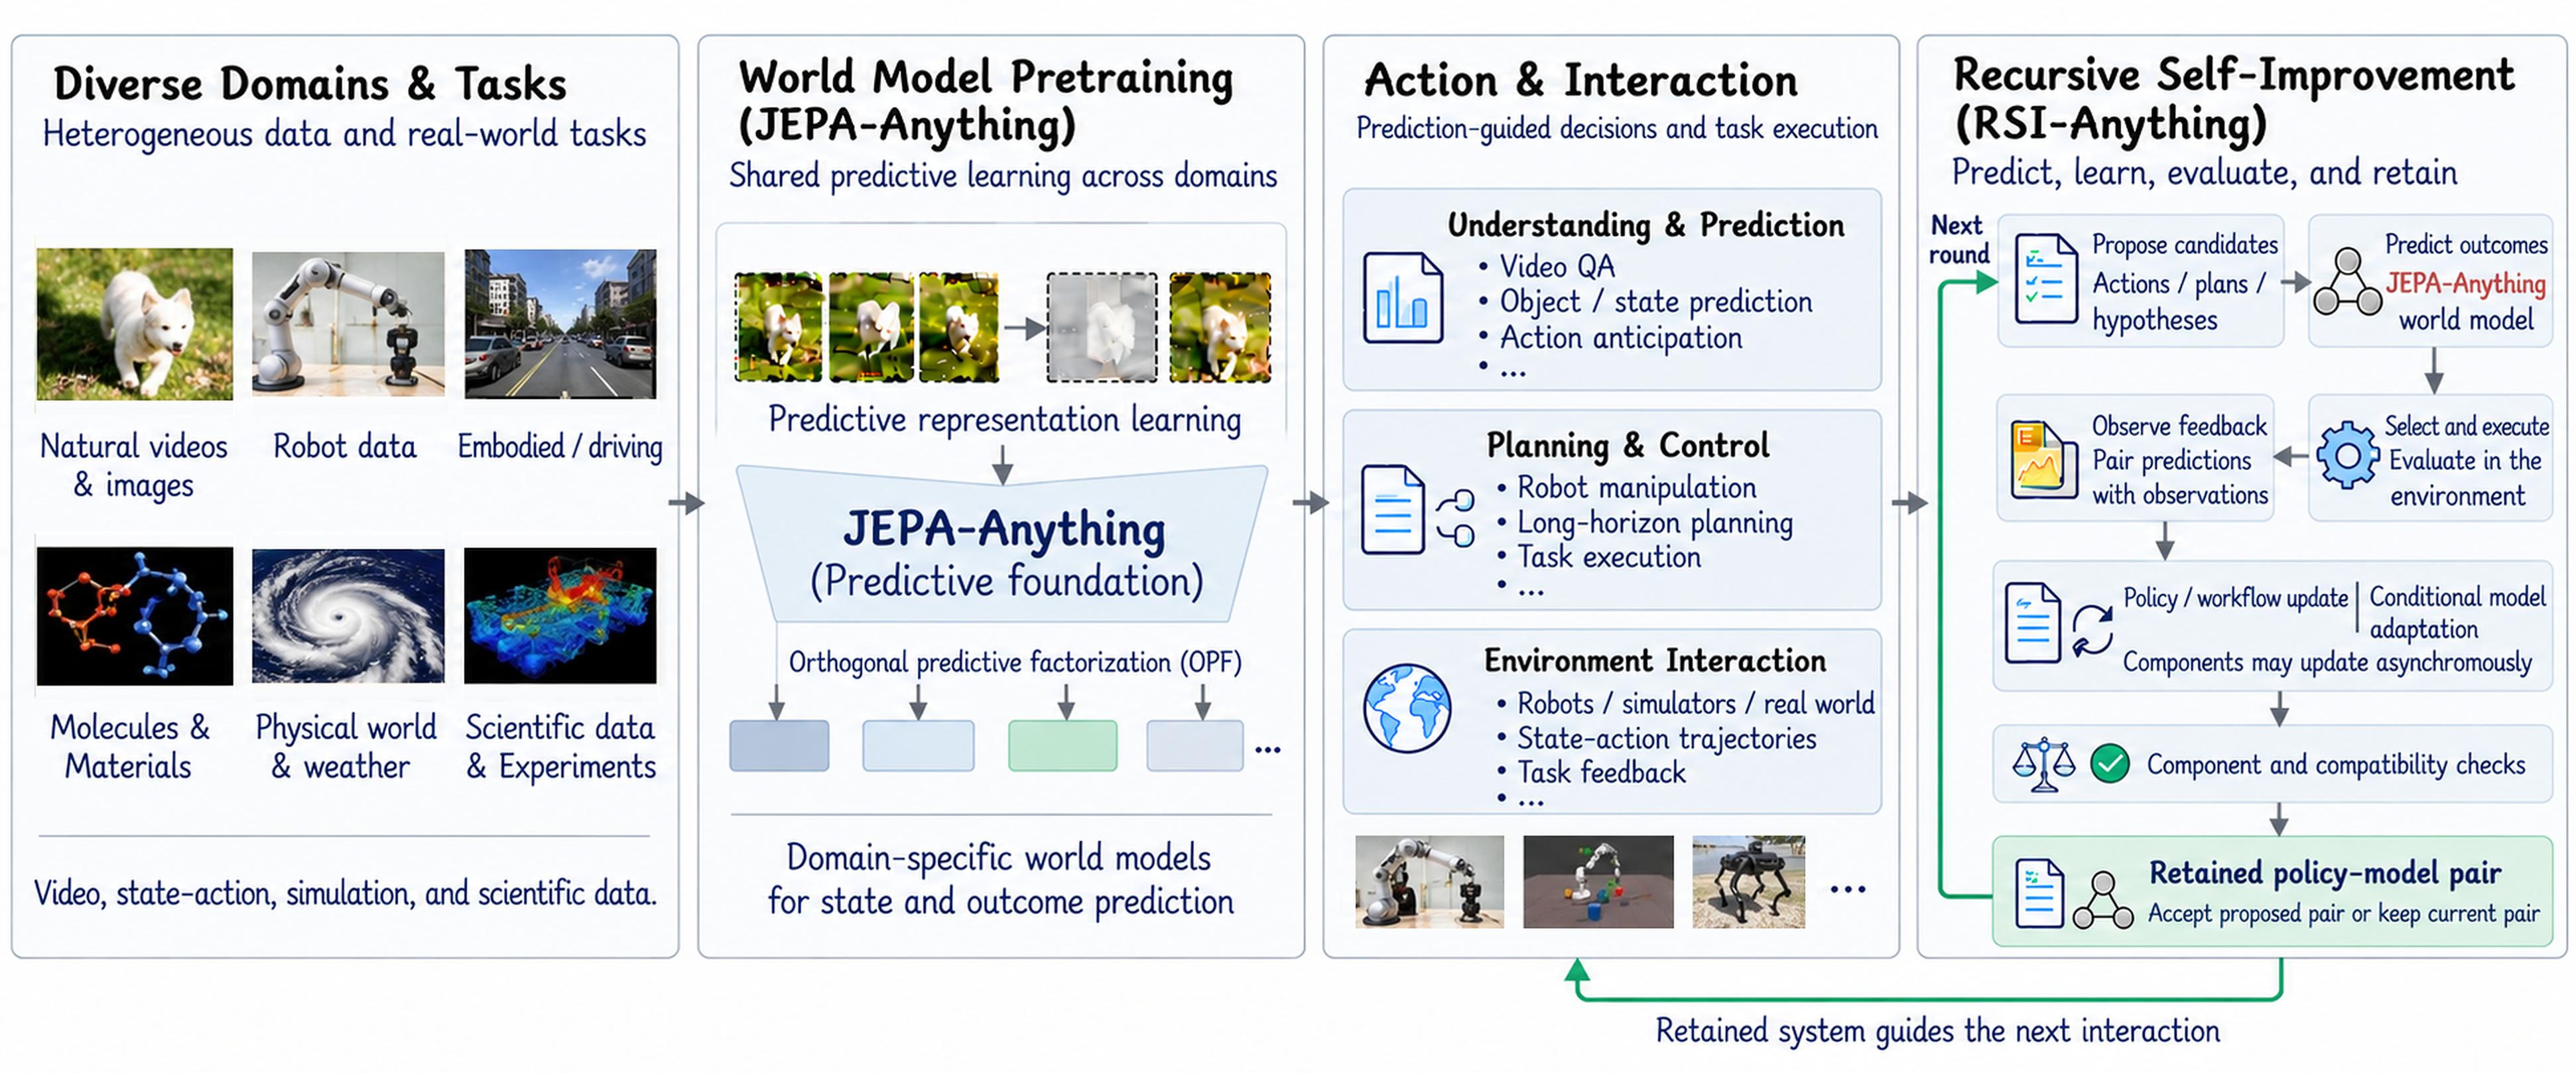
Figure 1 — RSI-Anything 전체 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 RSI-Anything을 통해 예측 기반의 행동 선택과 피드백 기반의 시스템 업데이트를 유기적으로 연결하는 프레임워크를 제시한다 [Figure 2]. 이 방법론은 정책과 세계 모델을 비동기적으로 업데이트하며, 각 구성 요소의 신뢰도 및 시스템 결합 후의 호환성을 검증하여 최적의 Policy-Model Pair를 유지한다.
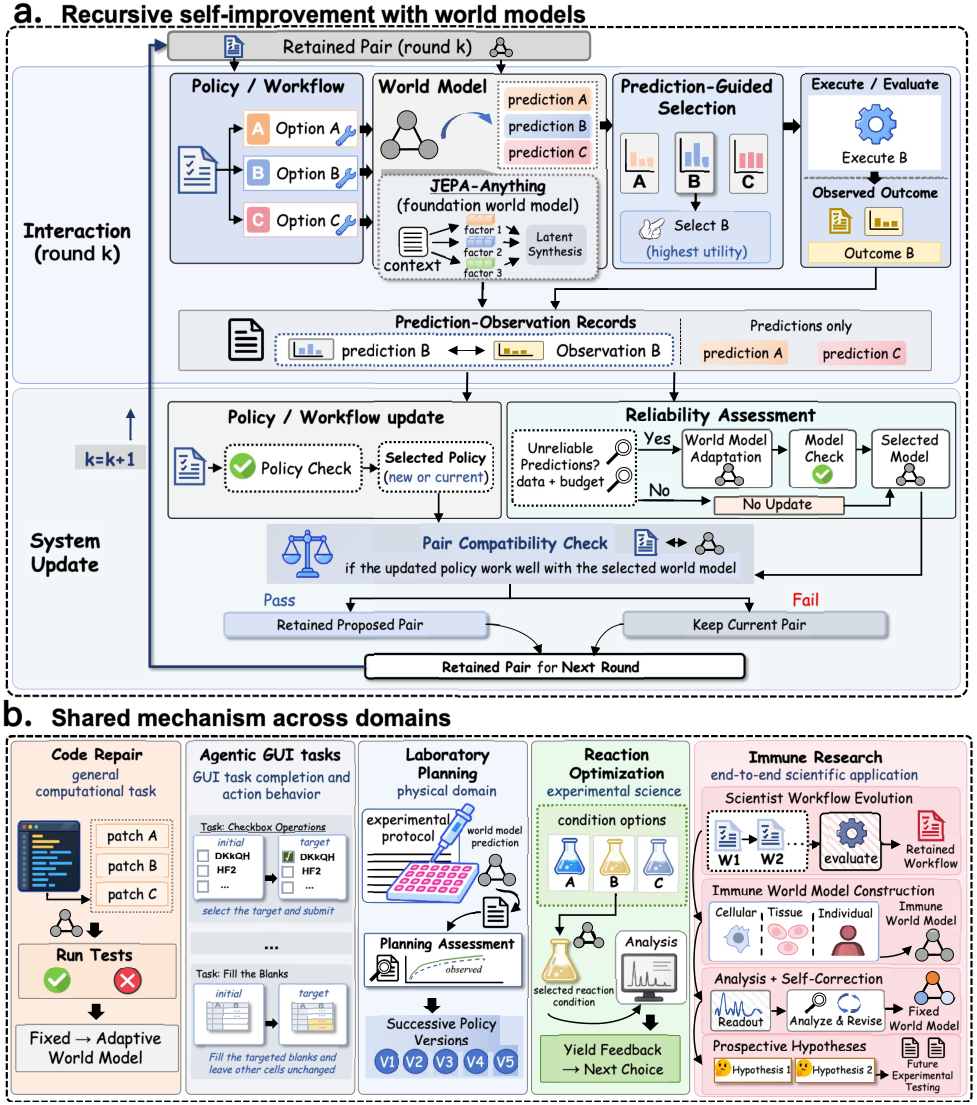
Figure 2 — 예측 가이드와 업데이트 루프
코드 수리(Code Repair) 작업에서 RSI-Anything은 정적 검증기(Static Verifier) 대비 26.3%에서 31.2%로 성공률을 개선하였으며, 이때의 테스트 호출 비용은 동일하게 유지되었다 [Table 2]. GUI 환경인 **MiniWoB++**에서는 작업 성공률이 99%에 도달했으며, 평균 액션 수는 39.4% 감소하는 성과를 보였다 [Figure 4]. 또한, 실험 과학 분야의 반응 최적화(Reaction Optimization)에서 RSI-Anything은 Bayesian Optimization의 82.16% 대비 96.15%의 높은 평균 최적 수율(Mean Best Observed Yield)을 달성했다 [Figure 6]. 이러한 결과는 세계 모델의 예측력이 정책 업데이트와 결합될 때 더 높은 효율성을 발휘함을 입증한다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 세계 모델과 정책의 재귀적 업데이트를 통합하는 RSI-Anything 프레임워크를 통해, 다양한 도메인에서 시스템 성능의 지속적인 향상이 가능함을 보여주었다. 연구 결과는 예측 기반의 선택과 엄격한 검증 프로토콜이 결합된 시스템이 불확실한 환경에서 에이전트의 자율성을 극대화할 수 있음을 시사한다. 이 프레임워크는 향후 에이전트 기반의 복잡한 과학적 연구 및 소프트웨어 개발 자동화 분야에서 강력한 기술적 기반이 될 것으로 기대된다.
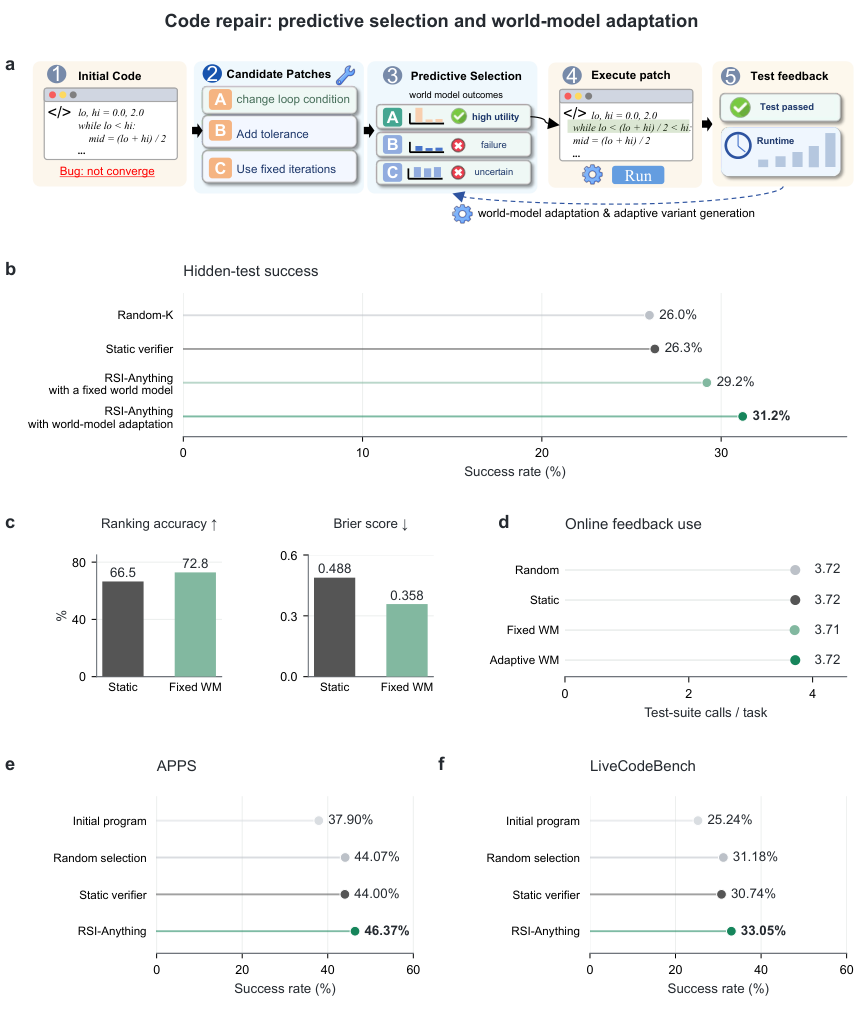
Figure 3 — 코드 수리 실험 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Agentic Game Development as a Verifiable Trajectory Data Engine for Scaling World Models
- [논문리뷰] WMPO: World Model-based Policy Optimization for Vision-Language-Action Models
- [논문리뷰] Athanor: An Agent-Native System for Autonomous Post-Training Research
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Review 의 다른글
- 이전글 [논문리뷰] QuantMLA: Function-Aligned Dual-Path Quantization for Low-Bit MLA KV Caching
- 현재글 : [논문리뷰] RSI-Anything: Unlocking Recursive Self-Improvement with World Models
- 다음글 [논문리뷰] Recurrent Harness for Agentic Continual Learning
댓글