[논문리뷰] TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
링크: 논문 PDF로 바로 열기
메타데이터
저자: Dayou Li, Hao Wang, Qianqian Yang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- TouchScale: 본 논문에서 제안하는 500시간 규모의 human visual-tactile 데이터셋으로, egocentric RGB-D 영상과 bimanual tactile glove 데이터를 통합한 대규모 자원입니다.
- Tactile Prediction: 시각적 정보와 과거의 촉각 데이터를 기반으로 미래의 촉각 상태(contact, pressure 등)를 추정하는 작업입니다.
- Mid-training: 로봇 정책(Robot Policy)을 학습시키기 전, 대규모 인간 visual-tactile 데이터를 활용하여 모델의 latent representation을 사전에 강화하는 단계입니다.
- cIoU (Contact Intersection-over-Union): 촉각 센서의 특정 영역 내에서 실제 접촉과 예측된 접촉이 일치하는 정도를 측정하는 정량적 지표입니다.
- 𝒩0-VTLA: 로봇 조작 작업을 위해 시각, 촉각, 언어 정보를 통합하여 액션을 예측하는 베이스라인 프레임워크입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 대규모 human egocentric 영상 데이터가 Embodied AI 발전에 기여하고 있음에도 불구하고, 물리적 상호작용의 핵심인 '접촉'과 '압력' 정보가 누락되어 있다는 점을 해결하고자 합니다 [Figure 1]. 기존의 visual-tactile 데이터셋들은 데이터 규모가 제한적(30시간 미만)이거나, 서로 다른 센서 및 수집 프로토콜을 병합하여 데이터 스케일링 효과를 분석하기 어렵다는 한계가 있습니다. 저자들은 일관된 센싱 파이프라인을 통해 수집된 대규모 데이터를 통해 visual-tactile learning이 로봇 조작 성능과 perception에 미치는 영향을 검증하고자 합니다.
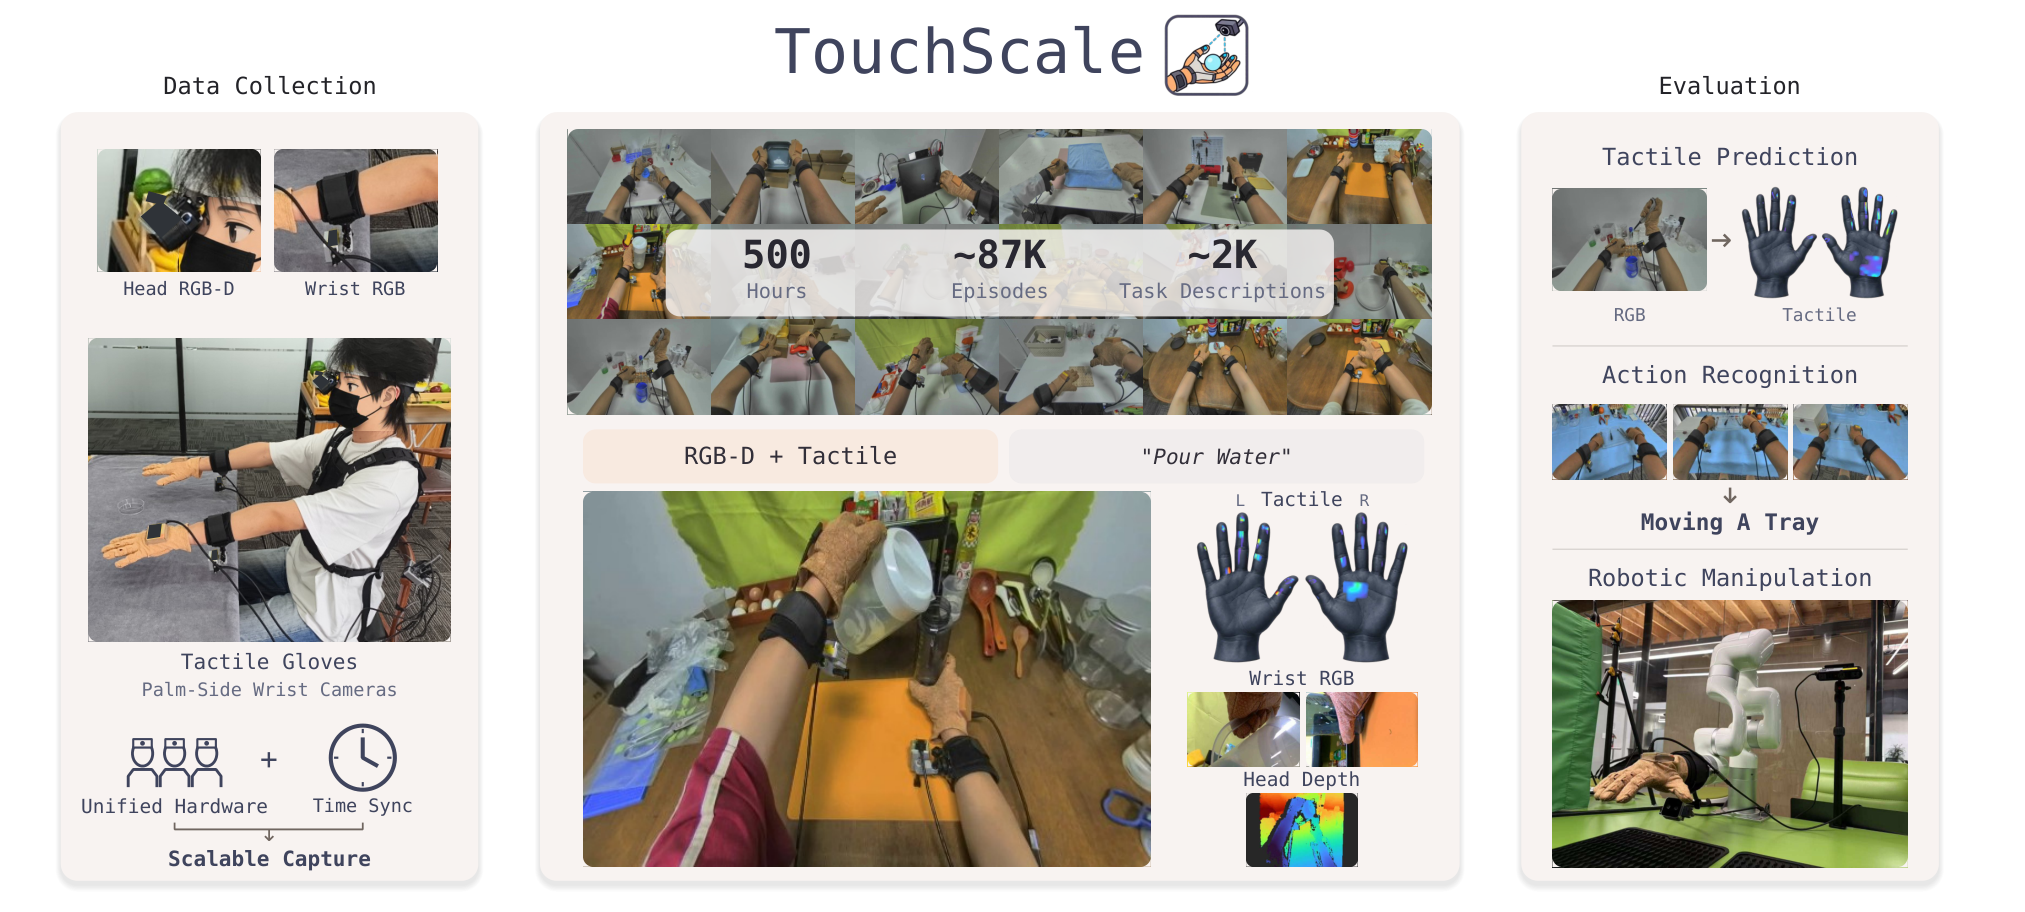
Figure 1 — TouchScale 개요 및 데이터 구조
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 head-mounted RGB-D 카메라와 bimanual tactile glove를 결합한 통합 웨어러블 시스템을 구축하여 500시간 분량의 일관된 데이터를 수집하는 TouchScale을 제안합니다 [Figure 2]. 제안 모델은 수집된 데이터를 통해 tactile prediction 모델을 학습시키며, 이를 로봇 정책 학습을 위한 mid-training stage에 적용하여 도메인 간 간극을 줄입니다. 실험 결과, TouchScale로 학습된 모델은 unseen tactile sensor에 대해 zero-shot cIoU를 기존 0.134에서 0.383으로 대폭 향상시켰습니다 [Table 2]. 또한, 로봇 조작 작업(Contact-rich manipulation)에서 mid-training을 적용할 경우, 평균 성공률이 22.5%에서 57.5%로 크게 향상됨을 확인했습니다 [Table 4]. 추가로, 데이터 규모가 증가함에 따라 zero-shot cIoU와 로봇 조작 성공률이 전반적으로 우상향하는 scaling trend를 관측하였습니다 [Figure 4, Figure 6].
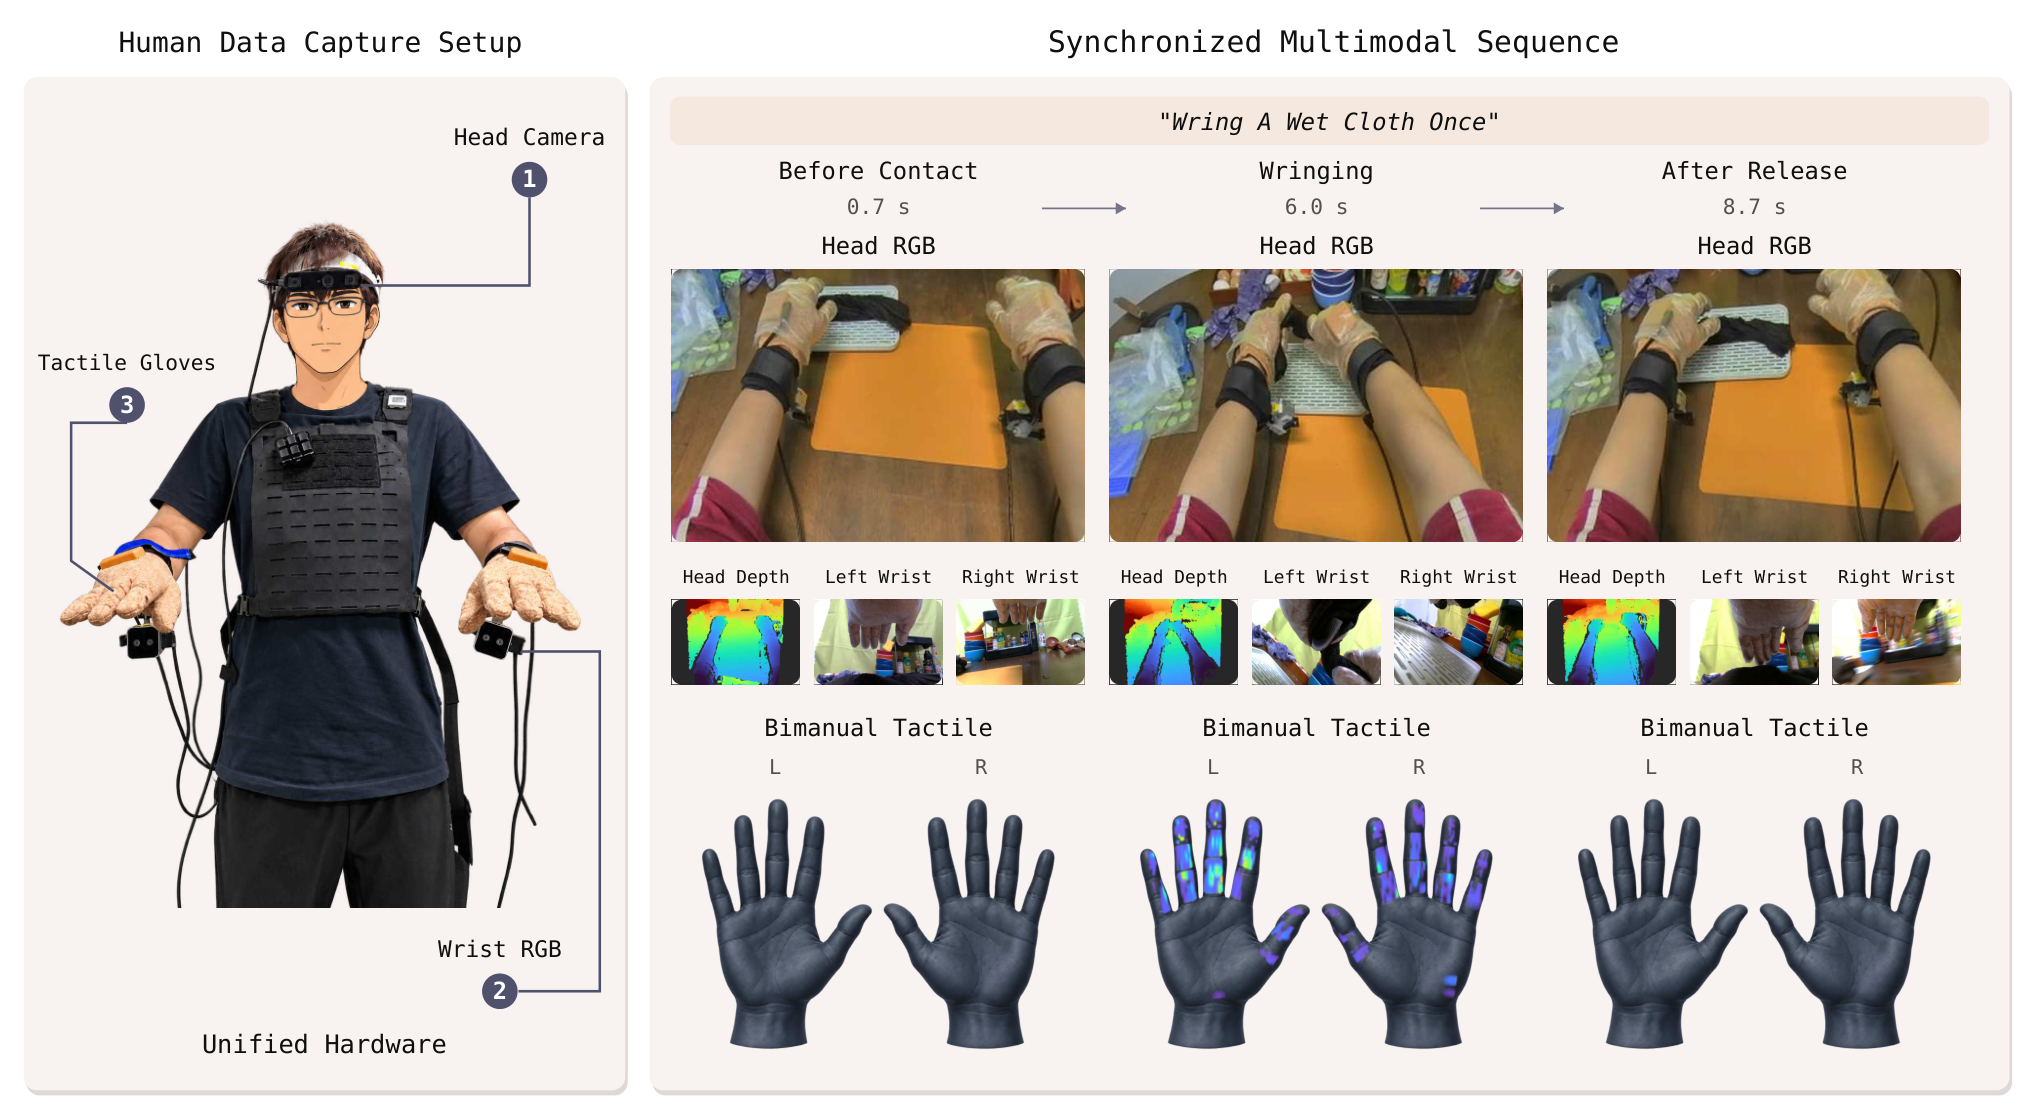
Figure 2 — 데이터 수집 장치 및 구성
4. Conclusion & Impact (결론 및 시사점)
본 연구는 대규모 human visual-tactile 데이터가 perception부터 robot control에 이르기까지 Embodied AI 전반에 강력한 성능 향상을 제공함을 입증했습니다. 특히, 일관된 센싱 파이프라인으로 구축된 TouchScale 데이터셋은 데이터 스케일링 법칙이 visual-tactile learning에도 유효함을 보여줍니다. 이 연구는 향후 로봇이 인간의 물리적 상호작용을 더 정교하게 모방하고, 복잡한 접촉 환경에서 높은 범용성을 확보하는 데 중요한 학술적·산업적 기틀을 제공할 것으로 기대됩니다.
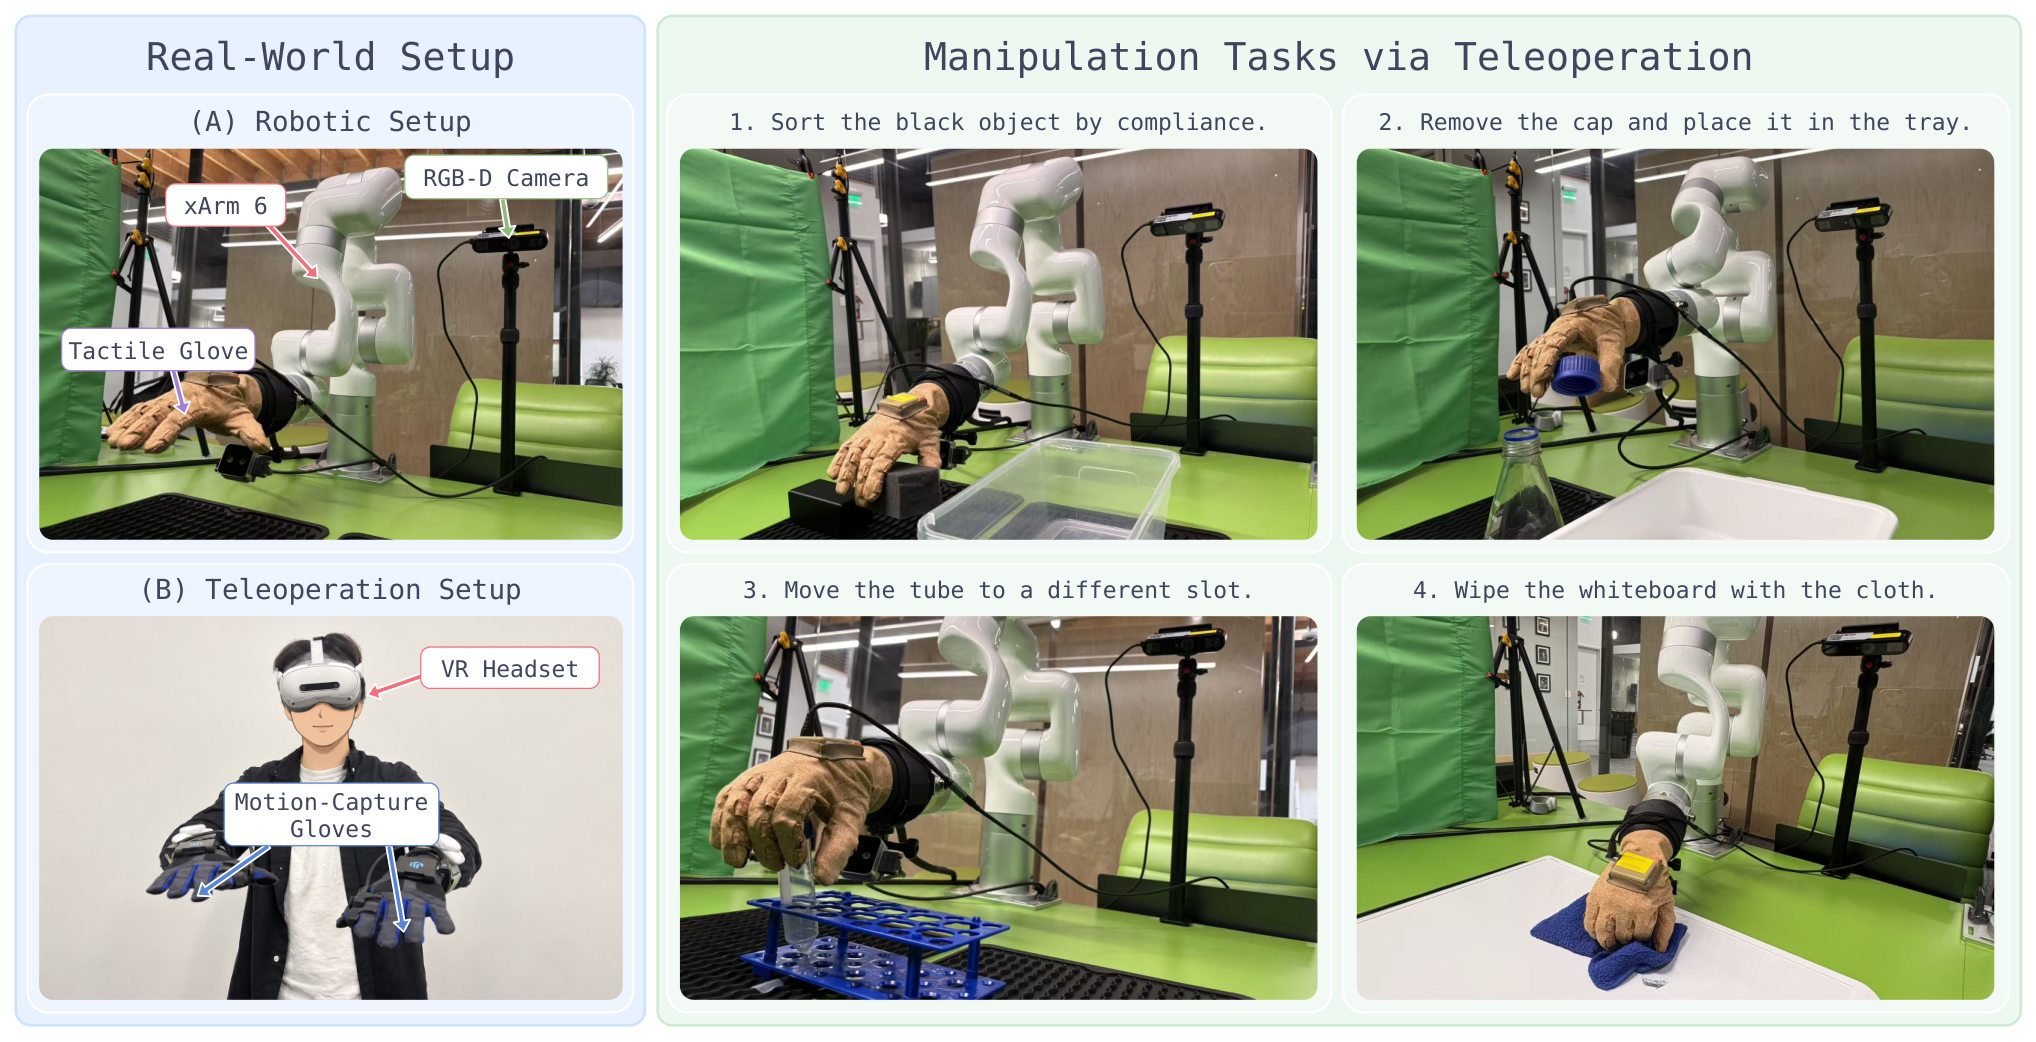
Figure 5 — 실제 로봇 환경 및 조작 과제
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Decision-Metric Alignment in Latent World Models: Diagnostics and Action-Conditioned Objectives for MPC Planning
- [논문리뷰] DreamX-Phi 1.0: Action-Conditioned Video World Model for Robotic Manipulation
- [논문리뷰] WCM: A World Critic Model for Vision-Language-Action Reinforcement Learning
- [논문리뷰] Virtual Width Networks
- [논문리뷰] Scaling Language-Centric Omnimodal Representation Learning
Review 의 다른글
- 이전글 [논문리뷰] ThinkDrag: Semantic Drag-Based Image Editing with Visual Reasoning
- 현재글 : [논문리뷰] TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
- 다음글 [논문리뷰] Towards Physically Grounded Articulated 3D Assets: A Multi-Agent Pipeline and Benchmark
댓글