[논문리뷰] AesCode: Aesthetic Code Generation with Decoupled Cross-Modal Rewards
링크: 논문 PDF로 바로 열기
[Total: 1] 저자: Xin Gao, Yifan Yang, et al.
1. Key Terms & Definitions
본 논문에서 제안하는 핵심 용어 및 개념은 다음과 같습니다.
- AesCode: 정보가 풍부한 시각적 아티팩트(예: 슬라이드, 포스터, 대시보드)를 코드로 생성하기 위한 새로운 프레임워크로, 이미지 생성기를 미적 가이드로 활용합니다.
- Design Graph: 코드 생성의 타겟을 구조화된 중간 표현으로 나타내며, 시맨틱 정보와 시각적 단서를 명시적으로 분리합니다. 노드는 기능적 요소를, 엣지는 구조적 관계를 정의합니다.
- Decoupled Cross-Modal Rewards: 코드에서 파싱 가능한 속성과 렌더링에서 측정 가능한 속성에 대한 Deterministic Verifiers와, VLM(Vision-Language Model) 심사관이 평가하는 비파싱 가능한 미학적 속성에 대한 Visual Graph Rubric (VGR)을 결합한 다중 목표 보상 시스템입니다.
- Deterministic Verifiers: 코드 및 DOM 렌더링에서 직접 검증 가능한 속성(예: Execution, Text, Boundary, Table/Chart, Semantic Layout, Whitespace)을 평가하는 규칙 기반의 보상 채널입니다.
- Visual Graph Rubric (VGR): Design Graph 요소 및 관계에 연결된 샘플별 이진 질문에 답변하여 미학적 품질을 평가하는 VLM 기반의 보상 채널입니다.
- GDPO (Group reward-Decoupled Normalization Policy Optimization): 여러 보상 채널의 이질적인 특성을 고려하여 각 채널을 개별적으로 정규화하여 최적화하는 강화 학습(RL) 알고리즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 코드 모델은 시각적 아티팩트 생성 시 레이아웃 및 색상 선택이 캔버스에 어떻게 나타나는지 "볼 수 없는" 근본적인 한계로 인해 공간 계획 및 미학적 품질이 제한됩니다. 반면 이미지 생성기는 시각적 디자인에 뛰어나지만, 텍스트, 숫자, 논리적 관계를 잘못 렌더링하여 결과물의 신뢰성을 떨어뜨리고 편집 및 검증이 불가능한 래스터 출력을 생성합니다. 이러한 상호 보완적인 강점을 통합하는 새로운 접근 방식의 필요성이 제기됩니다. 기존 이미지-투-코드(image-to-code) 방법들은 이미지를 픽셀 수준의 절대적인 Ground Truth로 취급하여, 생성된 이미지의 환각적(hallucinated) 콘텐츠를 모방하게 하거나 유효한 디자인 변화를 페널티로 간주하는 경직된 복제 문제를 가지고 있었습니다. 또한, 단순히 레퍼런스 이미지를 입력으로 제공하는 것만으로는 충분하지 않았는데, 이는 Off-the-shelf VLM이 시각적 특징과 텍스트 시맨틱을 얽히게 하여 노이즈가 있는 레퍼런스 이미지가 주어졌을 때 환각적 콘텐츠를 재생성하거나 레이아웃을 완전히 무시하는 경향이 있었기 때문입니다. 따라서, 텍스트 프롬프트의 콘텐츠 제약 조건을 엄격히 만족하면서도, 노이즈가 있는 레퍼런스 이미지에서 레이아웃 및 스타일과 같은 미학적 Prior를 유연하게 추출할 수 있도록 코드 모델을 명시적으로 훈련하는 것이 주요 도전 과제였습니다. [Figure 1]
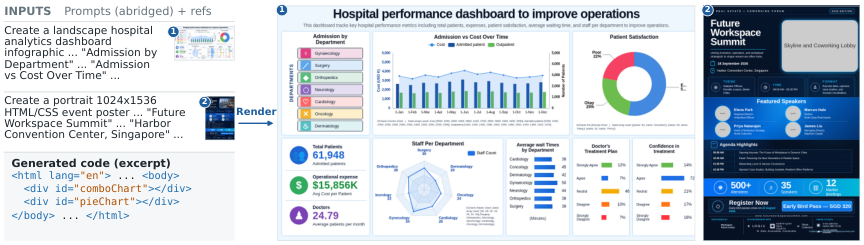
Figure 1 — 제안 방식의 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 미학적 코드 생성을 위해 AesCode라는 새로운 패러다임을 제안합니다. AesCode는 프롬프트에서 요구되는 콘텐츠와 레퍼런스 이미지에서 얻은 미학적 가이드라인을 결합하여 코드 모델이 시각적 디자인을 학습하도록 합니다. [Figure 2] 핵심 방법론은 다음과 같습니다. 첫째, 타겟 디자인을 Design Graph로 표현하여 프롬프트의 요구사항과 레퍼런스 이미지의 시각적 단서를 조합합니다. 이 그래프는 캔버스 전체를 묘사하며 각 속성을 개별적으로 식별 가능하게 합니다. 둘째, 이 Design Graph에서 Decoupled Cross-Modal Rewards를 도출합니다. 이는 코드와 렌더링에서 파싱 가능한 속성을 평가하는 Deterministic Verifiers (예: Execution, Text, Boundary, Table/Chart, Semantic Layout, Whitespace)와, 비파싱 가능한 미학적 속성을 Visual Graph Rubric (VGR)을 통해 평가하는 VLM 심사관으로 구성됩니다. VGR은 샘플별, 노드별 이진 질문을 통해 불안정한 총체적(holistic) 평가를 피하고 그래프 요소 및 관계에 연결된 명시적인 기준을 제시합니다. 셋째, 이러한 이질적인 보상 채널들은 GDPO (Group reward-Decoupled Normalization Policy Optimization)를 통해 최적화됩니다. GDPO는 각 보상 채널을 개별적으로 정규화하여, 조밀한 검증 신호가 희박한 미학적 피드백을 압도하는 것을 방지하고, 공간 계획, 미학적 품질 및 검증 가능한 정확성을 동시에 향상시킵니다.
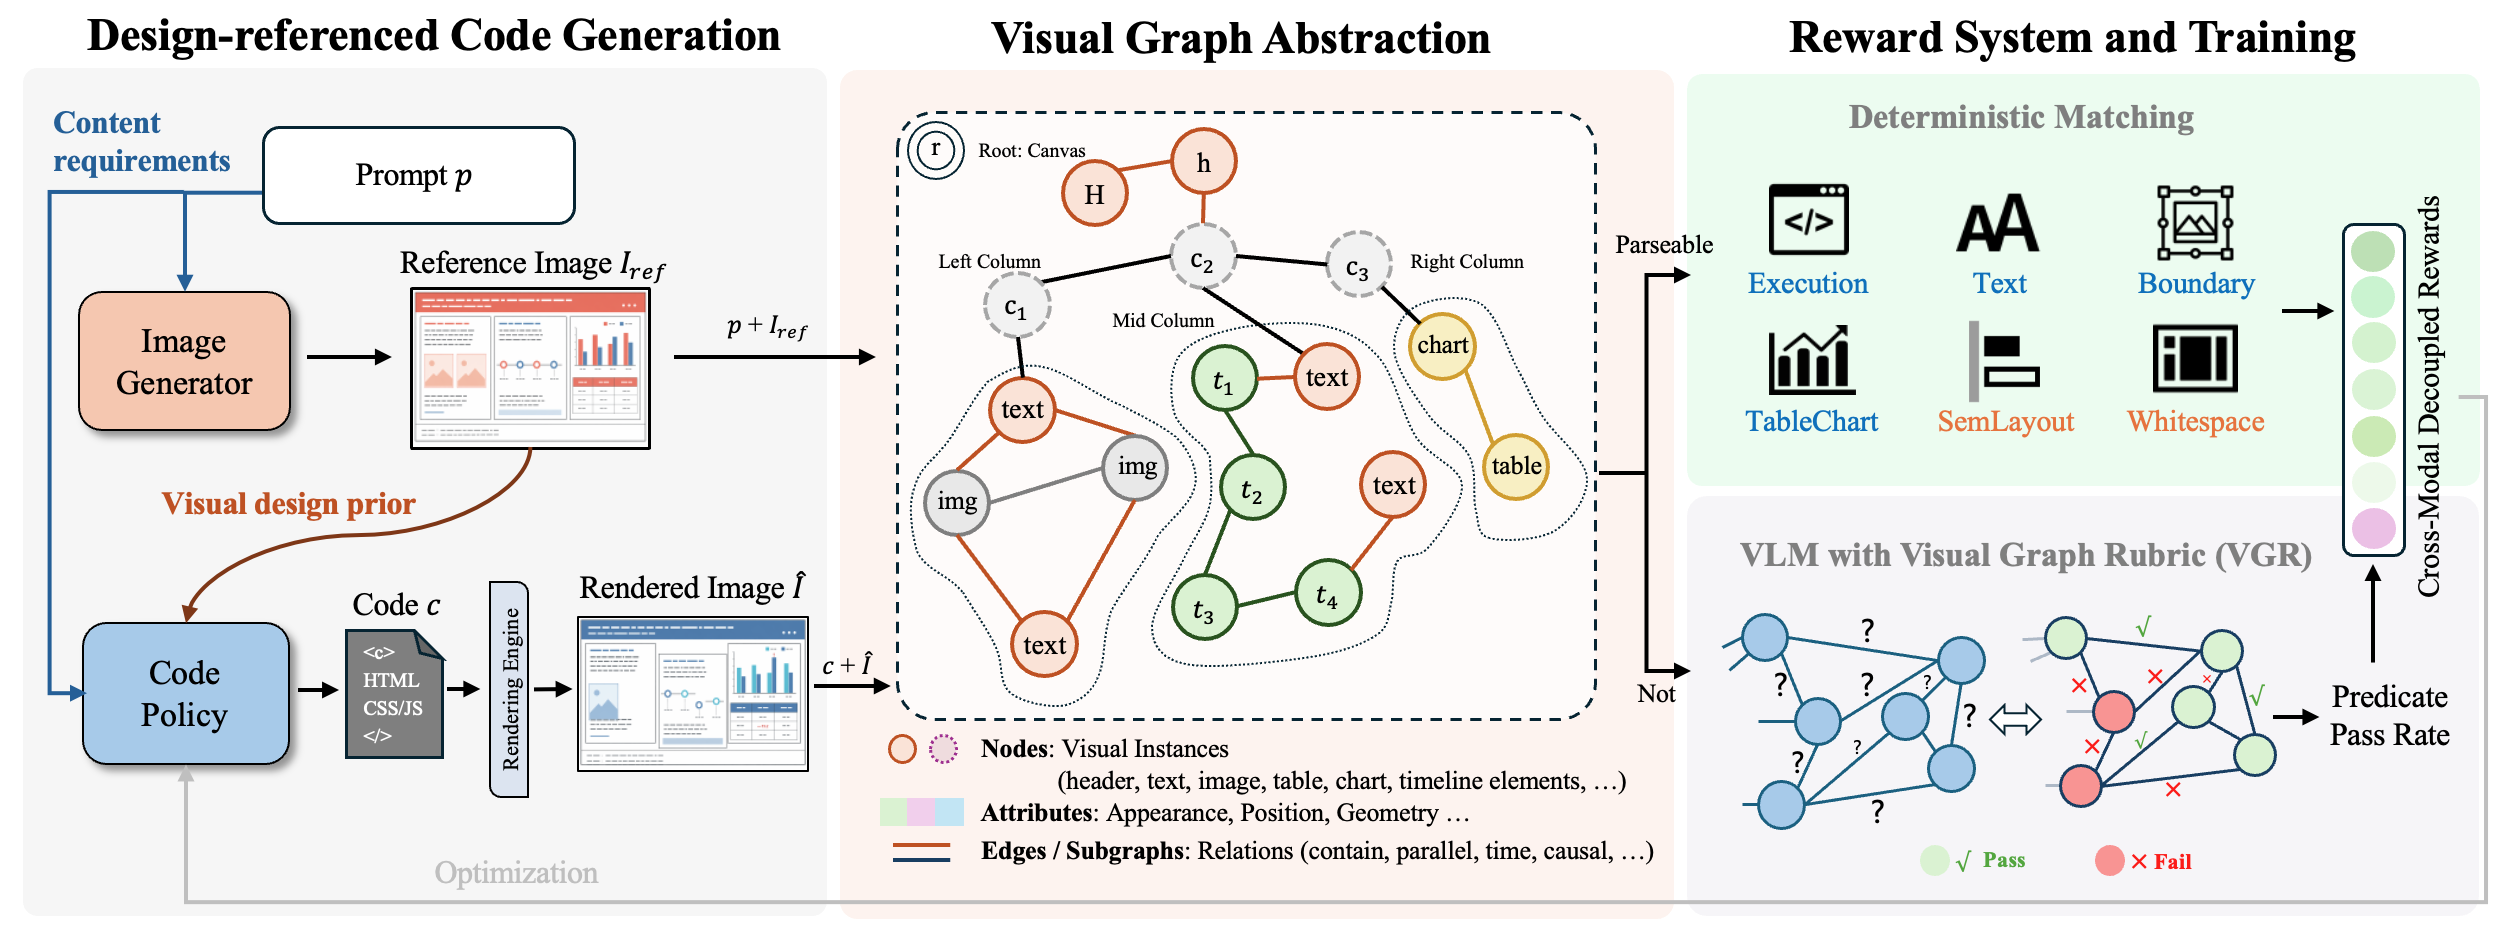
Figure 2 — AesCode의 전체 프레임워크
실험 결과, AesCode는 기준 모델 대비 미학적 품질과 검증 가능성에서 큰 향상을 보였습니다. 특히, AesCode-8B는 Qwen3-VL-8B 백본 대비 Visual Quality를 31.1 퍼센트 포인트, AesCode-32B는 Qwen3-VL-32B 백본 대비 22.4 퍼센트 포인트 향상시켰습니다. 자체 Infographic 벤치마크에서 AesCode-8B는 Overall score 82.94% (Rule 90.07%, Visual 75.80%)를 달성했으며, AesCode-32B는 Overall score 85.89% (Rule 94.33%, Visual 77.44%)로 더 높은 성능을 기록했습니다. 이는 GPT-5.5 (Overall 81.28%, Rule 85.80%, Visual 76.76%) 및 Claude Opus 4.8 (Overall 80.39%, Rule 83.55%, Visual 77.23%)과 같은 선도적인 Closed-Source 모델들과 비견되는 미학적 품질을 보여주면서도, 훨씬 적은 콘텐츠 오류를 나타냈습니다. [Table 1] [Figure 3] 또한, ablation study를 통해 강화 학습(RL)이 대부분의 성능 향상을 주도하며, GDPO가 Scalar GRPO 대비 Visual score를 5.12 포인트 향상시키는 것을 확인했습니다. 레퍼런스 이미지 기반 훈련이 다중 모드 시각적 계획을 모델에 내재화시켜, 추론 시 레퍼런스 입력이 없더라도 레퍼런스 기반 보상이 Prompt-Only Visual score를 25.17%에서 69.71%로 크게 높이는 효과를 보였습니다.
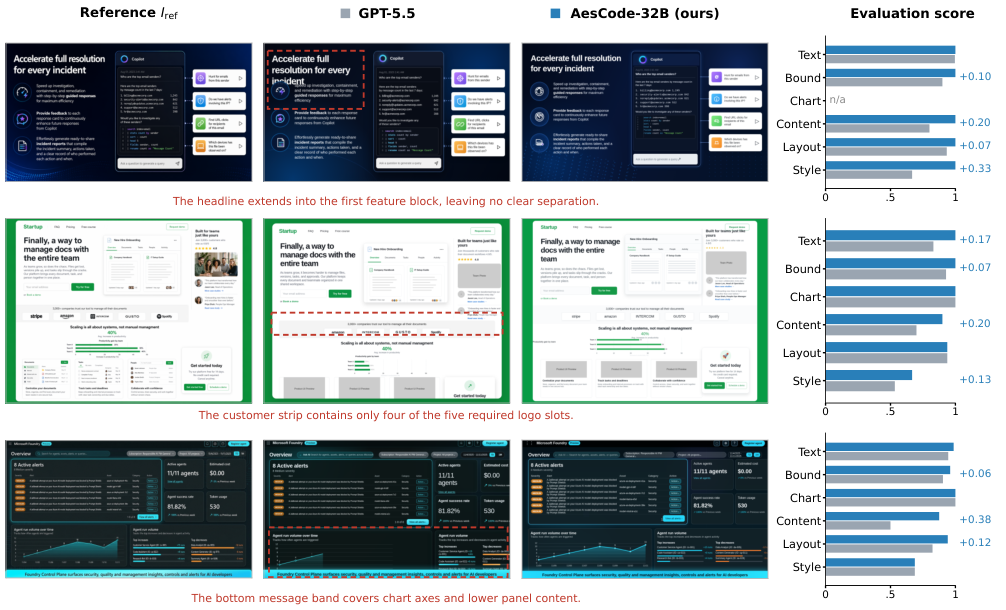
Figure 3 — 정성적 비교 사례
4. Conclusion & Impact (결론 및 시사점)
본 연구는 코드 모델이 검증 가능하며 시각적으로 매력적인 정보가 풍부한 아티팩트를 생성하는 방법을 제시합니다. AesCode는 Design Graph를 사용하여 요소 콘텐츠, 시각적 속성 및 관계를 포착함으로써, 프롬프트 요구사항과 이미지 생성 레퍼런스를 통해 목표 보상을 제공합니다. 이 접근 방식은 코드 모델이 Cross-Modal Understanding, 조직화, 그리고 시각적 판단을 내재화하도록 돕습니다. 궁극적으로 AesCode는 인간의 미학적 판단과 일치하는 시각적 품질 측면에서 선도적인 시스템들과 동등한 수준을 달성하며, 검증 가능한 정확성에서는 이들을 능가하는 결과를 보여주었습니다. 특히, 추론 시 레퍼런스 입력 없이도 상당한 기능을 유지한다는 점은 이 연구의 중요한 시사점입니다. 더 나아가, 본 연구는 이미지 생성기가 단순한 콘텐츠 생성기를 넘어 구조화된 생성 모델을 위한 확장 가능한 시각적 디자인 교사(scalable teachers of visual design)로서 기능할 수 있음을 입증합니다. 향후 연구에서는 픽셀 단위의 기하학적 정확성, 복잡한 관계 표현, 그리고 시맨틱 시각적 요소 생성과 같은 남은 과제들을 시각적으로 grounded된 반복적 개선(iterative refinement) 및 더욱 정밀한 구조적 피드백을 통해 해결해야 할 필요성을 제기합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Enhancing Spatial Understanding in Image Generation via Reward Modeling
- [논문리뷰] PyVision-RL: Forging Open Agentic Vision Models via RL
- [논문리뷰] EditScore: Unlocking Online RL for Image Editing via High-Fidelity Reward Modeling
- [논문리뷰] Mini-o3: Scaling Up Reasoning Patterns and Interaction Turns for Visual Search
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] APEX: Asynchronous Prefix Denoising for Extreme Compression
- 현재글 : [논문리뷰] AesCode: Aesthetic Code Generation with Decoupled Cross-Modal Rewards
- 다음글 [논문리뷰] Agent-Reflex: Teaching Language Agents to Act Reflectively
댓글