[논문리뷰] EviScene: Beyond 'Is It AI?' for Agentic Image Factuality Assessment
링크: 논문 PDF로 바로 열기
저자: ZiAn Wang, Ruiqi Liu, Zhengbo Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문은 Image Factuality Assessment 분야에서 여러 핵심 용어와 방법론을 제시한다.
- Image Factuality Assessment: 주어진 이미지와 일반적인 검증 지침(generic verification instruction)을 바탕으로, 해당 이미지가 묘사하는 상황이 사실에 부합하는지(supported) 또는 반박되는지(refuted)를 판단하고, 증거 기반의 설명(evidence-grounded explanation)을 제공하는 태스크를 의미한다.
- EviLens: Image Factuality Assessment를 위한 벤치마크 데이터셋으로, 10,174개의 supported 및 refuted 이미지로 구성되며, 12가지 factual error type을 포함하여 판단 정확도(verdict accuracy)와 증거 충분성(evidence sufficiency)을 함께 평가한다.
- EviScene: Image Factuality Assessment를 위해 제안된 Multimodal ReAct Agent이다. EviScene은 시각적 검사(visual inspection), 외부 검색(external retrieval), 증거 분석(evidence analysis)을 번갈아 수행하며, 새로운 발견을 통해 질문을 refining하고 관련 이미지 세부 정보를 재검토한다.
- ReAct: Language Model이 Reasoning과 Action을 교차하며 Multi-step Investigation을 수행하도록 지원하는 프레임워크로, EviScene의 기반 Agent architecture로 활용된다.
- Strict Evidence Sufficiency Rate (SESR): 평가 Metric 중 하나로, 올바른 판단(correct verdict)과 함께 이미지 기반의 결정적인 사실에 대한 충분한 근거(sufficient grounds)가 제시된 케이스의 비율을 나타낸다.
- Supervised Fine-Tuning (SFT): EviScene Agent의 Policy 학습을 위한 첫 번째 단계로, 전문가가 검토한 teacher trajectories를 사용하여 모델을 Fine-tuning하는 방법이다.
- Privileged On-Policy Self-Distillation (PSD): SFT 이후에 적용되는 Policy 학습 방법으로, Policy 자체 Investigation에서 검증된 결정(verified decisions)에 대해 hint-guided continuations를 사용하여 Policy를 지도(supervise)한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 이미지가 AI 생성 여부와 무관하게, 해당 이미지가 묘사하는 상황의 사실 여부를 판단하는 Image Factuality Assessment의 핵심 문제를 해결하고자 한다. 기존 연구들은 주로 이미지가 AI로 생성되었는지 여부를 판별하거나, 제공된 텍스트 Claim을 검증하는 Claim-guided Verification에 초점을 맞췄다. 하지만 Image-centered Verification 환경에서는 시스템이 주어진 텍스트 Claim 없이 이미지 내용만을 가지고 사실 질문(factual questions)을 점진적으로 refining하고 외부 증거를 이미지 속 특정 상황과 정렬해야 하는 두 가지 주요 Challenge에 직면한다.
첫째, 초기 시각적 검사만으로는 이미지에 묘사된 복잡한 사실 관계를 명확히 하고 검증하기에 불충분하다. Claim-centered 벤치마크(예: AVerImaTeC)에서는 제공된 텍스트 Claim이 증거 검색의 Anchor 역할을 하지만, Image-centered 환경에서는 모델이 시각적 내용과 새롭게 얻은 증거를 활용하여 이미지 의미의 핵심이 되는 사실에 대한 질문을 formulate하고 refine해야 한다. 둘째, 검색된 증거는 이미지에 묘사된 특정 상황과 정확히 Align되어야 한다. 동일한 인물이나 장소에 대한 자료라도 다른 활동, 시기, 또는 단계에 관한 것일 수 있으며, 단순히 공유된 인물이나 장소만으로는 Verdict를 뒷받침하기에 충분하지 않다. 이러한 문제들을 해결하기 위해서는 시각적 검사와 증거 수집을 interleaving하고, 중간 발견(intermediate findings)을 활용하여 다음에 무엇을 확인할지 Refining하는 접근 방식이 필수적이다. [Figure 1]은 Claim-guided Verification과 Image-centered Verification의 차이를 명확히 보여준다.
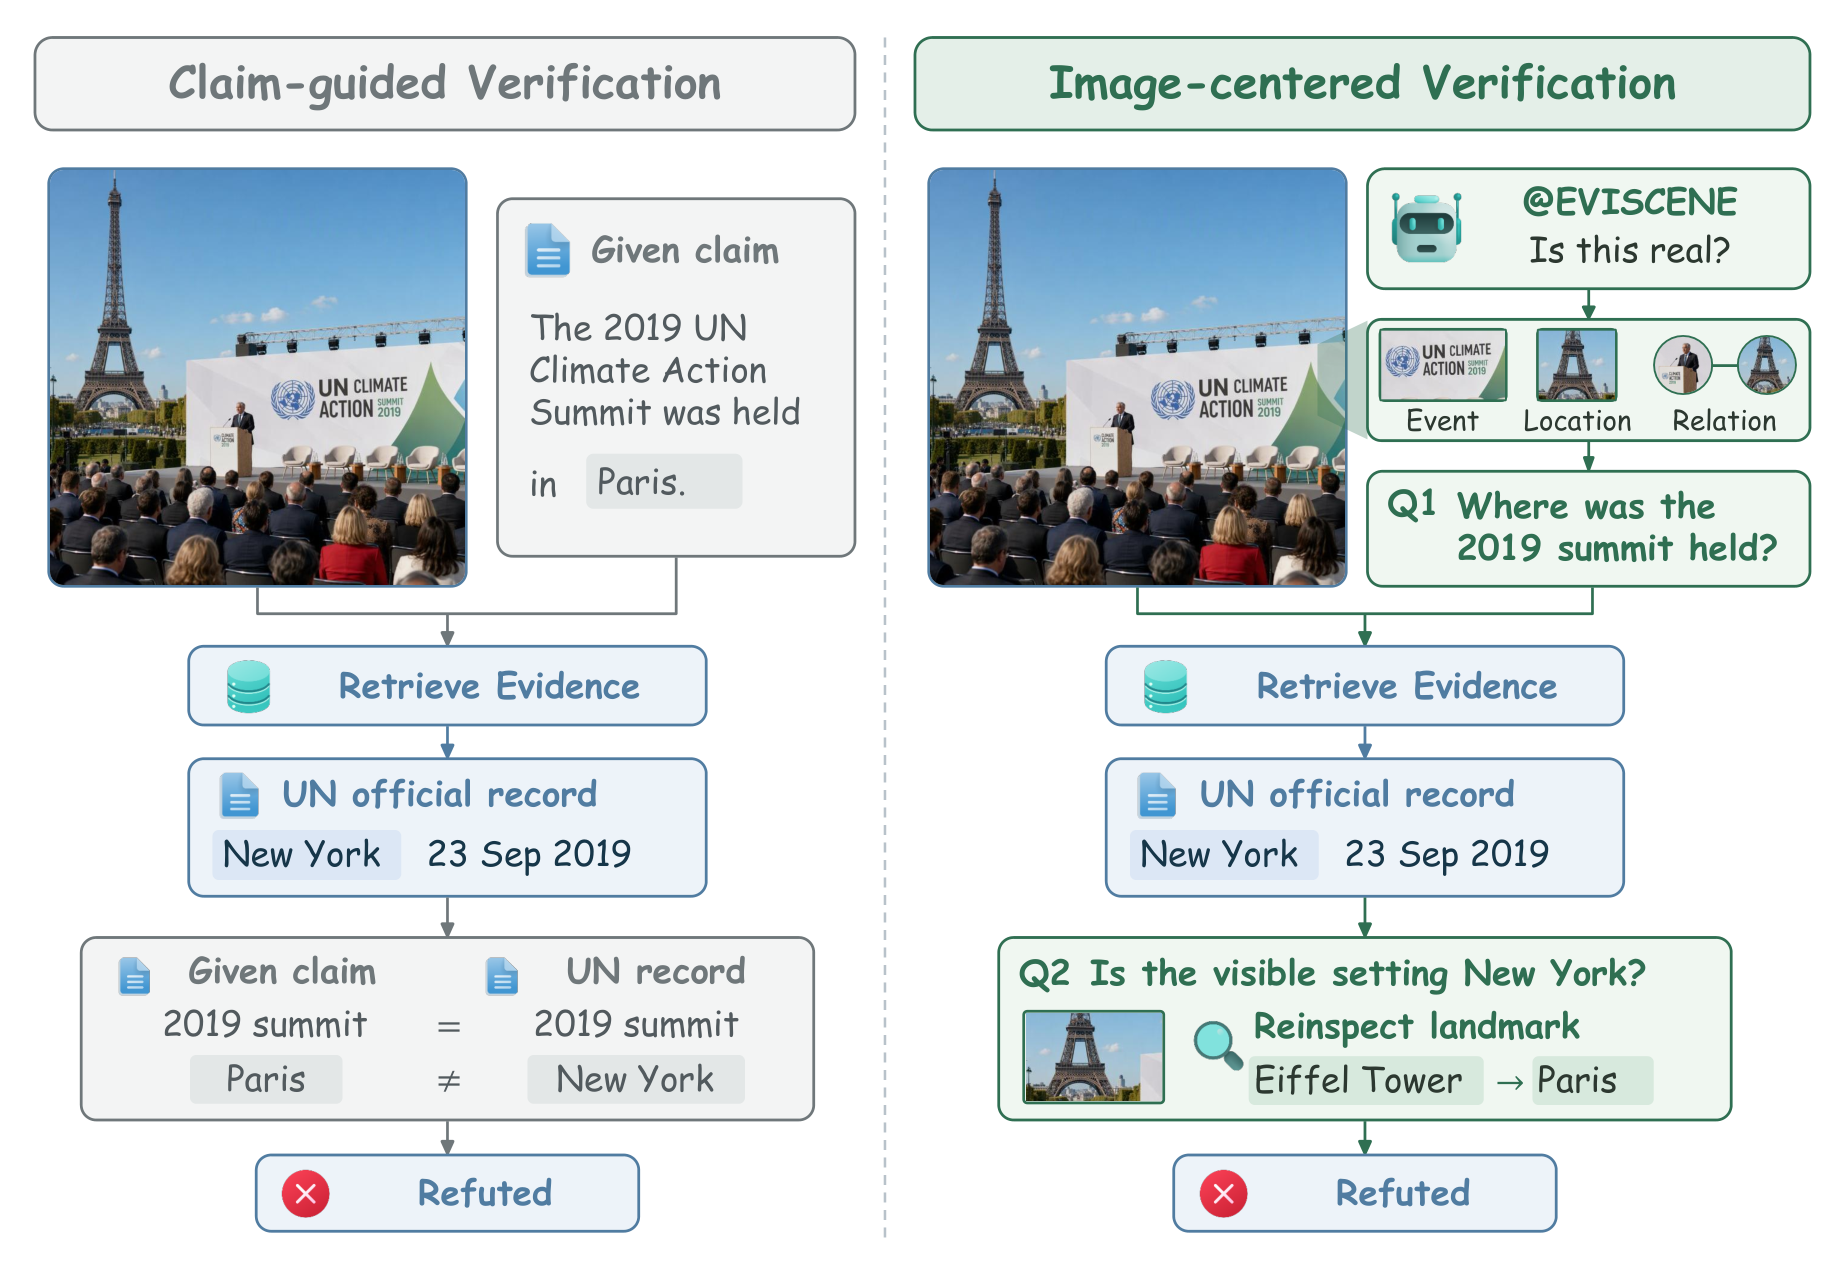
Figure 1 — 클레임-가이드 및 이미지 중심 검증 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 이미지 중심의 사실 검증을 위해 Multimodal ReAct Agent인 EviScene을 제안하며, 2단계 Policy Training 과정을 거친다. EviScene Agent는 시각적 검사(visual inspection), 웹 및 이미지 검색(web and image retrieval), 소스 판독(source reading), Reference-image Comparison을 하나의 ReAct History 내에서 Interleaving한다. 각 단계에서 Policy는 입력 이미지와 누적된 Investigation History를 사용하여 해결되지 않은 사실 질문에 대해 Reasoning하고 다음 Tool action을 선택한다. EviScene은 Visual tools, Retrieval tools, Evidence tools 세 가지 Tool Group을 제공한다. 새로운 관찰 결과는 질문 Refining과 다음 Actions(예: 더 Target화된 검색 또는 관련 이미지 영역 재검사)을 유도한다.
Policy Training은 다음 두 단계를 거친다:
- Full-Trajectory Supervised Fine-Tuning (SFT): Qwen3.5-397B-A17B 모델이 생성한 Teacher trajectories를 사용하여 Qwen3.5-9B 모델을 Full-parameter SFT한다. 총 4,872개의 검토된 Teacher trajectories로 3 Epoch 동안 Training을 진행하며, Tool call 및 Final report 토큰에 더 높은 가중치(wi=2)를 부여하여 Loss를 최소화한다.
- Privileged On-Policy Self-Distillation (PSD): SFT 이후, Policy 자체 Investigation에서 선택된 Decisions에 대해 PSD를 적용한다. Gemini 3.7 Flash 모델을 사용하여 Decision을 Localization하고, 절차적 힌트(procedural hint)를 구성한 후, Hint-guided continuation을 통해 Policy를 Supervise한다. Student는 Frozen Teacher의 Top-K 토큰 확률을 Matching하도록 Training된다.
실험 결과, EviScene은 EviLens 벤치마크의 1,527개 테스트 이미지 세트에서 우수한 성능을 입증했다. 특히, SFT와 PSD를 모두 적용한 최종 Qwen3.5-9B Policy는 79.05%의 Balanced Accuracy (BAcc)와 52.26%의 Strict Evidence Sufficiency Rate (SESR)를 달성했다. 이는 동일한 Backbone을 사용하는 Base Agent 대비 BAcc에서 6.71 percentage points, SESR에서 9.37 percentage points 향상된 수치이다. EviScene의 SESR은 평가된 모든 Agent 중 가장 높았다. [Table 1]은 Direct Visual Judgment 모델들과 EviScene Agent들의 BAcc, Macro F1, Recall, SESR 등을 비교한 주요 정량적 결과를 보여준다. 또한, Tool Ablation 연구 결과 [Table 3], Web search, Image retrieval, Evidence inspection 중 어느 하나라도 제거할 경우 BAcc와 SESR이 모두 감소하며, Web search 제거 시 SESR이 16.37 points로 가장 크게 감소하여 외부 증거 검색 도구의 중요성을 입증했다. [Figure 7]은 Training 단계별로 Qwen3.5-9B Policy의 Overall Decision Quality, Recall, Evidence Sufficiency가 어떻게 변화하는지 보여준다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Claim 없이 이미지 자체의 사실 여부를 검증하는 Image Factuality Assessment라는 새로운 태스크를 정의했다. 이를 위해 12가지 factual error type을 포함하는 대규모 벤치마크 데이터셋인 EviLens를 구축하여 Verdict Accuracy와 Evidence Sufficiency를 동시에 평가할 수 있도록 했다. 또한, 시각적 정보와 외부 증거 수집을 Interleaving하여 사실 질문을 Refining하는 Multimodal ReAct Agent인 EviScene을 개발했으며, SFT와 PSD를 통해 효율적으로 Training된 Compact Policy를 제시했다.
EviScene은 다양한 Backbone 모델에서 Direct Judgment 대비 Evidence Sufficiency를 크게 향상시켰으며, 특히 Training된 Qwen3.5-9B Policy는 평가된 Agent 중 가장 높은 SESR을 달성했다. Web search, Image retrieval, Evidence inspection Tool들의 Ablation Study는 각 Tool이 Factuality Assessment 과정에서 필수적인 역할을 수행함을 보여주었다. 이 연구는 이미지가 AI 생성 여부나 시각적 그럴듯함(visual plausibility)만을 판단하는 것을 넘어, 묘사된 상황의 Factuality를 증거 기반으로 검증하는 Agentic Approach의 효과를 강력하게 시사한다. EviLens 벤치마크와 EviScene 방법론은 Multimodal Fact-checking 및 AI Agent 연구 분야에 중요한 기여를 하며, 시각적 허위 정보(visual misinformation)에 대응하기 위한 더욱 신뢰할 수 있는 시스템 개발에 실질적인 Impact를 미칠 것으로 기대된다.
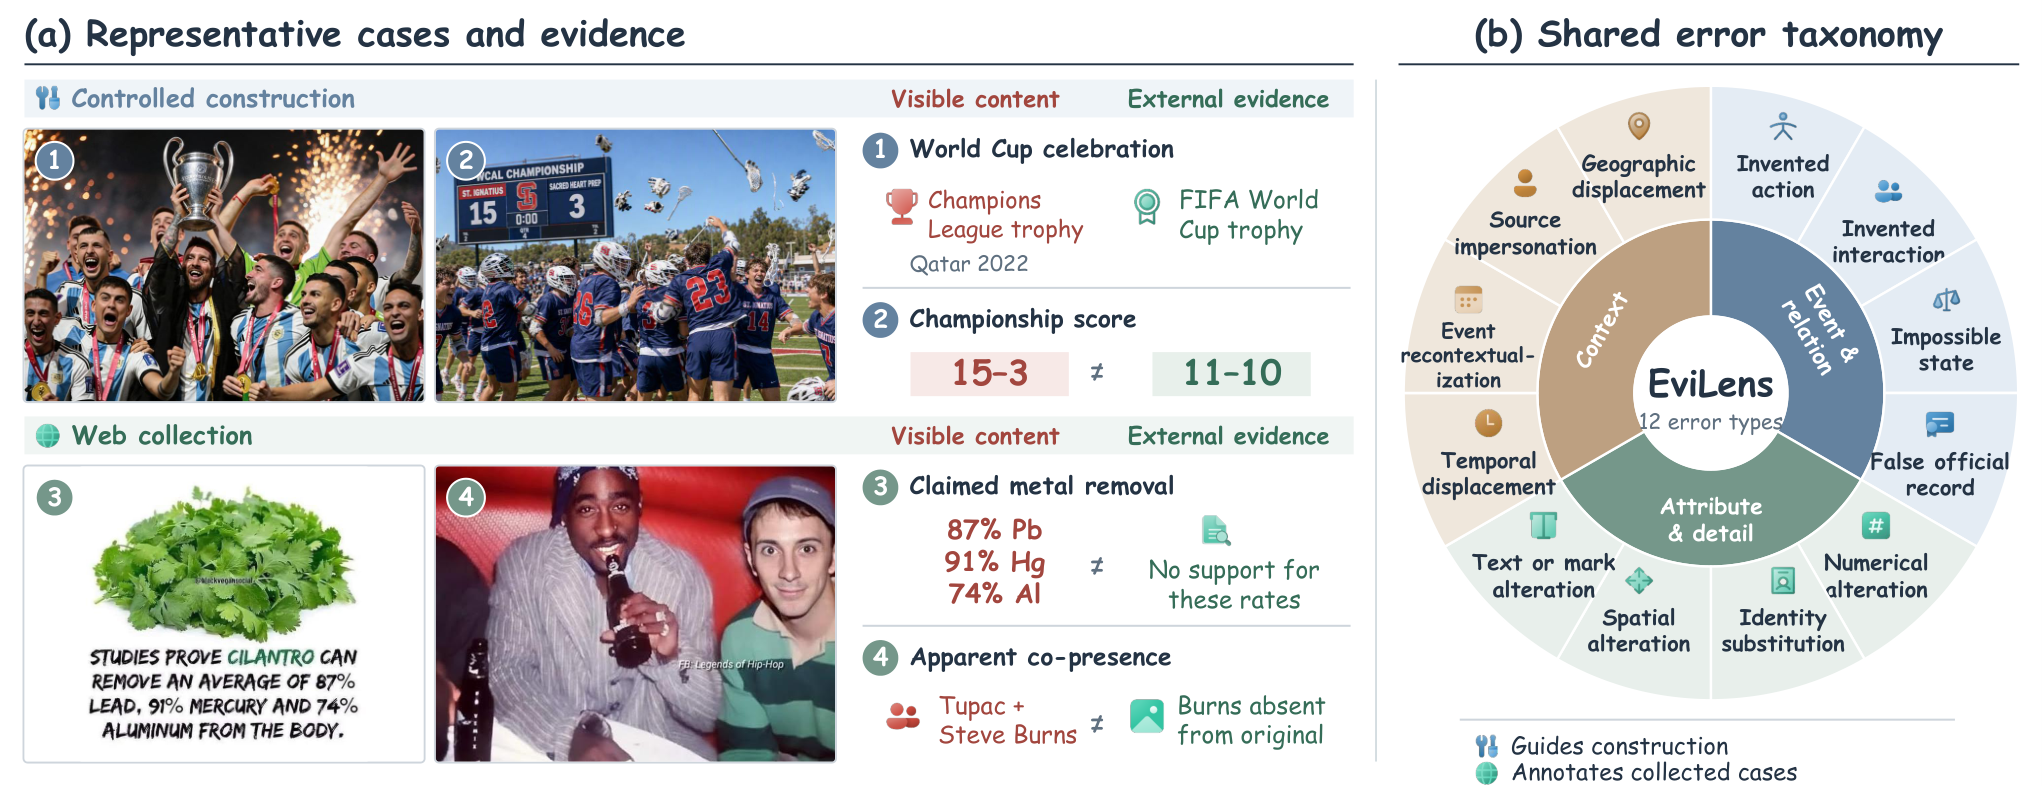
Figure 2 — EviLens의 사실 오류 유형
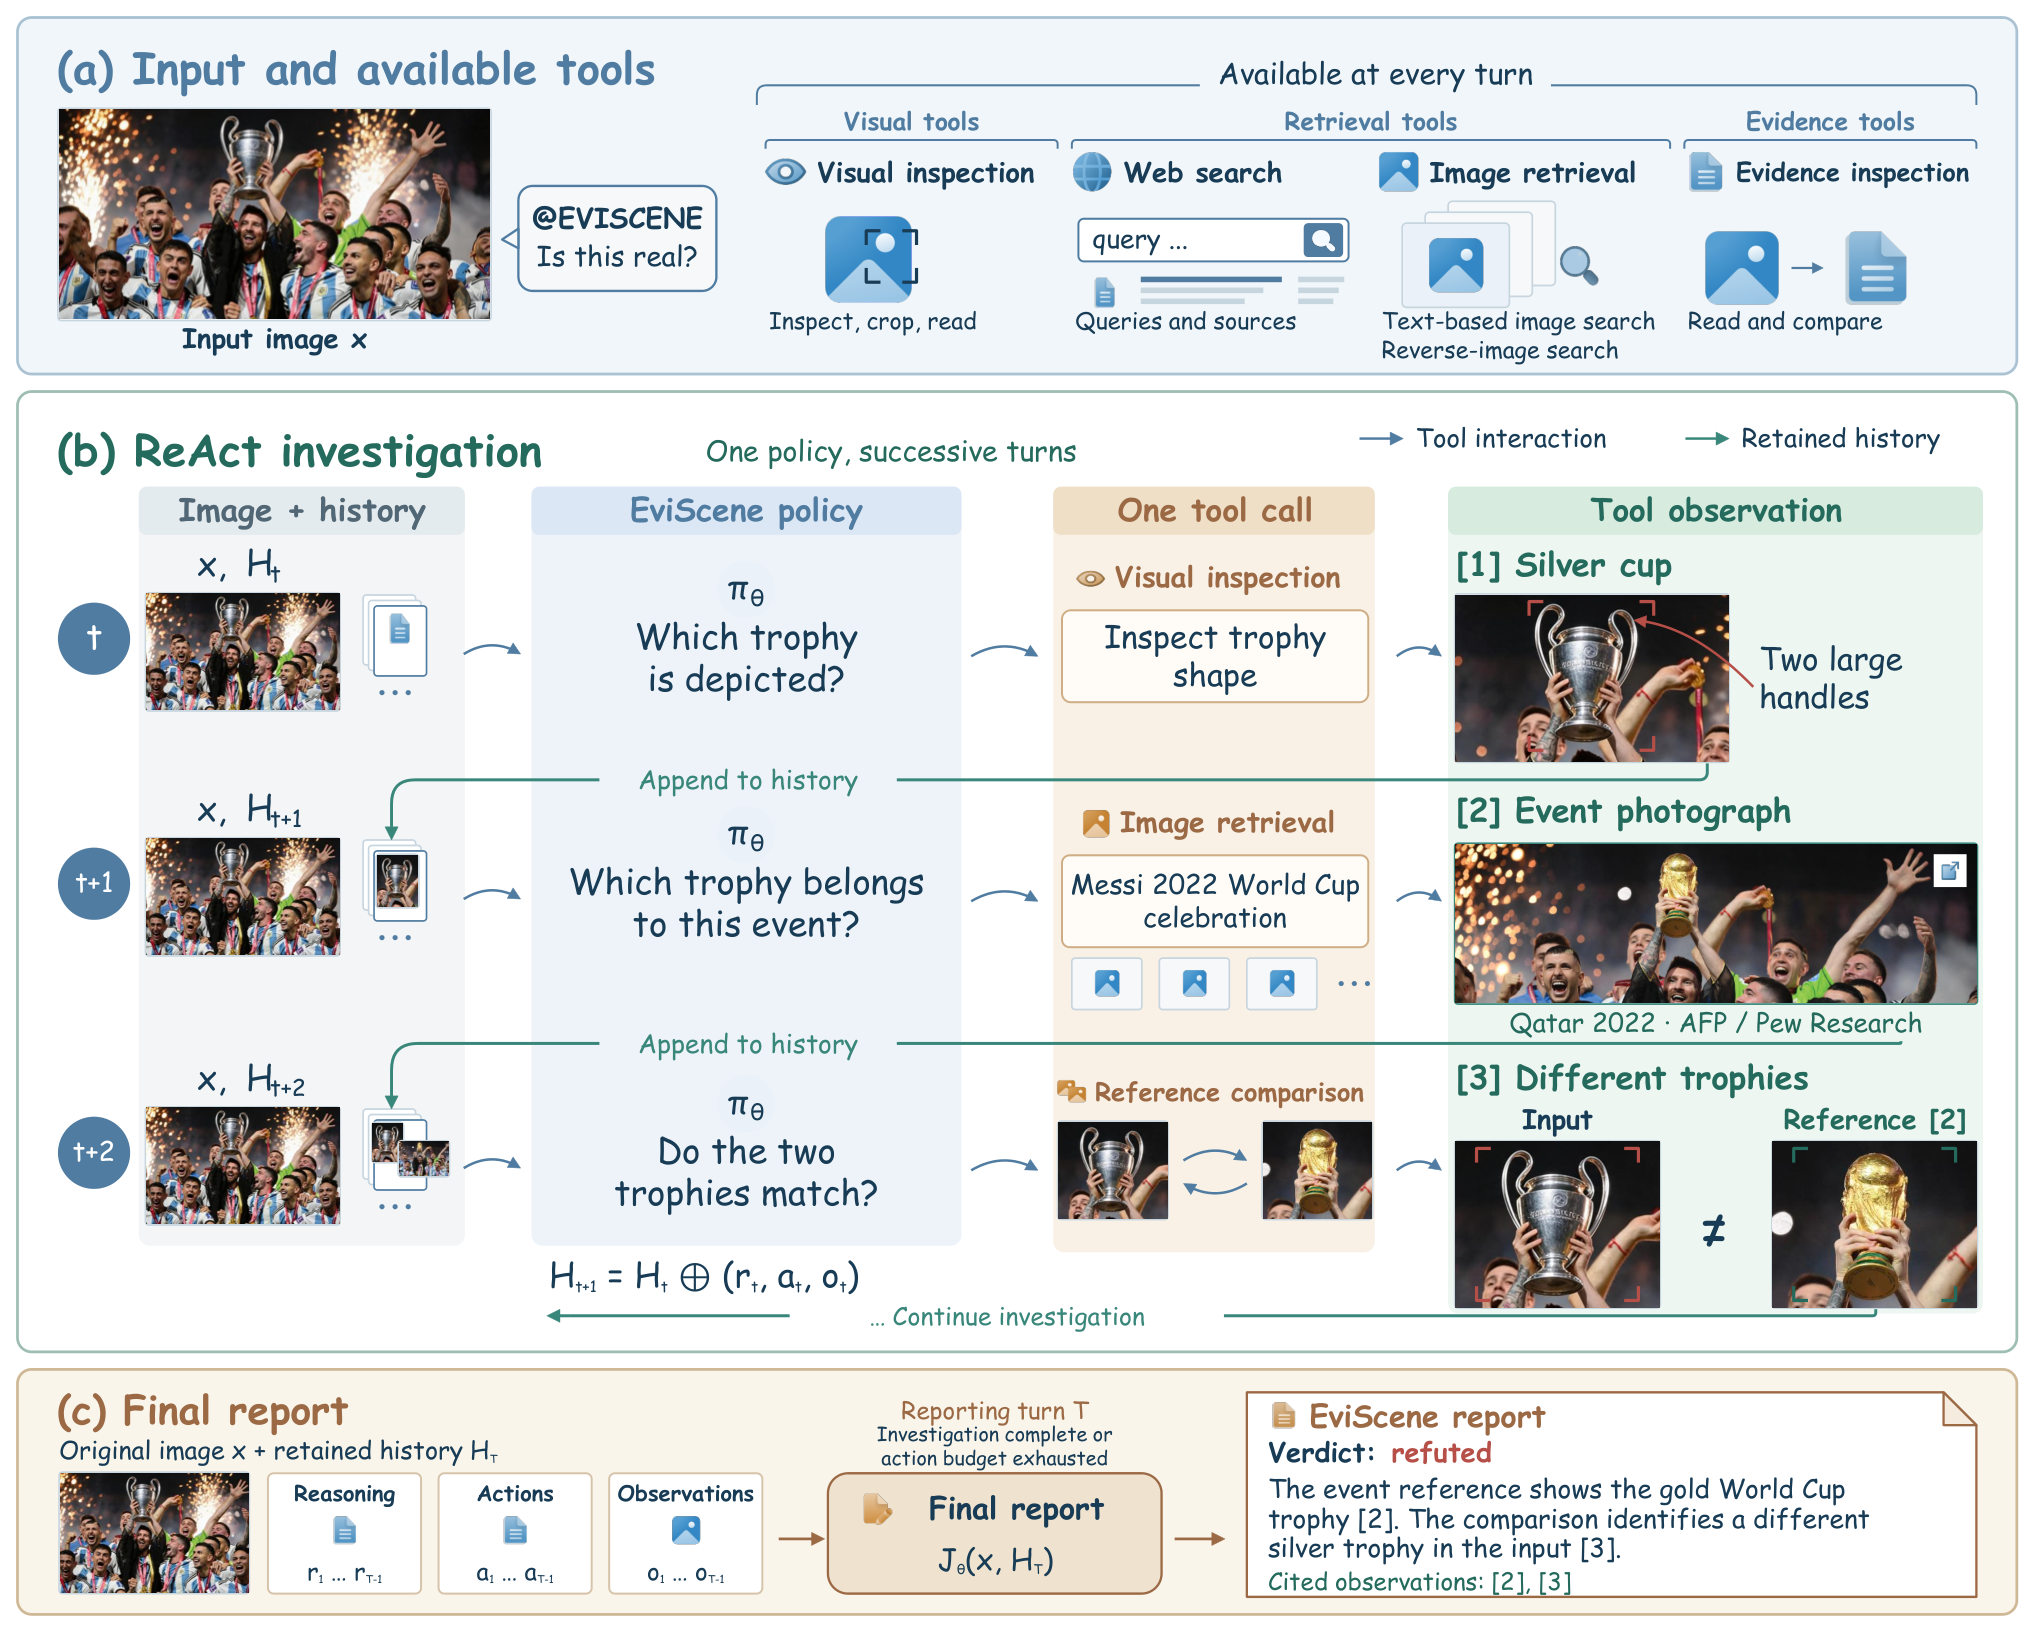
Figure 4 — EviScene의 조사 및 보고 아키텍처
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
- [논문리뷰] Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory
- [논문리뷰] Understanding and Enhancing Backdoor Persistency in LLM Agent Post-Training
- [논문리뷰] MetroLLM-Bench: Evaluating Language Models as Transit Kiosk Runtimes
- [논문리뷰] Revisiting Complete Reasoning Traces for Post-Training
Review 의 다른글
- 이전글 [논문리뷰] EgoExplorer: A Vision-Motion-Touch Observatory for Human Loco-Manipulation In Situ
- 현재글 : [논문리뷰] EviScene: Beyond 'Is It AI?' for Agentic Image Factuality Assessment
- 다음글 [논문리뷰] ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
댓글