[논문리뷰] AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
링크: 논문 PDF로 바로 열기
저자: Bingxiang He, Pengqi Sun, Shihao Peng, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- AutoSFT: LLM post-training에서 SFT 데이터 연구를 자동화하기 위해 제안된 multi-agent system입니다.
- Data Action Space: 데이터 엔지니어가 SFT 데이터에 적용하는 6가지 유형의 변경 사항(예: mixture, pruning, repair, resupervision, replace, write new example, order)을 정의한 공간입니다.
- Executor Subagent: Meta agent의 context 부담을 줄이기 위해, training, checkpoint conversion, evaluation과 같은 실행 단계를 독립적인 세션에서 수행하고 결과물의 경로만 반환하는 전담 에이전트입니다.
- Analysis Subagents: Training data, failure cases, learning dynamics, research history의 네 가지 관점에서 현재 라운드의 결과를 분석하고, meta agent에게 실행 가능한 데이터 변경 제안을 제공하는 전문 에이전트 그룹입니다.
- Synthesis Subagent: 초기 데이터 풀에 충분히 커버되지 않는 undersupplied capabilities에 대해 새로운 예시 데이터를 생성하고 검증하여 데이터 풀을 확장하는 에이전트입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 LLM agents가 post-training 과정에서 supervised fine-tuning (SFT) 데이터 수정에 대부분의 노력을 기울임에도 불구하고, 실제 데이터 엔지니어가 수행하는 다양한 데이터 조작(pruning, repair, replace, synthesize 등)을 포괄적으로 자동화하지 못하는 문제를 제기합니다. 기존 시스템들은 주로 고정된 풀에서 데이터를 선택하거나 단순히 데이터를 생성하는 단일 제어 방식에 국한되어, SFT data research 과정의 비효율성과 높은 수동 개입 비용을 야기합니다. 저자들은 단일 에이전트 환경에서 SFT data research loop를 실험한 결과, 에이전트가 mixture data action에만 집중하고, 방대한 실행 로그로 인해 context가 소실되며, 데이터 분석보다는 실행에 대부분의 context를 할애하는 세 가지 주요 실패 모드를 발견했습니다. 이러한 한계는 데이터 연구의 다양성 부족과 효율성 저하로 이어져, LLM 성능 향상을 위한 체계적이고 자동화된 데이터 연구 접근 방식의 필요성을 강조합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 SFT data research의 한계를 극복하기 위해 AutoSFT라는 multi-agent system을 제안합니다. AutoSFT는 meta agent를 중심으로 Executor Subagent, 네 종류의 Analysis Subagents, 그리고 Synthesis Subagent로 구성됩니다 [Figure 1]. Executor Subagent는 training, checkpoint conversion, evaluation의 모든 실행 lifecycle을 담당하고, meta agent에게는 간결한 상태 보고서와 artifact 경로만을 반환하여 context loss를 절반으로 줄이는 데 기여합니다 [Figure 7]. 네 종류의 Analysis Subagents는 training data, failure cases, learning dynamics, research history라는 상호 보완적인 관점에서 라운드의 결과를 분석하고, 각각 실행 가능한 데이터 변경 제안을 생성합니다. 마지막으로 Synthesis Subagent는 기존 데이터 풀에서 부족한 undersupplied capability targets에 대해 검증된 새로운 데이터를 생성하여 데이터 풀을 확장합니다. 모든 실험은 from-base retraining 방식으로 진행되어 각 구성 요소의 기여도를 명확히 파악할 수 있습니다 [Figure 2].
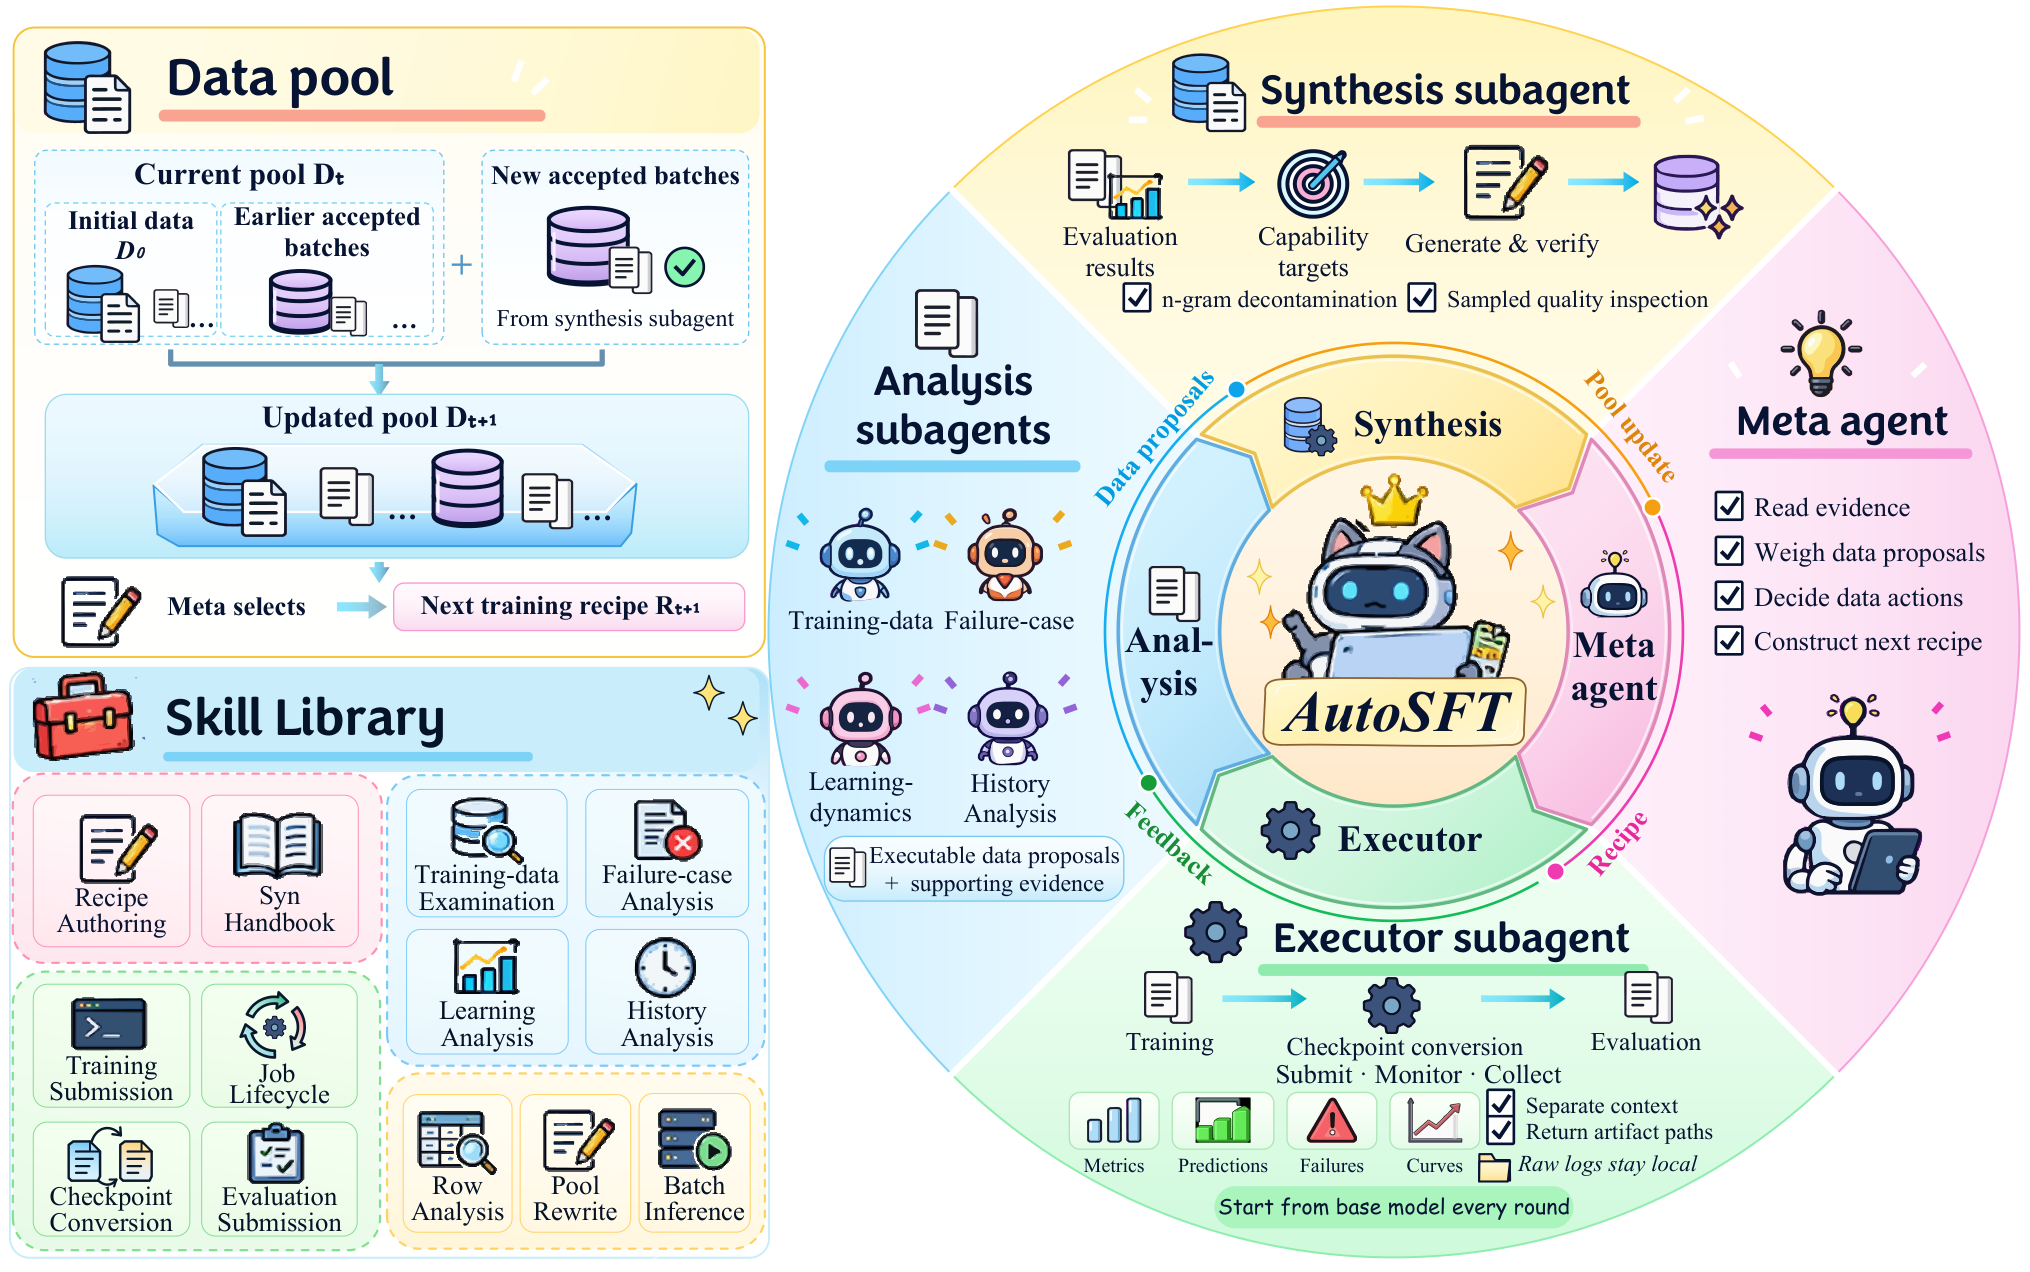
Figure 1 — AutoSFT 시스템 개요
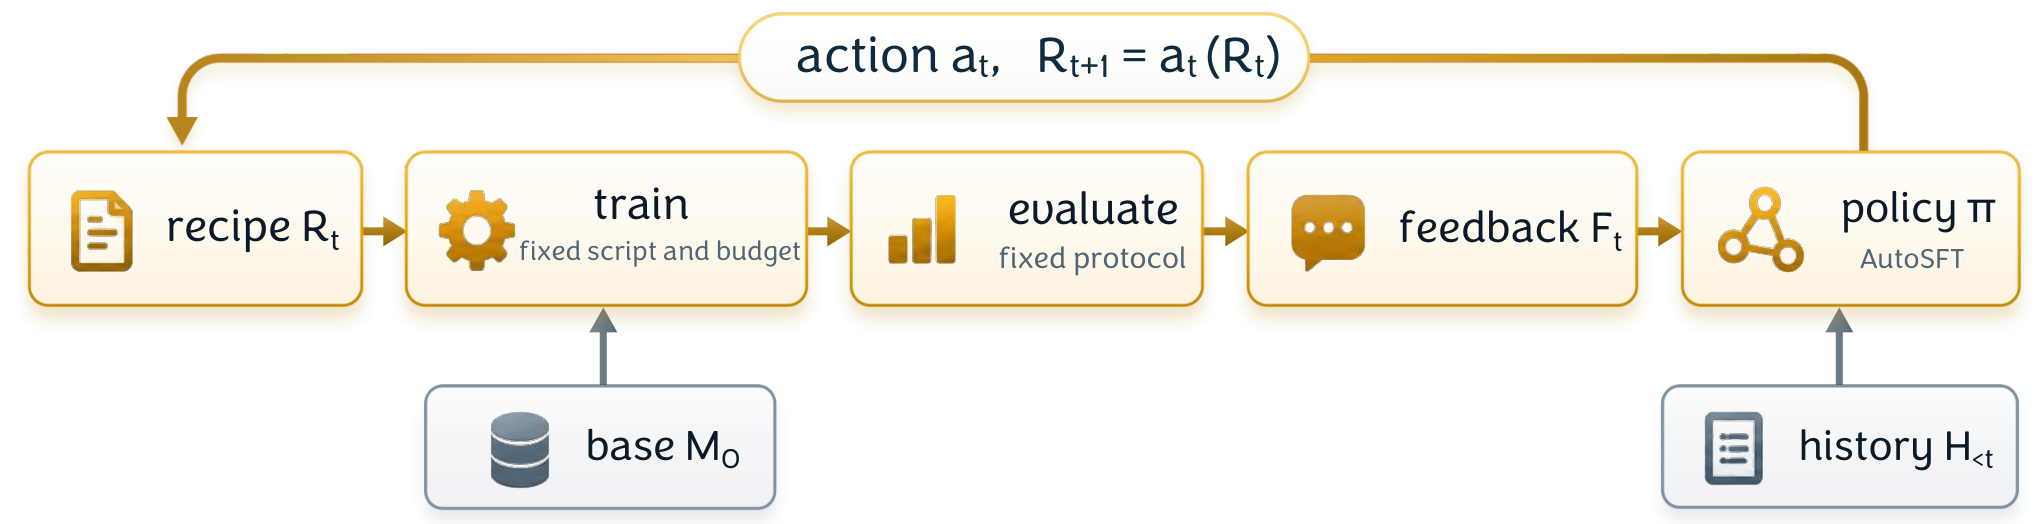
Figure 2 — 연구 루프의 한 라운드
핵심 결과는 다음과 같습니다:
- Executor Subagent 도입 후, meta agent의 context 손실 빈도가 절반으로 감소하여, 연구 이력 관리가 효율적으로 개선되었습니다 [Figure 7].
- Analysis Subagents는 단일 에이전트가
mixtureaction에만 머무르는 한계를 넘어repair,resupervision과 같은 다양한 data action을 활성화시켰습니다 [Figure 8]. 이는 IFEval 점수를 단일 에이전트 대비 +6.5 포인트 향상시켰으며, 더 이른 라운드에 높은 성능에 도달하게 했습니다 [Figure 8]. - Synthesis Subagent의 추가는 IFEval에서 +3.4 포인트, IFBench에서 +2.9 포인트의 추가적인 성능 향상을 가져왔습니다 [Figure 9]. 특히, repeat_prompt capability의 strict pass rate는 Synthesis Subagent의 데이터 생성 이후 ~40%에서 75.6%로 크게 상승했습니다 [Figure 15].
- AutoSFT는 code generation domain인 MBPP+ benchmark에서도 효과적인 일반화 능력을 보였습니다. Analysis Subagents만으로 단일 에이전트 대비 **+3.7 MBPP+**의 성능 향상을 달성했으며, 전체 시스템(Analysis + Synthesis)은 더 적은 라운드 내에 유사한 최고 성능에 도달했습니다 [Figure 9].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 SFT data research loop에서 단일 에이전트가 겪는 context loss 및 data action 다양성 부족 문제를 해결하기 위해 AutoSFT라는 multi-agent system을 성공적으로 제안합니다. Executor Subagent를 통한 실행 분리, Analysis Subagents를 통한 다각적인 관점에서의 제안 취합, 그리고 Synthesis Subagent를 통한 새로운 데이터 생성 기능은 시스템의 효율성과 효과성을 크게 향상시켰습니다. 이 연구는 SFT data research 자동화의 핵심이 단일 data action의 강화보다는 데이터 엔지니어가 수행하는 광범위한 변경 사항을 포괄할 수 있는 구조, 즉 multi-agent decomposition에 있음을 시사합니다. AutoSFT는 instruction following 및 code generation과 같은 다양한 도메인에서 LLM의 성능을 향상시키는 데 있어 수동적인 데이터 준비의 부담을 줄이고, 보다 체계적이고 자동화된 접근 방식을 제공함으로써 LLM 개발 및 응용 분야에 중요한 기여를 할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Understanding and Enhancing Backdoor Persistency in LLM Agent Post-Training
- [논문리뷰] SWE-CI: Evaluating Agent Capabilities in Maintaining Codebases via Continuous Integration
- [논문리뷰] AIRS-Bench: a Suite of Tasks for Frontier AI Research Science Agents
- [논문리뷰] ABC-Bench: Benchmarking Agentic Backend Coding in Real-World Development
- [논문리뷰] Live-SWE-agent: Can Software Engineering Agents Self-Evolve on the Fly?
Review 의 다른글
- 이전글 [논문리뷰] Athanor: An Agent-Native System for Autonomous Post-Training Research
- 현재글 : [논문리뷰] AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
- 다음글 [논문리뷰] CoDA: Co-Evolution of Data Engines and Action Policies
댓글