[논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
링크: 논문 PDF로 바로 열기
저자: Qi Lu, Jiarun Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Vision-Language-Action (VLA) models: Pretrained vision-language 모델의 semantic knowledge를 로봇 제어에 transfer하여, visual observation과 task instruction을 robot action에 매핑하는 모델입니다.
- Physical State Transition: 현재 상태(current state)와 미래 상태(future state) 간의 물리적 변화(object poses, spatial relations, robot-object contacts)를 명시적인 학습 목표(explicit learning targets)로 활용하는 개념입니다.
- Physical State Difference Queries: VLA-Δ의 vision-language backbone 내에 통합된 learnable 컴포넌트로, vision-language 정보를 물리적 상태 전이 표현(physical state-transition representation)으로 organize하는 역할을 합니다.
- Structured Transition Slots: Task-relevant한 상태 변수 및 그 변화를 9가지 카테고리(예: task progress, gripper position, contact transitions)로 조직화하여 Queries에 semantic division of labor를 부여하는 structured supervision 방식입니다.
- Future-State Difference Text: Current state와 future state 간의 task progress, spatial changes, contact transitions, 그리고 관련 physical constraints를 natural language로 일관성 있게(coherent) 기술하는 supervision 신호입니다.
- Optical Flow: Current observation과 subsequent observation 사이의 dense한 2차원 변위(two-dimensional displacements)를 통해 fine-grained visual motion을 supervise하는 신호입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 Vision-Language-Action (VLA) 모델들이 물리적 역학(physical dynamics)에 대한 제한적인 이해로 인해 실패하는 문제를 해결하고자 합니다. 대다수의 VLA 모델은 중간 물리적 상태 변화(intermediate physical state changes)에 대한 명시적인 supervision 없이 observation을 demonstrated actions에 직접 매핑하여, observation-action correspondences에 과적합(overfitting)되는 경향이 있습니다. 이는 로봇이 task 진행에 따라 환경이 어떻게 변해야 하는지에 대한 추론(reasoning) 없이 단순히 memorized trajectory를 replay하는 것처럼 보이는 실패 사례로 이어집니다.
기존 연구들은 Reasoning VLAs, World Action Models (WAMs), Latent-WAMs 등을 통해 언어, 시각, 또는 latent space에서 중간 추론(intermediate reasoning)이나 미래 상태 예측(future-state prediction)을 도입하여 암묵적으로 상태 변화를 모델링했습니다 [cite: 1, Figure 1]. 그러나 이들 방법은 high-level task planning이나 future visual appearance를 주로 supervise하며, object poses, spatial relations, robot-object contacts와 같은 물리적 상태 전이 자체를 명시적으로 supervise하지 못했습니다. 이러한 한계는 task semantics만으로는 객체의 움직임을 특정할 수 없고, visual appearance만으로는 task에 중요한 변화가 무엇인지 알 수 없는 gap을 야기하며, 이는 로봇이 정확한 동작을 수행하는 데 필요한 핵심 정보를 놓치게 만듭니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 VLA-Δ를 제안하며, physical state transition을 명시적인 학습 목표로 사용하여 Vision-Language-Action (VLA) 모델의 물리적 역학 이해를 심화합니다 [cite: 1, Figure 2]. VLA-Δ는 learnable Physical State Difference Queries를 vision-language backbone에 통합하여 current observation과 task instruction에 conditioned된 unified transition representation을 형성합니다. 이 representation은 pretraining 단계에서 세 가지 multilevel supervision pathway를 통해 학습됩니다. 첫째, Structured Transition Slots는 task-relevant한 9가지 state variables 및 그 변화에 대한 structured supervision을 제공하여 Queries 간의 semantic division of labor를 유도합니다 [cite: 1, Figure 3]. 둘째, Optical Flow는 current 및 subsequent observation 간의 dense visual motion을 supervise하여 representation이 fine-grained motion details을 유지하도록 합니다. 셋째, Future-State Difference Text는 autoregressive generation을 통해 task progress, spatial displacement, contact changes 및 physical constraints에 대한 coherent semantic supervision을 제공합니다 [cite: 1, Figure 3]. 이러한 세 가지 신호는 Queries가 task semantics와 visual motion changes를 공동으로 encode하도록 유도하여 continuous action generation을 지원합니다. VLA-Δ는 또한 약 484시간, 2400만 프레임 규모의 pretraining dataset을 구축하고 automated data annotation pipeline을 통해 multilevel physical state-transition annotations를 생성합니다. Inference 시 모델은 중간 supervision targets의 decoding 없이 current observation으로부터 직접 action을 생성합니다.
VLA-Δ는 시뮬레이션 및 실제 로봇 실험에서 뛰어난 성능을 입증했습니다. LIBERO 벤치마크에서 98.4%의 평균 성공률을 달성하여 비교 대상 모든 방법을 능가했습니다 [cite: 1, Table 1]. 특히, LIBERO-Plus의 Language perturbation 환경에서 π0.5 대비 6.4 percentage points 높은 89.0%의 성공률을 기록하여, Future-State Difference Text의 명시적 semantic information이 언어 variation에 대한 모델의 sensitivity를 줄임을 시사했습니다 [cite: 1, Figure 4]. RoboTwin 2.0에서는 Clean 및 Random setting 모두에서 각각 90.06%와 89.74%의 평균 성공률로 모든 비교 baseline을 outperform하며, 특히 ZR-0 대비 1.36 및 1.76 percentage points의 개선을 보였습니다 [cite: 1, Table 2]. 실제 로봇 실험에서는 AgileX PiPER 6-DoF dual-arm 플랫폼에서 5가지 조작 task에 걸쳐 평균 68.0%의 성공률을 달성하며 π0.5를 5.5% outperform했습니다 [cite: 1, Figure 5]. Obstacle avoidance task에서 42.5%로 가장 높은 성공률을 보였는데, 이는 Future-State Difference Text의 Object Constraints supervision 덕분으로 분석됩니다. Ablation study 결과, Physical State Difference Queries, Future-State Difference Text, Structured Transition Slots, Dense Optical Flow 각각이 성능 향상에 기여하며, 특히 Structured Transition Slots는 Query representations의 semantic separability를 강화하는 것으로 나타났습니다 [cite: 1, Table 3, Figure 6].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Vision-Language-Action (VLA) 모델의 핵심 문제인 물리적 역학 이해 부족을 해결하기 위해, 현재와 미래 상태 간의 물리적 변화를 명시적인 학습 목표로 사용하는 VLA-Δ 프레임워크를 제안합니다. VLA-Δ는 task semantics, structured state variables, dense visual motion을 포괄하는 multilevel physical state-transition supervision을 통해 보다 포괄적인 transition representation을 학습합니다. 이러한 supervision 신호는 pretraining 단계에서만 사용되어 downstream policy learning을 위한 강력한 representational foundation을 제공하며, deployment 시에는 추가적인 inference overhead 없이 효율적인 action generation이 가능합니다.
이 연구는 LIBERO, RoboTwin 2.0 벤치마크에서의 SOTA(State-of-the-Art)에 준하는 성능과 실제 로봇 환경에서의 탁월한 평균 성공률을 통해 제안 방법론의 효과성을 입증했습니다. 특히, multilevel physical state-transition supervision이 task-relevant한 상태 변화 및 그 제약 조건을 학습하고 이를 continuous control로 전환하는 데 결정적인 역할을 함을 시사합니다. VLA-Δ는 명시적인 물리적 상태 변화 학습을 통해 더욱 일반화되고 견고한 로봇 정책 개발에 기여하며, 이는 향후 Embodied AI 및 로봇 조작 분야의 발전에 중요한 시사점을 제공합니다.
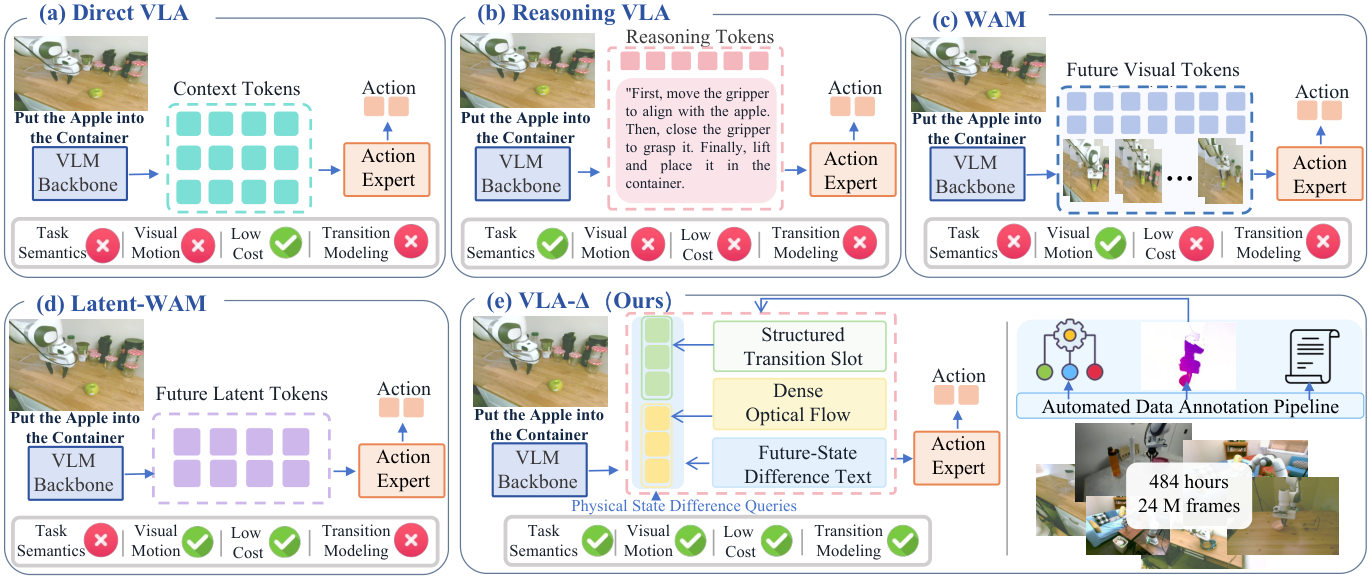
Figure 1 — 전이 모델링 패러다임 비교
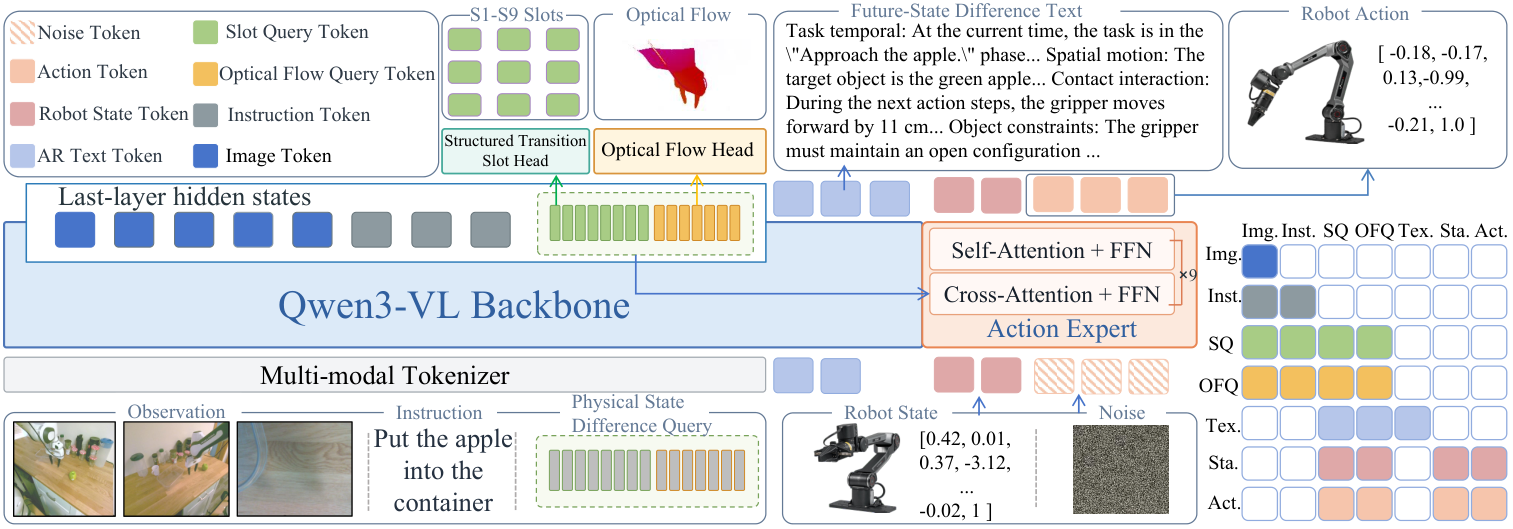
Figure 2 — VLA-Δ 전체 아키텍처
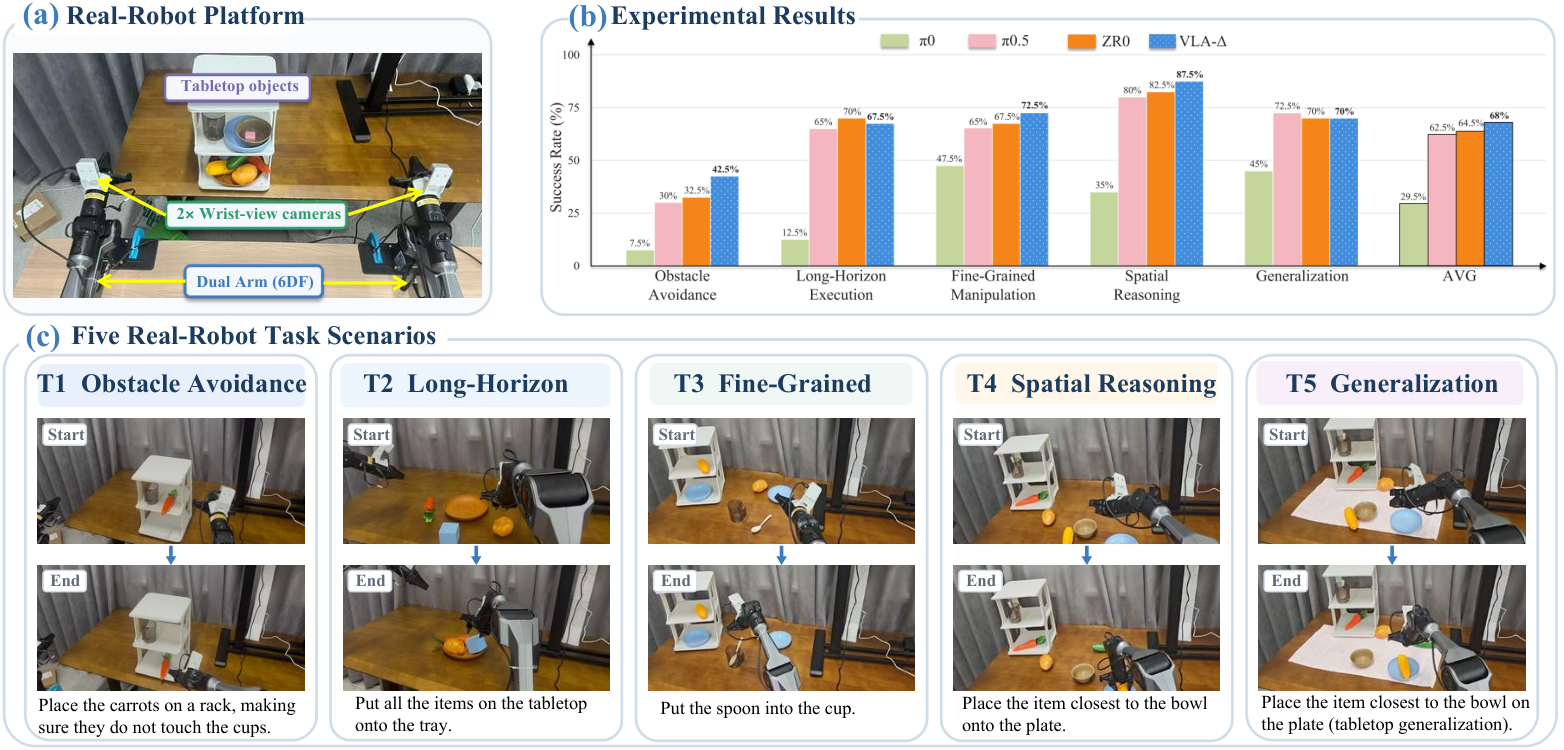
Figure 5 — 실제 로봇 평가 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] PerturBot: Breaking Shortcut Priors in Vision-Language-Action Models with Perturbative Training
- [논문리뷰] BridgeVLA++: A Data-Efficient, Generalizable, and Memory-Augmented Vision-Language-Action Framework for 3D Manipulation
- [논문리뷰] ABot-AgentOS: A General Robotic Agent OS with Lifelong Multi-modal Memory
- [논문리뷰] Robots Need More than VLA and World Models
Review 의 다른글
- 이전글 [논문리뷰] Speculative Forcing for Efficient Autoregressive Video Generation
- 현재글 : [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
- 다음글 [논문리뷰] Virtual Head Attention
댓글