[논문리뷰] OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
링크: 논문 PDF로 바로 열기
저자: Yingdong Shi, Zhihong Li, Changming Li, Jingyi Yu, Quan Li, Kan Ren
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- OPMD (On-Policy Mechanism Distillation): 교사의 중간 연산 과정(latent state)을 학생 모델이 내부화하도록 유도하여 단순히 출력값만 맞추는 기존 방식의 한계를 극복하는 학습 프레임워크입니다.
- Student-Compatible Teacher: 교사의 중간 표현을 학생 모델의 downstream computation에 적합한 형태로 변환하여 주입하는 중간 단계의 구조입니다.
- On-Policy Internalization: 학생 모델이 자체적으로 생성한 trajectory 상에서 교사의 중간 연산 결과물(latent states)을 모사하도록 학습하는 과정입니다.
- Activation Patching: 모델의 특정 계층에서 중간 활성 값을 다른 모델의 값으로 교체하여 성능 변화를 측정함으로써, 해당 중간 상태가 연산에 미치는 인과적 영향을 분석하는 기법입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존의 On-Policy Distillation(OPD)이 교사의 출력 분포만을 모사할 뿐, 복잡한 추론 과정에 필요한 중간 연산(intermediate computation)을 효과적으로 전이하지 못한다는 문제점을 해결하고자 합니다. 단순히 출력값(output-level)을 맞추는 것만으로는 모델 간 표현 공간의 기하학적 차이나 연산 경로의 불일치를 완벽히 해소할 수 없으며, 이는 특히 추론 능력이 중요한 태스크에서 심각한 정보 손실을 야기합니다. 연구진은 [Figure 1]을 통해 RL-optimized 모델의 중간 상태가 기본 모델의 downstream 연산에서 유의미하게 활용될 수 있음을 증명하였으며, 단순히 hidden state를 MSE로 맞추는 방식이 오히려 성능을 저해할 수 있음을 확인하였습니다. 따라서 교사의 중간 정보를 학생이 직접적으로 사용하여 연산 능력을 내재화할 수 있는 새로운 메커니즘 수준의 증류 기법이 요구됩니다.
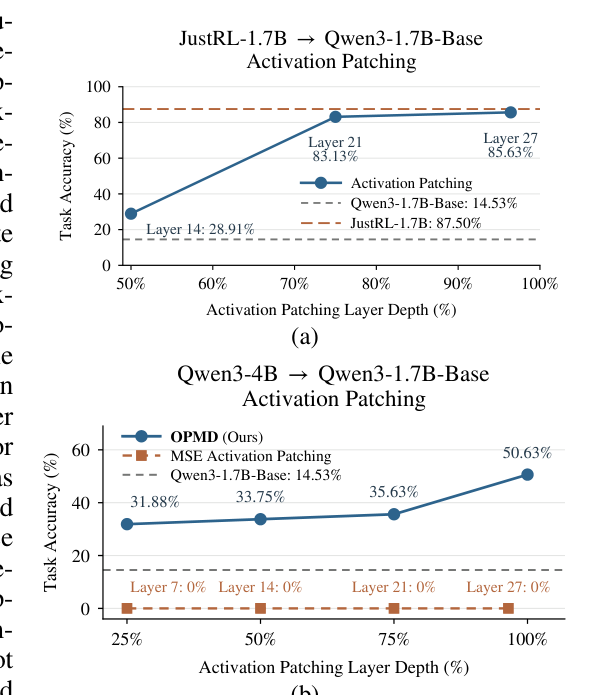
Figure 1 — RL-optimized latent state가 성능에 미치는 인과적 영향력을 분석하는 핵심 실험 그래프
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 Student-Compatible Teacher를 구축하고 이를 On-Policy Internalization을 통해 내재화하는 2단계 학습 방법론을 제안합니다. Stage I에서는 교사와 학생 모델을 고정한 상태에서 학습 가능한 projector를 통해 교사의 latent state를 학생의 hidden space로 투영하여 연산 유용성을 극대화합니다. 이후 Stage II에서는 native student가 해당 교사 모델의 연산 궤적을 모사하도록 학습합니다. [Table 1]에 따르면, 제안 모델인 OPMD는 AMC 벤치마크에서 기존 OPD 대비 3.76~7.04%p 높은 정확도 향상을 보이며, 특히 RL-Math와 같은 강력한 교사 모델을 사용할 때 성능 개선 폭이 더욱 두드러집니다. 추가적인 실험을 통해 OPMD가 단순 토큰 생성 길이 증가가 아닌, 더 효율적인 추론 전략을 학습했음이 증명되었으며, 이는 [Figure 3]의 1,024 step 궤적을 통해 모델이 지속적인 학습을 통해 성능 정점에 도달함을 알 수 있습니다.
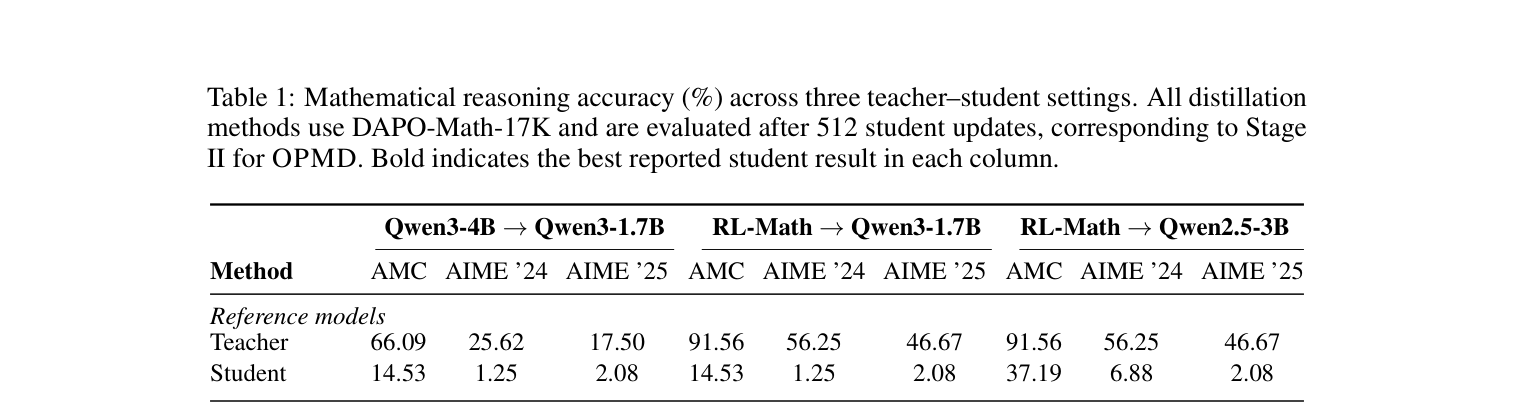
Table 1 — 제안 방법론 OPMD와 기존 Baselines(OPD, SFT, OPRD-Bridge)의 정량적 성능 비교표
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 중간 연산 메커니즘을 전이하는 것이 모델의 추론 능력을 실질적으로 향상시키는 핵심 요소임을 규명하며, OPMD라는 새로운 distillation 패러다임을 제시했습니다. 이 연구는 단순히 '무엇(what)'을 예측하는지를 넘어 교사가 '어떻게(how)' 추론하는지를 성공적으로 학생 모델에 전이함으로써, 경량화된 모델이 강력한 성능을 갖추게 하는 실용적인 방법을 제공합니다. 본 방법론은 다양한 도메인과 아키텍처 간의 전이를 지원하며, 향후 대규모 언어 모델의 지식 증류 및 추론 능력 최적화 분야에 중요한 학술적 근거를 제공할 것으로 기대됩니다.
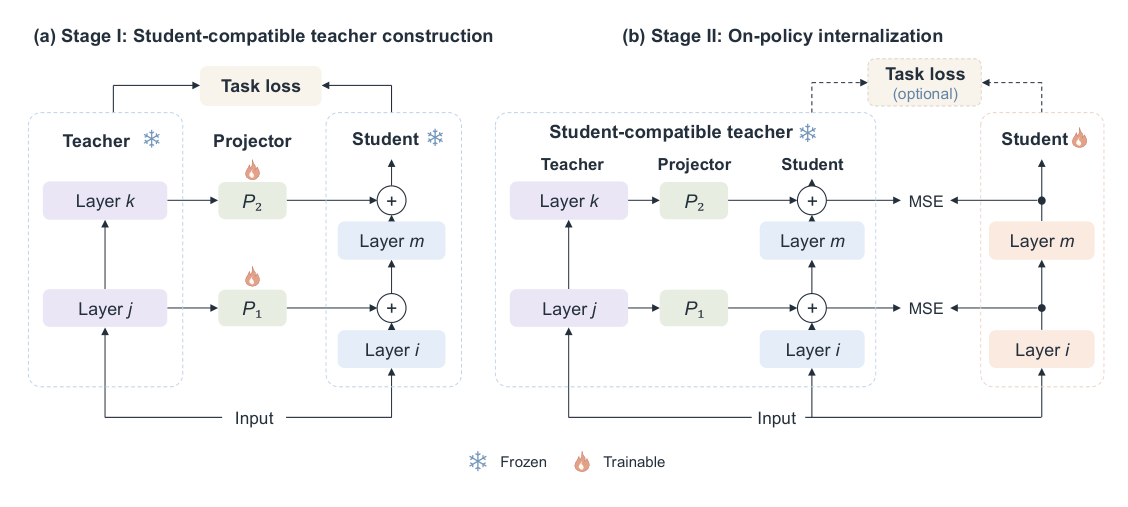
Figure 2 — OPMD의 2단계 학습 과정을 보여주는 전체 프레임워크 다이어그램
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SPOT: Sparse Probing and Outcome Calibration for On-Policy Distillation
- [논문리뷰] Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
- [논문리뷰] Failure Recovery via Belief Updates and World Modeling for Long-Horizon Agents
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
Review 의 다른글
- 이전글 [논문리뷰] MorphAct: Robot Policies Morphing with the Worlds They Act In
- 현재글 : [논문리뷰] OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
- 다음글 [논문리뷰] OS-Helix: Unifying GUI Interaction and Code Execution in Native Computer-Using Agents
댓글