[논문리뷰] EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
링크: 논문 PDF로 바로 열기
저자: Xinhao Ji, Hui En Pang, Hao Li, Kairui Hu, Jiner Wang, Mingze Sun, Ziang Cao, Yalun Dai, Thang Luu, Qin Ma, Hongyi Chen, Yukang Cao, Fangzhou Hong, Zhaoxi Chen, Ziwei Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Egocentric Video: 사용자 자신의 시점에서 촬영된 비디오로, 착용형 카메라를 통해 수집됩니다.
- World-Grounded Representation: 카메라, 장면, 손, 객체 등 다양한 3D 구성 요소들이 일관된 공통의 3D 세계 좌표계 내에서 재구성되는 것을 의미합니다.
- SLAM (Simultaneous Localization and Mapping): 알려지지 않은 환경의 지도를 구축함과 동시에 그 환경 내에서 에이전트의 위치를 추적하는 컴퓨테이셔널 문제입니다. 본 논문에서는 카메라 Pose 추정에 활용됩니다.
- 6-DoF (Six Degrees of Freedom): 3차원 공간에서 강체의 위치와 방향을 나타내는 6가지 자유도(3가지 translational, 3가지 rotational)를 지칭합니다.
- MANO (Model of an Articulated Hand in Object-space): 손의 자세(Pose)와 형태(Shape)를 모델링하는 데 사용되는 생성 모델입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Egocentric Video로부터 인간 활동을 재구성할 때, 개별적인 3D 구성 요소(카메라, 장면, 손, 객체)만을 복구하는 것을 넘어, 이들이 일관된 세계 내에서 조화롭게 통합되어야 하는 핵심 문제를 해결하고자 합니다. 기존 연구(Baseline)들은 이러한 밀접하게 Coupling된 구성 요소들 중 일부만을 복구하는 경향이 있으며, 서로 다른 방법론의 결과들을 결합하려면 불일치하는 Scale과 Coordinate Frame을 조정해야 하는 한계가 있었습니다. 또한, 통일된 모델을 학습시키기 위해서는 대규모의 Egocentric Data와 Camera, Scene, Hand, Object의 Joint Annotation이 필수적이지만, 잦은 Hand-Object Occlusion, 빠른 Head Motion, Motion Blur 등으로 인해 신뢰할 수 있는 Joint Annotation을 얻기가 매우 어렵습니다. 기존 Dataset들은 Calibrated Multi-camera 또는 Motion-capture 시스템에 의존하여 Annotation을 생성했으나, 이러한 시스템은 방대한 Setup과 Calibration을 필요로 하여 다양한 Real-world 환경에서 Scale Up하기 어렵다는 제약이 있습니다. 이러한 문제점들로 인해, Unified Feed-forward Framework를 통해 Camera, Scene, Hands, Objects를 Joint하게 Metric Reconstruction하고, Specialized Infrastructure에 대한 의존도를 줄이는 확장 가능한 Data Collection 및 Annotation Pipeline이 요구됩니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Egocentric 3D Reconstruction을 위한 End-to-End Paradigm인 EgoXperience를 제안합니다. 이 Paradigm은 데이터 수집, 자동 Annotation, Unified Modeling 및 Benchmarking을 포괄합니다 [Figure 1]. 핵심적으로, EgoX-Engine은 기하학적으로 검증된 Object Tracking과 SLAM 기반 World Alignment를 결합하여 카메라, 장면, 손, 객체에 대한 일관된 Supervision을 생성합니다 [Figure 3]. 이 엔진을 통해 EgoX-Data-6M이라는 50시간 분량의 Task-driven Manipulation 및 Locomotion 데이터셋을 구축했으며, 이는 Indoor 및 Outdoor 환경에서의 Second-level Task Caption을 포함합니다. 또한, EgoX-Data-6M에서 한 시간을 엄선하여 Joint Reconstruction 성능 평가를 위한 EgoX-Bench를 마련했습니다.
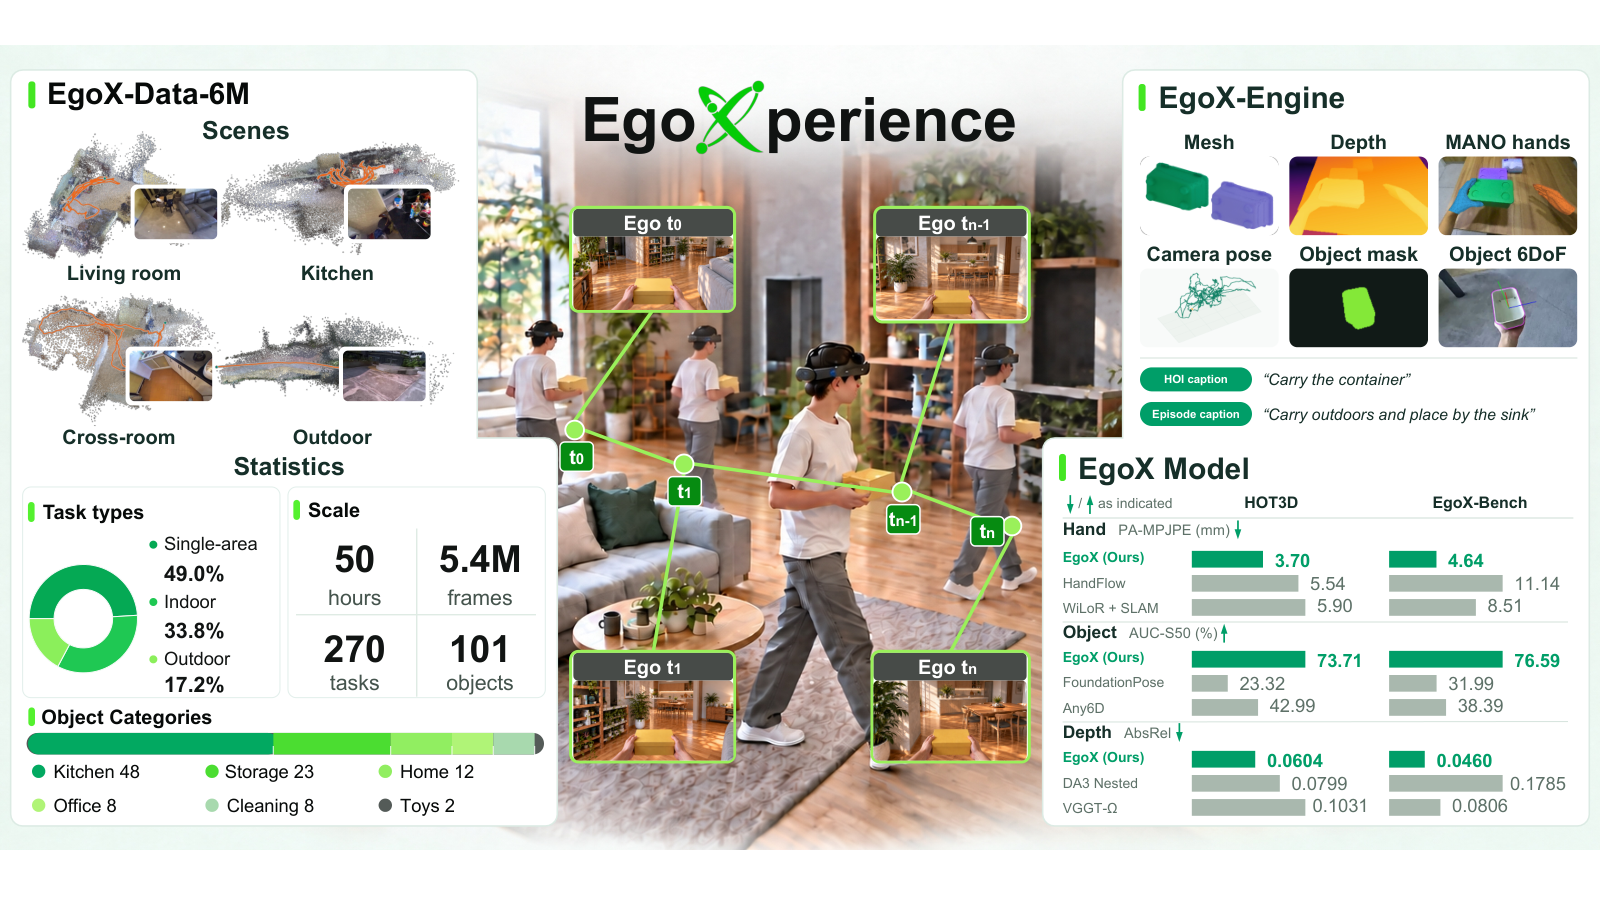
Figure 1 — EgoXperience 패러다임 개요
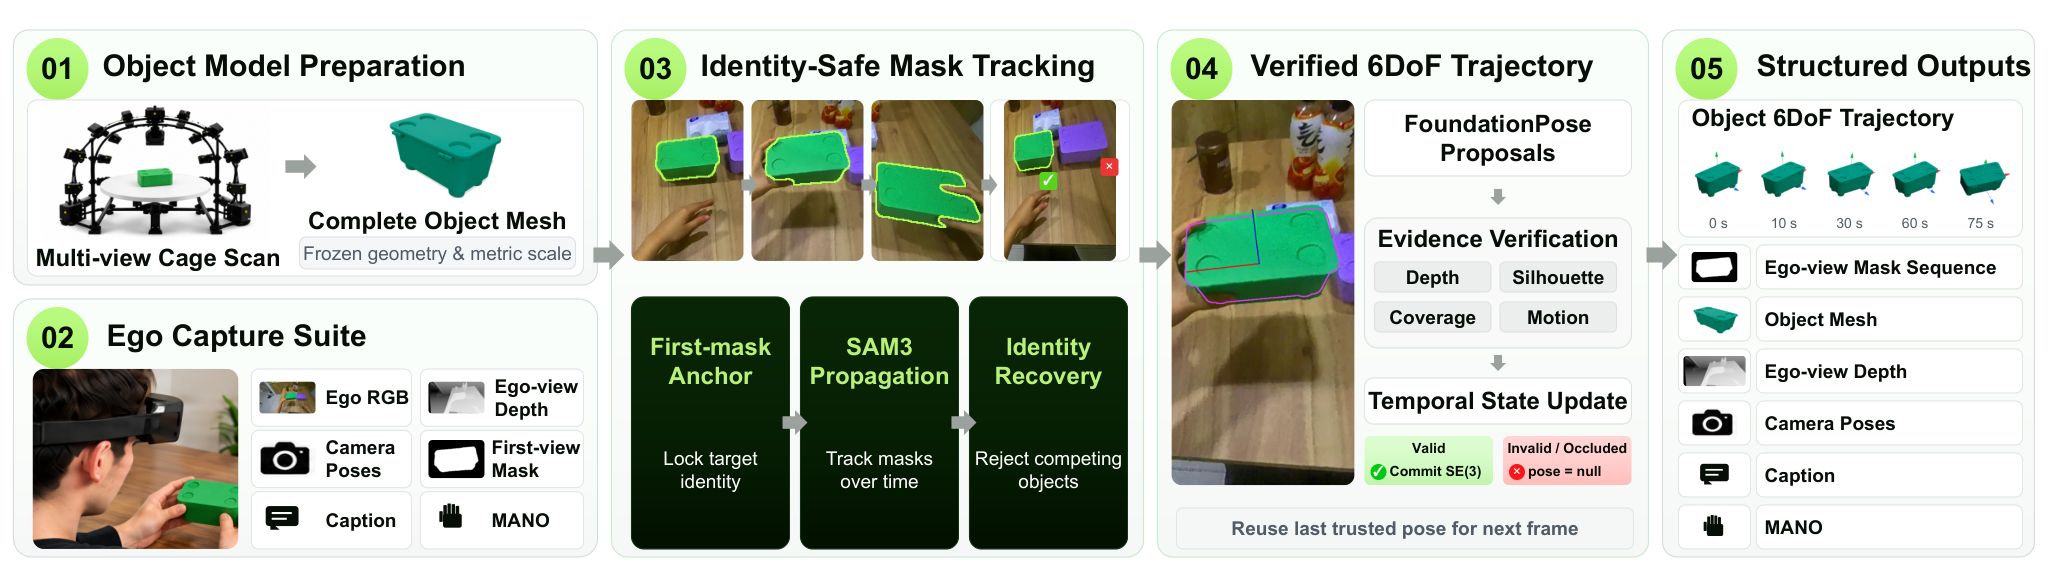
Figure 3 — EgoX-Engine 파이프라인 개요
이러한 Supervision을 Joint Reconstruction으로 변환하기 위해, 저자들은 EgoX 모델을 제안합니다 [Figure 4]. EgoX는 Monocular Egocentric Video와 First-frame Object Masks가 주어지면, 단일 Forward Pass 내에서 카메라, Dense Depth, 두 손의 MANO 상태, 객체의 6-DoF Pose를 Shared World Coordinate Frame에서 Metric Scale로 Joint하게 재구성합니다. EgoX는 DINOv3에서 추출된 Image Patch Features를 기반으로 하는 Shared Transformer를 사용하여 Joint Scene 및 Entity Representation을 형성합니다. 학습 과정에서, 개별 Prediction뿐만 아니라 예측된 카메라 Pose를 통해 World Coordinate System으로 변환된 Hand-Object Geometry에 대해서도 Geometrically Coupled Supervision을 적용하여 일관된 재구성을 유도합니다.
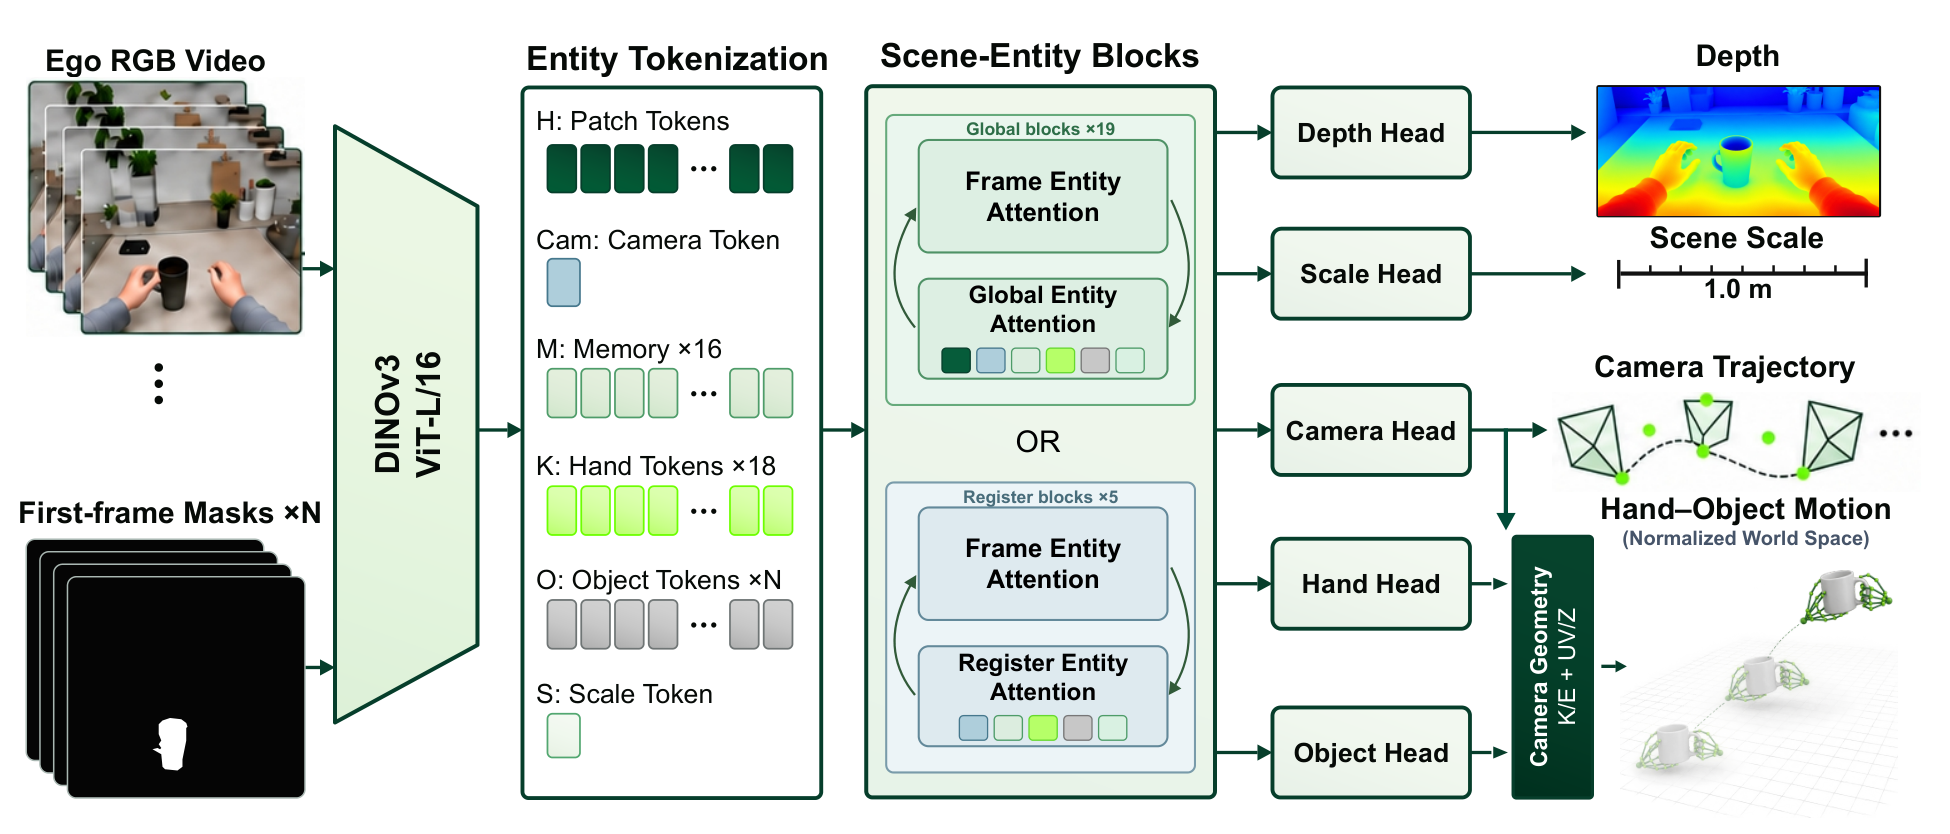
Figure 4 — EgoX 모델 아키텍처 개요
광범위한 실험 결과, EgoX는 Scene Estimation 및 World-space Hand-Object Pose Recovery에서 State-of-the-Art 성능을 달성했습니다. 특히, EgoX는 가장 강력한 Baseline 대비 HOI4D 벤치마크에서 카메라 nATE를 68.9% 감소시켰고, EgoX-Bench에서 손 W-MPJPE를 65.6%, Depth AbsRel을 42.9% 감소시켰습니다. 또한, HOT3D에서 Object Pose AUC-S_50_ Score를 28.0% 향상시켰습니다. 예를 들어, EgoX-Bench에서 Hand W-MPJPE는 WiLoR + SLAM의 328.81mm에서 EgoX의 113.24mm로 크게 감소했습니다. Depth Reconstruction에서는 EgoX-Bench에서 ReViV의 AbsRel 0.3972 및 VGGT-Ω의 0.0806 대비 EgoX는 0.0460을 달성하며 뛰어난 성능을 보였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Task-driven Capture, Geometrically Aligned Annotation 및 Joint Reconstruction을 통해 World-Grounded Egocentric Representation을 학습하는 Unified Approach인 EgoXperience를 제시합니다. EgoX-Engine은 50시간 분량의 EgoX-Data-6M에 대한 Aligned Multimodal Annotations를 제공하며, 여기서 Joint Reconstruction 평가를 위한 EgoX-Bench가 구성되었습니다. 이러한 Annotation 및 Harmonized Public Dataset으로 학습된 EgoX 모델은 Camera, Dense Depth, Hands, Rigid-Object 6-DoF Pose를 공통 Metric World Frame에서 Joint하게 재구성할 수 있습니다. 이 연구는 Egocentric 3D Reconstruction 분야에서 카메라, 장면 깊이, 손, 객체 간의 일관된 Metric Scale 추정이라는 주요 난제를 해결하며 상당한 발전을 이루었습니다. 특히, Unified Feed-forward Framework와 Scalable Annotation Pipeline은 Embodied AI 및 현실 세계의 3D 환경 상호작용 연구에 중요한 Dataset과 Benchmark를 제공하여 미래 연구 방향을 제시하는 데 크게 기여할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MultiBind: A Benchmark for Attribute Misbinding in Multi-Subject Generation
- [논문리뷰] EffectErase: Joint Video Object Removal and Insertion for High-Quality Effect Erasing
- [논문리뷰] Track4World: Feedforward World-centric Dense 3D Tracking of All Pixels
- [논문리뷰] YOLO Meets Mixture-of-Experts: Adaptive Expert Routing for Robust Object Detection
- [논문리뷰] Universal Image Restoration Pre-training via Masked Degradation Classification
Review 의 다른글
- 이전글 [논문리뷰] ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
- 현재글 : [논문리뷰] EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
- 다음글 [논문리뷰] Evidence-First Agentic Verification
댓글