[논문리뷰] UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling
링크: 논문 PDF로 바로 열기
저자: Kien T. Pham, Yuhao Liu, Chong Hou Choi, Zhenqi He, Yanghao Wang, Chenyang Lei, Rui Liu, Qifeng Chen, Long Chen
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- UniAVC: 텍스트 조건부 joint synthesis, 양방향 cross-modal 생성 및 instruction-guided 편집을 하나의 가중치 세트로 수행하는 통합 모델.
- Progressive Training: 학습을 Unimodal Pretraining과 Alignment Finetuning의 2단계로 분리하여 paired 데이터의 활용도를 극대화하는 학습 패러다임.
- Asymmetric Modality-Decoupled Schedulers: 영상과 오디오의 정보 밀도 차이를 고려하여 공유된 타임스텝 내에서 각 모달리티별로 독립적인 노이즈 스케줄링을 수행하는 기법.
- Intent-Aware Editing: 특정 모달리티를 $\sigma=0$으로 고정하여 참조(reference) 데이터로 활용함으로써 편집 시 원본 소스의 무결성을 보장하는 추론 모드.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 오디오-비디오 생성 및 편집 도구들이 독립적으로 파편화되어 있어 sequential pipeline 구성 시 발생하는 cross-modal 일관성 저하 문제를 해결하고자 합니다. 기존 방식은 데이터 부족을 해결하기 위해 paired 데이터를 개별 모달리티의 기본 역량을 학습하는 데 낭비하고 있으며, 두 모달리티를 단일 노이즈 스케줄로 처리하여 표현의 정보 밀도 차이를 무시하는 한계를 보입니다. 이러한 구조적 비대칭성은 영상과 오디오의 서로 다른 최적 denoising 궤적을 저해하여 결과물의 동기화 실패와 품질 저하를 초래합니다. 본 연구는 [Figure 2]와 같이 단일 스케줄의 한계를 분석하고, 통합 모델로서 이러한 문제들을 극복하는 설계를 제안합니다.
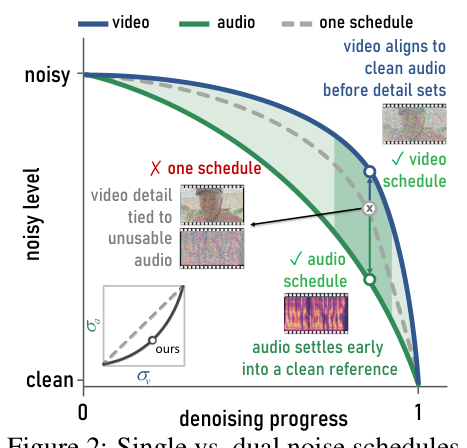
Figure 2 — 영상과 오디오 간의 정보 밀도 차이에 따른 비대칭 스케줄링의 필요성을 시각화한 핵심 개념도
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 모델은 2단계 학습 전략을 통해 각 모달리티의 전문성을 확보한 후 cross-modal 브리지만을 정밀 튜닝하여 고품질의 동기화를 구현합니다. 영상의 밀집된 spatio-temporal 구조와 오디오의 희소한 시퀀스를 독립적으로 처리하기 위해 모달리티별로 스케줄링을 warp하여, denoising 과정에서 오디오가 조기에 고정된 참조값으로 작동할 수 있도록 [Figure 3]의 비대칭 노이즈 스케줄러를 도입했습니다. 주요 실험 결과에 따르면, UniAVC는 JAVEditBench 및 InsAVE-80K 데이터셋에서 기존의 InstructAV2AV나 MiniMax-H3 모델 대비 우수한 성능을 입증하였습니다. 특히, AVQ(Audio-Visual Quality) 지표와 IC(Instruction Compliance) 지표에서 일관된 우위를 점하며 다목적 오디오-비디오 편집 분야에서 SOTA 수준의 정량적 결과를 달성했습니다.
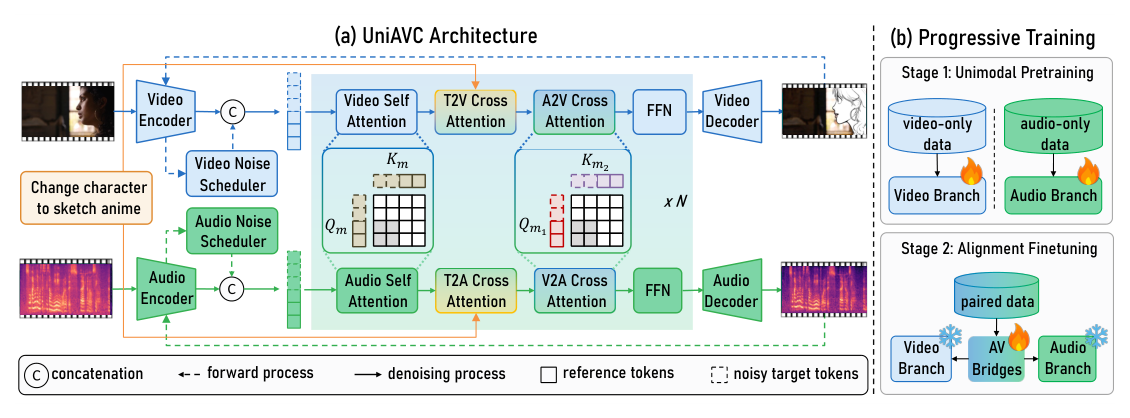
Figure 3 — UniAVC의 전체 아키텍처와 Progressive Training 과정을 보여주는 핵심 다이어그램
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 통합된 오디오-비디오 생성 및 편집을 위한 progressive training과 비대칭 스케줄링 프레임워크를 성공적으로 제안합니다. 이 연구는 단일 모델 가중치로 다양한 생성/편집 작업을 처리할 수 있는 효율성을 입증하였으며, 특히 비대칭적 노이즈 스케줄링을 통해 cross-modal 일관성을 강화하는 새로운 설계 지침을 제시했습니다. 이는 향후 다중 모달리티 통합 연구에서 데이터 효율성과 모델 확장성을 동시에 확보하는 핵심적인 레퍼런스가 될 것으로 기대됩니다.
Part 2: 중요 Figure 정보
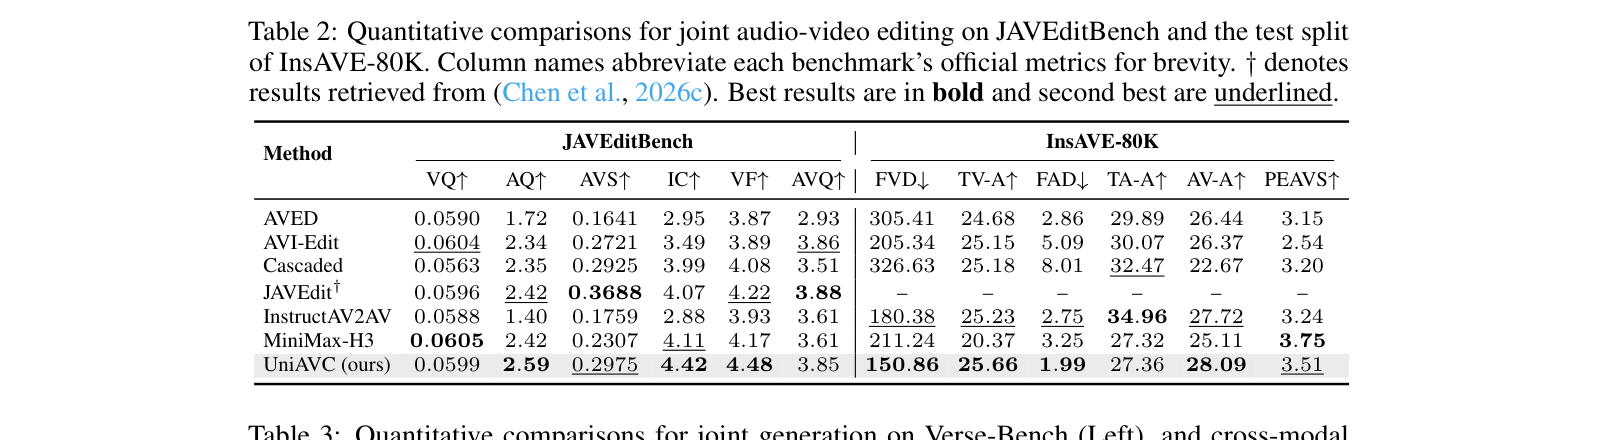
Table 2 — 주요 벤치마크 데이터셋에서 제안 모델의 우수한 정량적 성능을 입증하는 비교 테이블
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] APEX: Asynchronous Prefix Denoising for Extreme Compression
- [논문리뷰] Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
- [논문리뷰] TransNormal-2: Geometry-Grounded Rectified Flow with Edge-Aware Decoding for Precise Normal Estimation
- [논문리뷰] Motion-Omni: End-to-End Joint Speech and Full-Body Motion for Spoken Dialogue
- [논문리뷰] The Missing Temporal Link: Temporal Context Routing for Script-Driven Audio-Video Generation
Review 의 다른글
- 이전글 [논문리뷰] Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
- 현재글 : [논문리뷰] UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling
- 다음글 [논문리뷰] Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
댓글