[논문리뷰] Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
링크: 논문 PDF로 바로 열기
메타데이터
저자: Zekai Li, Jiayi Yu, Jinlu Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Physical RSI (Recursive Self-Improvement): 로봇이 물리적 상호작용 환경에서 자신의 정책, 도구, 코드 등을 반복적인 시행착오를 통해 스스로 업데이트하며 개선해 나가는 과정입니다.
- PhysRSI-eval: Physical RSI 능력을 정량화하기 위해 제안된 평가 프로토콜로, First-Attempt Performance, Efficiency, Success, Budget, Improvement의 5개 축으로 구성됩니다.
- Physical Barrel Hypothesis: 모델의 개선 능력이 단일한 역량이 아닌, 특정 역량(예: Spatial Reasoning, Perception 등)의 병목 현상에 의해 제한된다는 가설입니다.
- Observational Scaling Law: 모델의 공개된 벤치마크 점수와 초기 물리적 피드백을 통해 최종적인 성능 향상 정도나 개선 시점(Gain timing)을 예측하는 경험적 법칙입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 frontier LLM 에이전트가 로봇 조작 작업에서 어떻게 물리적 피드백을 통해 정책을 개선하는지, 그 근본적인 메커니즘과 일반화 가능성을 탐구합니다. 기존 연구들은 단순한 최종 성공률이나 에피소드 기반의 성과에 집중하여, 에이전트가 언제, 얼마나 효율적으로 개선을 이루는지에 대한 구체적인 분석이 부족했습니다. 특히 모델의 성능 향상이 단순히 반복적인 시도를 통한 과적합(Overfitting)인지, 아니면 전이 가능한 일반화된 기술의 획득인지에 대한 명확한 해답이 필요합니다 [Figure 1].
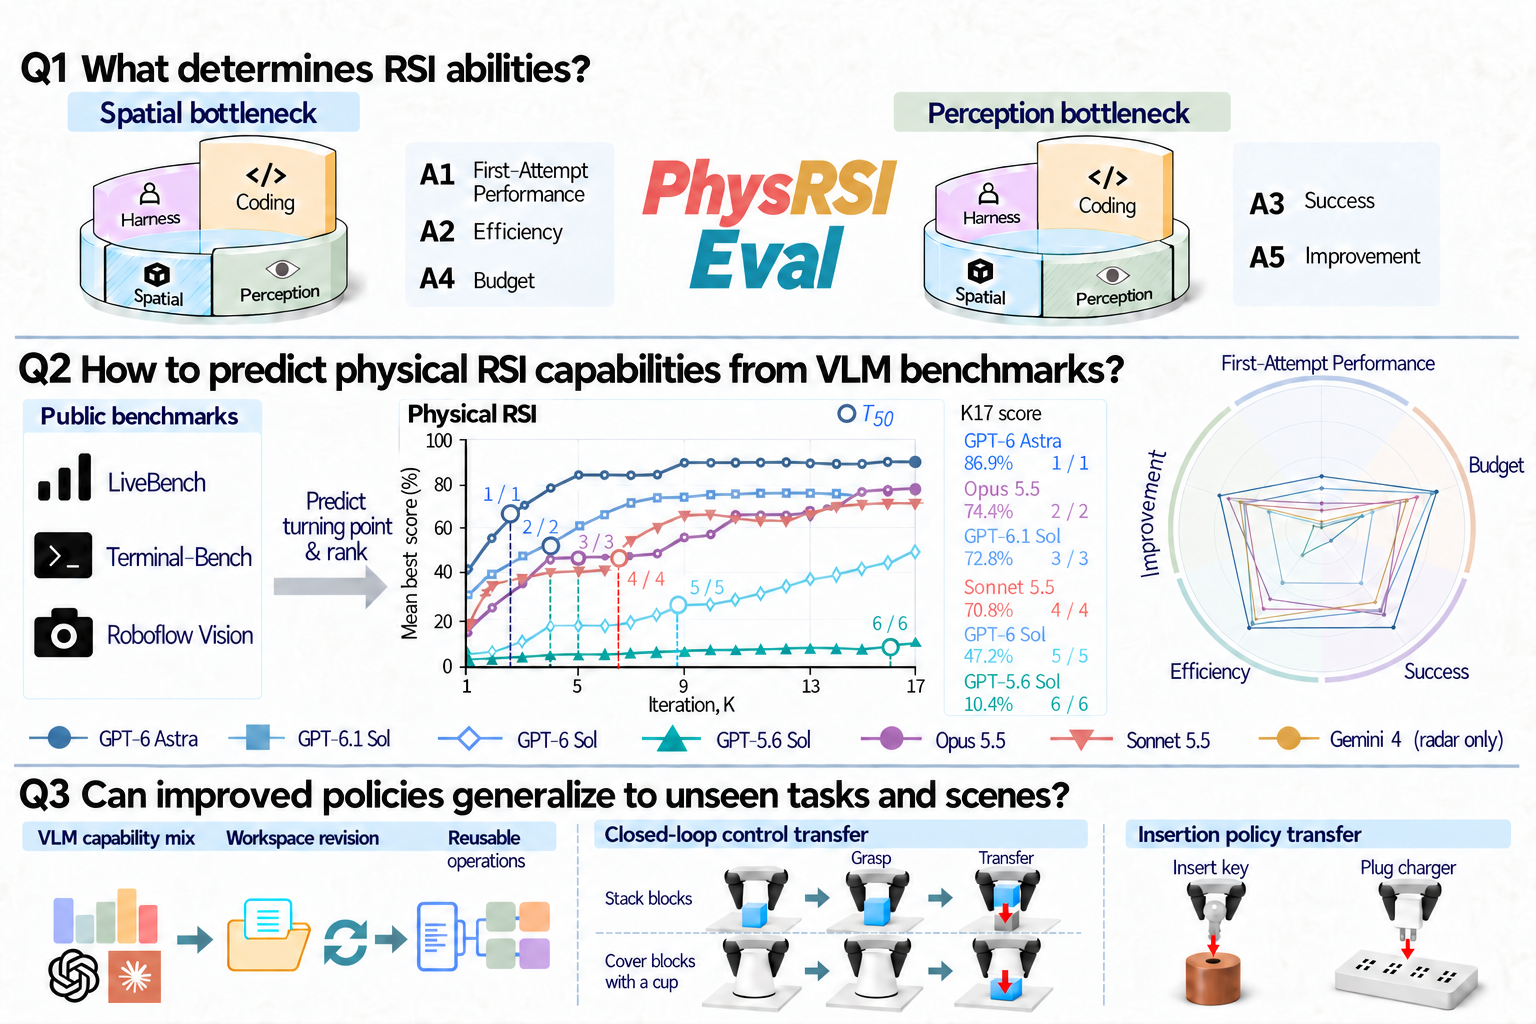
Figure 1 — PhysRSI-eval 개념 및 5축 지표
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 PhysRSI-eval을 도입하여 18개의 로보틱스 조작 작업을 대상으로 고정된 물리적 상호작용 예산(Fixed interaction budget) 하에서 모델을 평가했습니다. 모델의 개선 과정은 5개의 지표인 First-Attempt Performance (A1), Efficiency (A2), Success (A3), Budget (A4), Improvement (A5)로 다각도 분석되었습니다 [Figure 2]. 실험 결과, Spatial Reasoning 역량은 초기 성능(A1)과 밀접하게 연관된 반면, Perception 역량은 실패 후 복구 및 최종 성공률(A3, A5)과 강한 상관관계를 보였습니다. 이러한 발견은 특정 역량이 성능 향상의 병목이 된다는 Physical Barrel Hypothesis를 뒷받침합니다 [Figure 4]. 또한, 공개된 벤치마크 점수를 통해 에이전트의 성능 향상 시점인 T50 (Half-gain round)을 성공적으로 예측하였으며, 초기 물리적 피드백(K1–K5 라운드)을 활용하여 전체 개선 궤적을 예측하는 데 평균 절대 오차(MAE) 0.019 수준의 높은 정확도를 달성했습니다 [Figure 7, Figure 8].
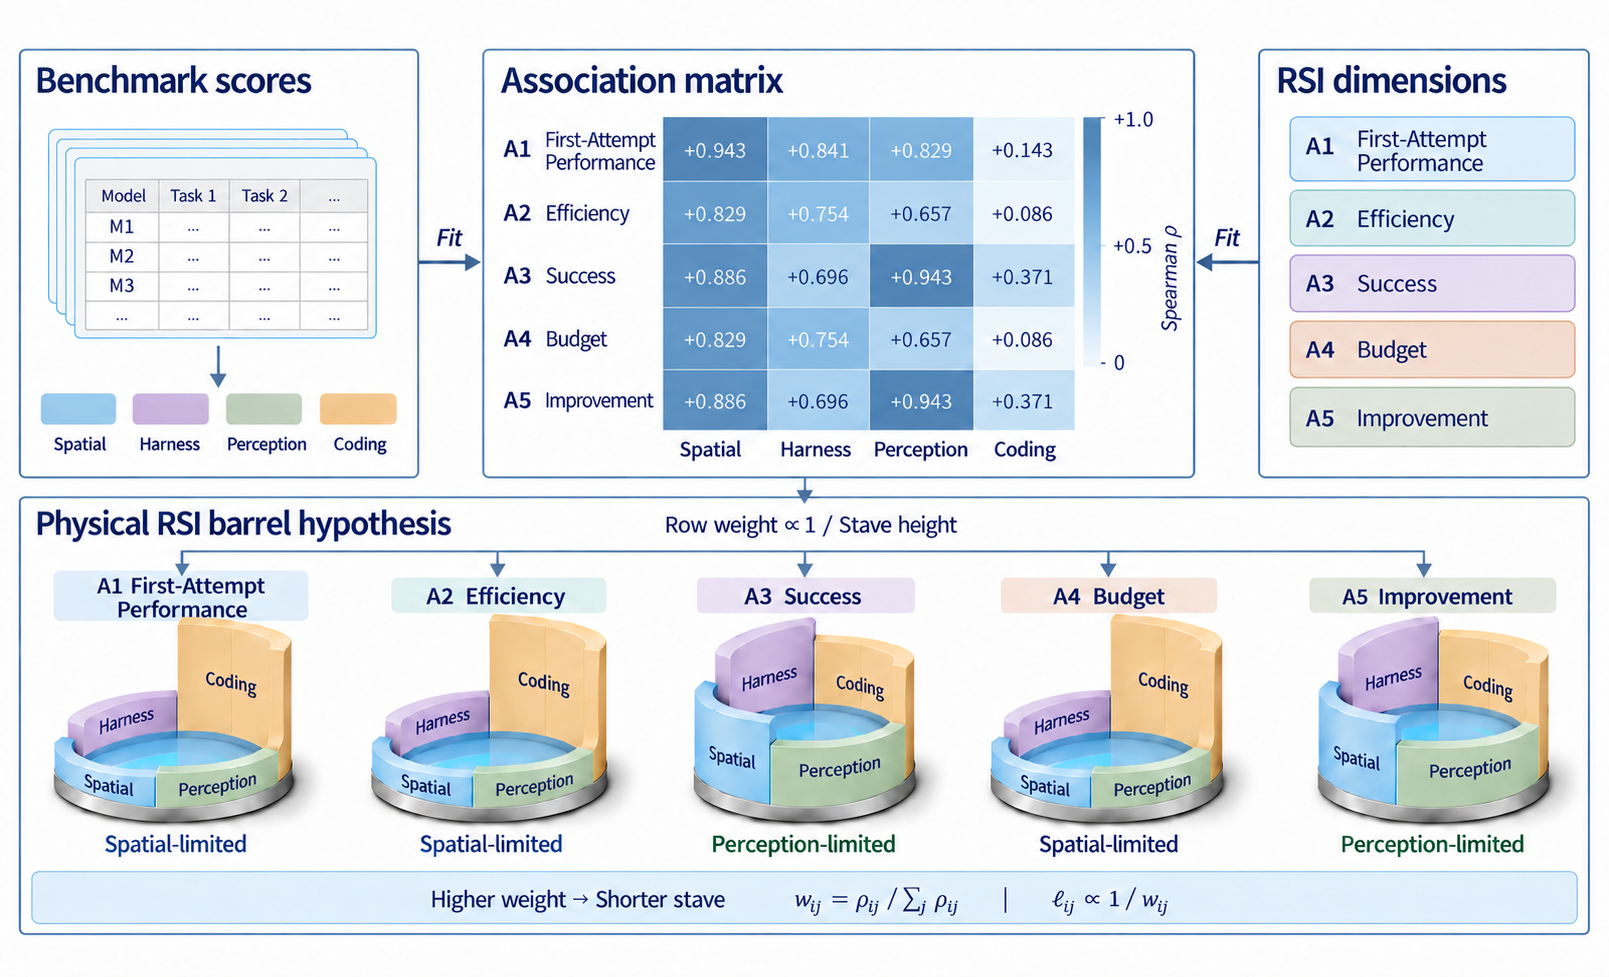
Figure 4 — 역량 상관관계와 Barrel Hypothesis
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Physical RSI가 모델의 고유한 역량 분포와 병목 현상에 의해 지배됨을 체계적으로 규명했습니다. 실험 결과, 에이전트의 개선 과정에서 축적된 경험(워크스페이스 내 코드 및 메모리)은 단순히 환경에 적응하는 것을 넘어 다른 작업으로 전이 가능한 유용한 자산임을 확인했습니다 [Figure 9]. 본 논문은 Embodied AI 분야에서 단순히 '모델이 잘한다'는 것을 넘어, '왜, 얼마나 효율적으로 개선되는가'를 이해하는 새로운 정량적 프레임워크를 제시하며 향후 에이전트 자기 개선 알고리즘 설계의 기초를 제공합니다.
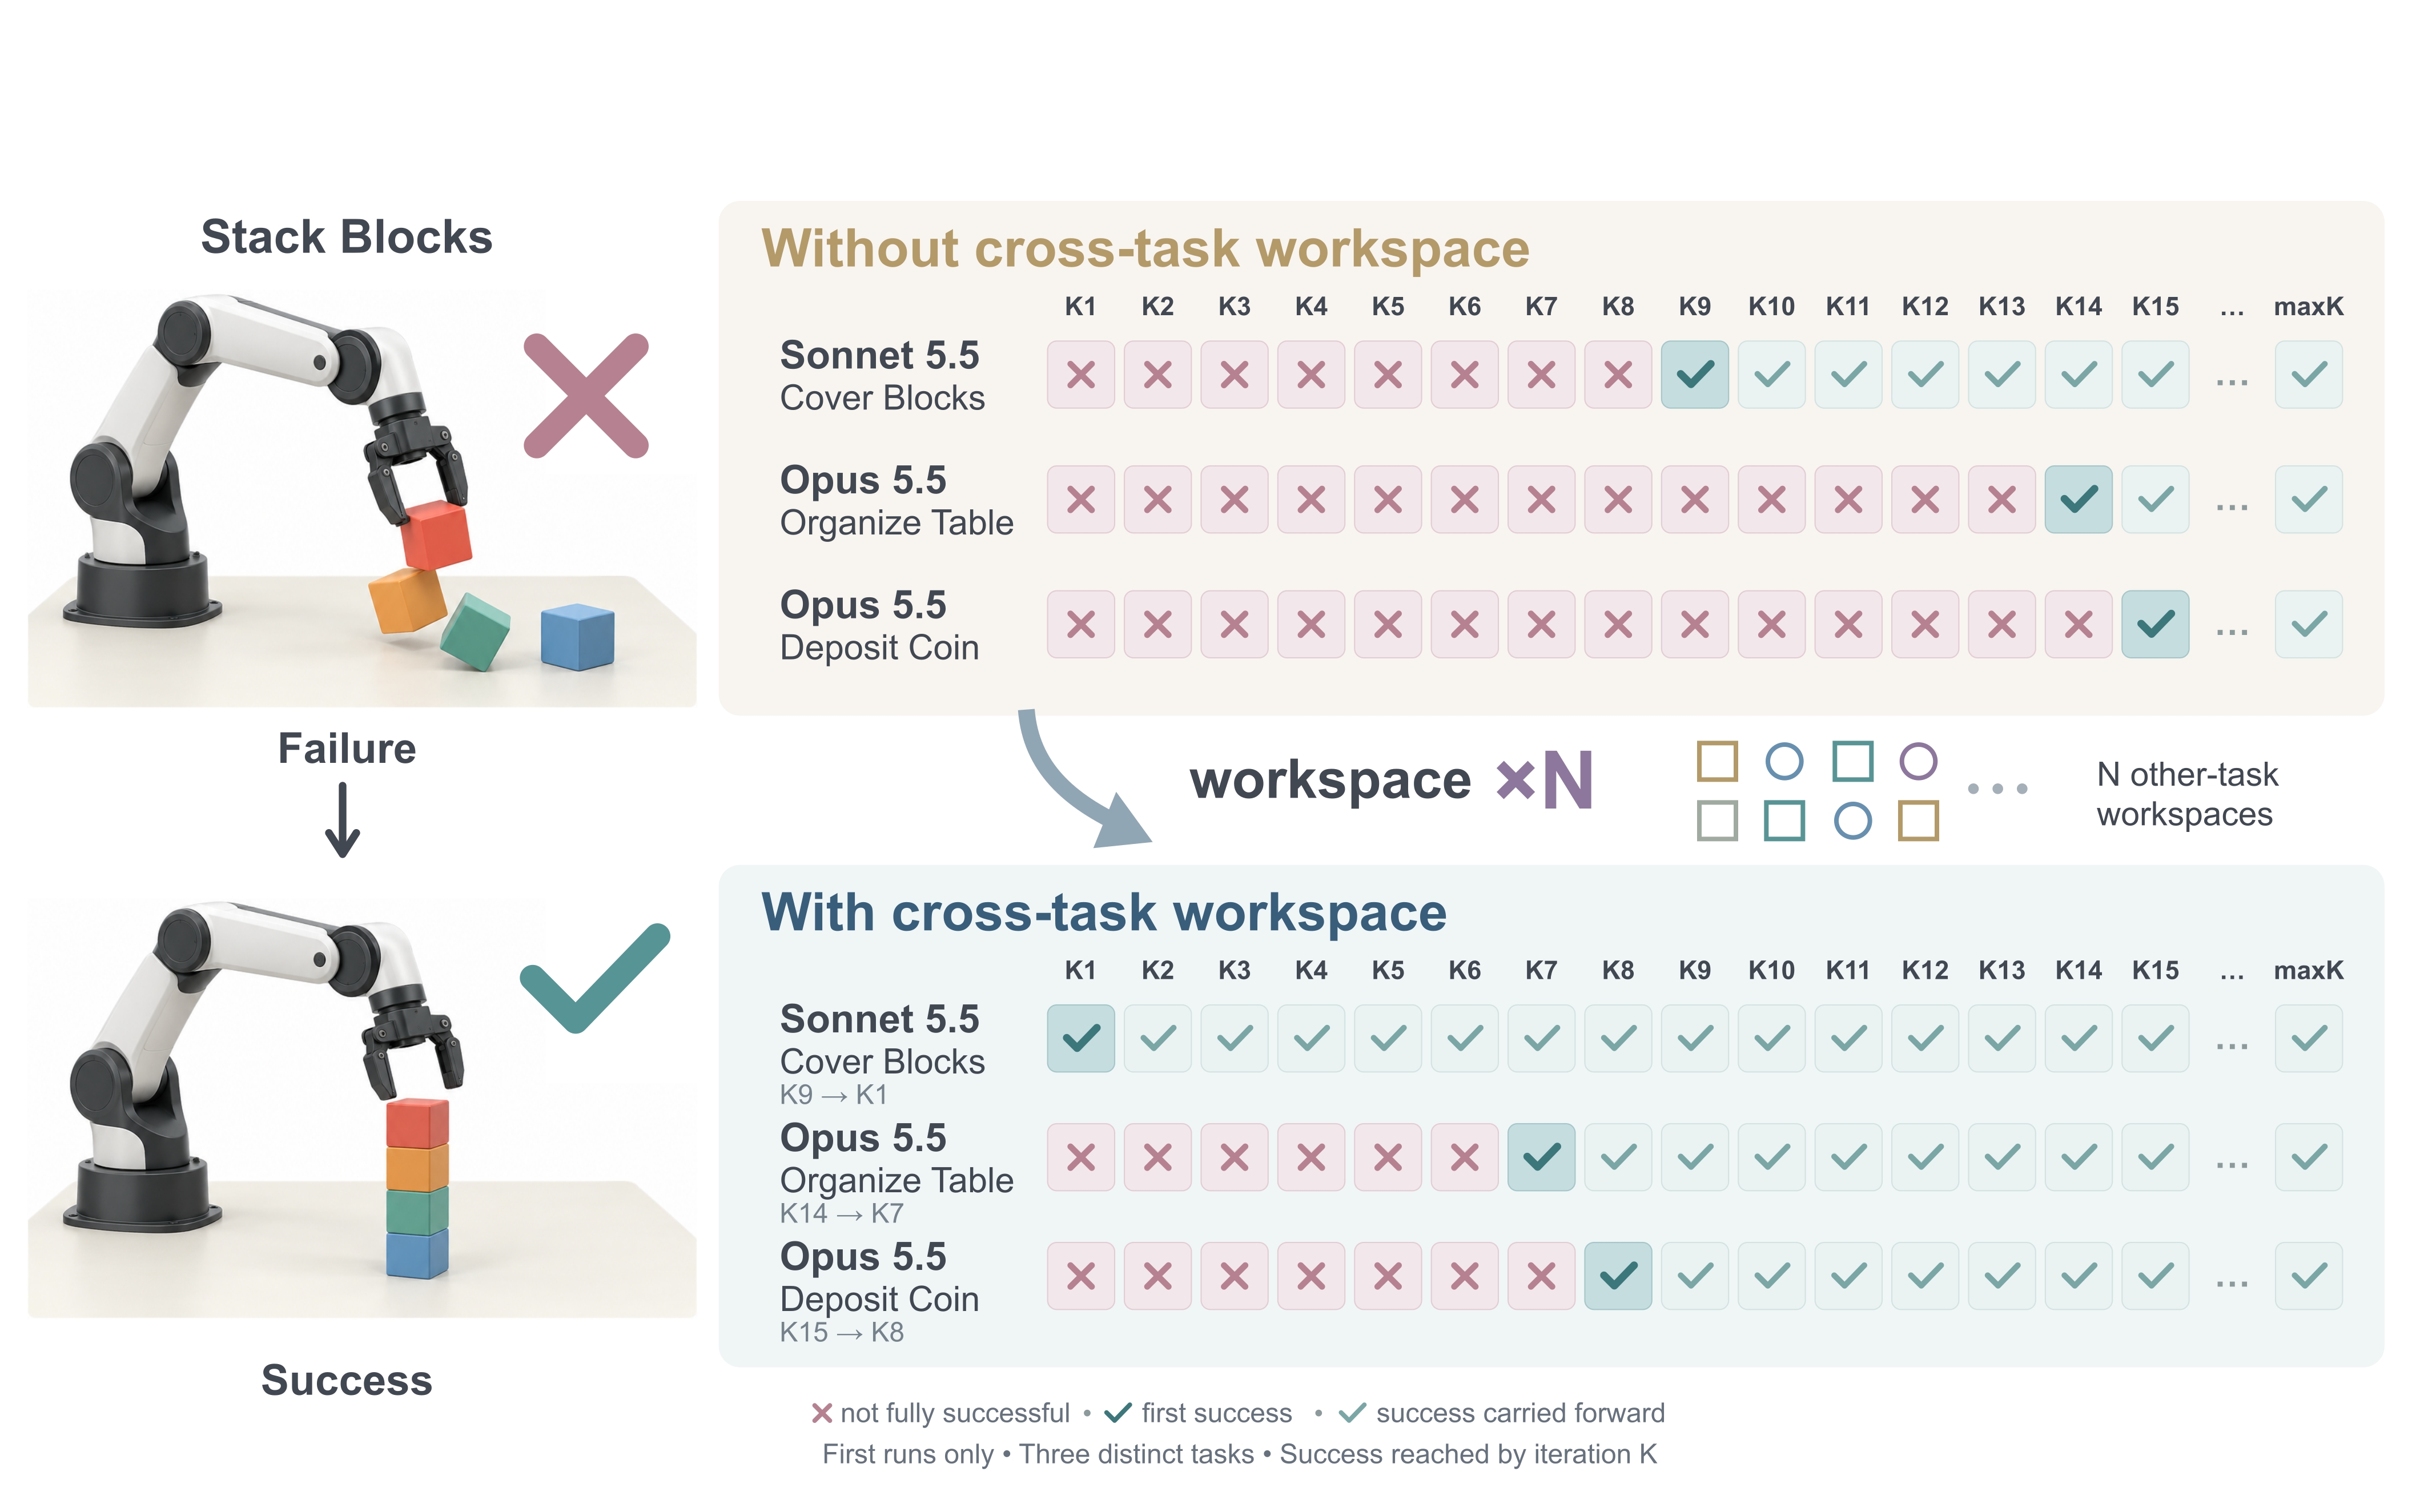
Figure 9 — 작업 간 워크스페이스 전이 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoboQuest: Generalist Physical Agents that Search, Inspect and Test
- [논문리뷰] Attention-DP3: Spatially Object-aware 3D Diffusion Policy via Geometry-aligned Attentional Conditioning
- [논문리뷰] RoboSPA: Can VLA Models Go Beyond Simple Scenes and Short-Horizon Tasks?
- [논문리뷰] DreamX-Phi 1.0: Action-Conditioned Video World Model for Robotic Manipulation
- [논문리뷰] RynnWorld-4D: 4D Embodied World Models for Robotic Manipulation
Review 의 다른글
- 이전글 [논문리뷰] UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling
- 현재글 : [논문리뷰] Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
- 다음글 [논문리뷰] World Model Interpretability: From Decoding Representations to Understanding Latent Worlds
댓글