[논문리뷰] Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
링크: 논문 PDF로 바로 열기
저자: Zhipeng Chen, Yunsen Liang, Yanxi Chen, Hongkang Zhao, Lingyun Feng, Ruiyang Ren, Guoxin Chen, Jia Deng, Feng Chang, Chuan Hao, Ran Tao, Jian Yang, Ji-Rong Wen, Bryan Dai, Wayne Xin Zhao
1. Key Terms & Definitions (핵심 용어 및 정의)
- Recursive Self-Improvement (RSI): 시스템이 자신의 경험을 통해 지속적으로 개선되는 능력으로, 과거 오류를 수정하고 이득을 누적하여 자율적으로 역량을 강화하는 메커니즘을 의미합니다.
- DEEPEVOLVE: 실시간 이벤트 예측 환경에서 RSI를 연구하기 위해 제안된 지속 가능한 에이전트 시스템 프레임워크로, PROMETHEUS, BRANCHUS, ATHENA 세 가지 모듈로 구성됩니다.
- PROMETHEUS: DEEPEVOLVE의 "Living Data Environment" 모듈로, 실제 뉴스 및 이벤트를 수집하여 예측 태스크를 생성하고, 이벤트가 해결되면 검증 가능한 Ground Truth 및 보상을 제공합니다.
- BRANCHUS: DEEPEVOLVE의 "Agentic Forecaster" 모듈로, 외부 도구를 사용하여 증거를 수집하고 이를 바탕으로 확률적 예측을 생성하며, 그 추론 궤적(Reasoning Trajectory)을 기록합니다.
- ATHENA: DEEPEVOLVE의 "Recursive-Evolution Engine" 모듈로, BRANCHUS의 예측 궤적을 활용하여 파라미터 업데이트, 재사용 가능한 스킬 증류, 환경 난이도 조절 등의 진화를 주도합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 AI 시스템이 특정 시점의 역량에 머무르지 않고, 자신의 경험을 통해 지속적으로 발전하는 Recursive Self-Improvement (RSI) 능력의 중요성을 강조합니다. 기존 AI 시스템들은 대부분 배포 시 파라미터가 고정되어 있거나, 외부의 수동적인 업데이트(예: 인간이 큐레이팅한 데이터, 오프라인 재훈련)를 통해서만 개선되는 한계를 가집니다. 이러한 정적인 모델은 불변하는 데이터셋에 훈련되어 예측 태스크를 해결하는 데 그치며, 다이내믹한 실제 환경에서 에이전트가 자율적으로 진화하는 근본적인 도전과제를 해결하지 못합니다. RSI를 연구하기 위해서는 끊임없이 변화하고, 객관적으로 검증 가능하며, 실제 환경에 기반을 둔 동적인 환경이 필수적이지만, 현재 고정된 데이터셋 중심의 평가 환경은 이러한 요구사항을 충족시키지 못합니다. [Figure 1]은 이러한 동적인 상호작용의 필요성을 시각적으로 보여줍니다.
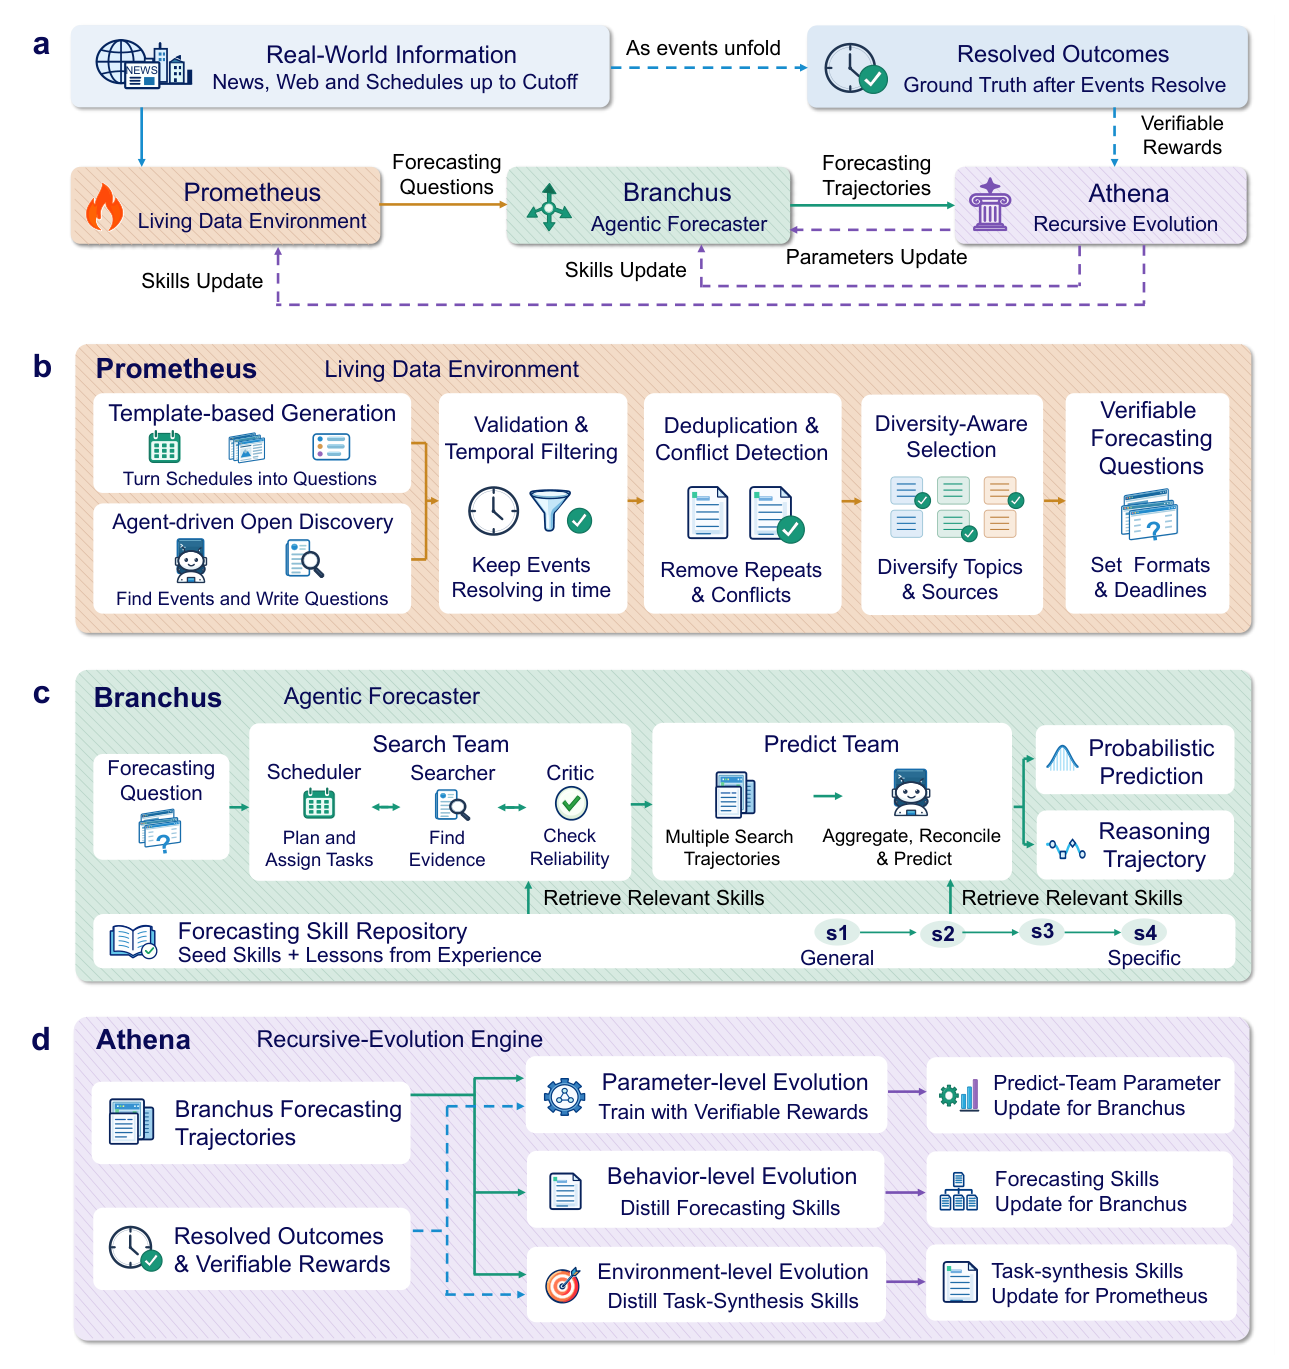
Figure 1 — DEEPEVOLVE 프레임워크의 전체 아키텍처와 세 가지 핵심 모듈 간의 폐쇄 루프 상호작용을 시각적으로 보여주는 핵심 다이어그램입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 실시간 이벤트 예측을 위한 지속 가능한 에이전트 시스템 DEEPEVOLVE를 제안합니다. 이 시스템은 PROMETHEUS, BRANCHUS, ATHENA 세 가지 모듈이 상호작용하는 폐쇄 루프 형태로 설계되어 에이전트와 환경이 함께 진화합니다. PROMETHEUS는 변화하는 실제 뉴스에서 예측 질문을 생성하고 Ground Truth를 제공하며, BRANCHUS는 이 질문에 대해 외부 도구를 사용해 증거를 수집하고 예측을 수행하며, 그 과정의 궤적을 기록합니다. ATHENA는 이 궤적을 바탕으로 BRANCHUS의 파라미터를 Reinforcement Learning (RLVR)을 통해 업데이트하고, 성공적인 궤적에서 재사용 가능한 Forecasting Skills를 추출하며, 에이전트의 실패 모드를 분석하여 PROMETHEUS가 더 어려운 질문을 생성하도록 환경을 진화시킵니다.
DEEPEVOLVE는 강력하고 일반화 가능한 예측 성능을 달성했습니다. 외부 벤치마크인 FutureX [Figure 2]에서, BRANCHUS는 3주 연속으로 모든 시스템 중 1위를 차지하며 최대 195%의 레이팅 개선을 보였습니다. 자체 합성 평가에서 BRANCHUS는 QWEN3.8-MAX 모델과 함께 Bradley-Terry (BT) 점수 62.2를 기록하여, 가장 강력한 Baseline 대비 10.7 BT 포인트 이상 우수한 성능을 보였습니다 [Table 1]. 파라미터 진화(RLVR)는 Choice Accuracy를 1.3 포인트 상승시키고, Numeric Score (1-bWIS)를 0.31~0.38 개선했습니다. Skill Evolution은 Brier Score를 0.135에서 0.122로 0.013 낮추고, MAPE를 2.80%에서 2.28%로 0.52 포인트 낮추는 등 예측 품질을 지속적으로 향상시켰습니다. 환경 진화는 에이전트의 약점을 직접적으로 타겟팅하여, 합성된 질문의 난이도를 높였음에도 불구하고 AUROC는 0.678에서 0.68로 유지되어 질문의 객관성과 해상 가능성을 보존하며 진정한 난이도 상승을 증명했습니다.
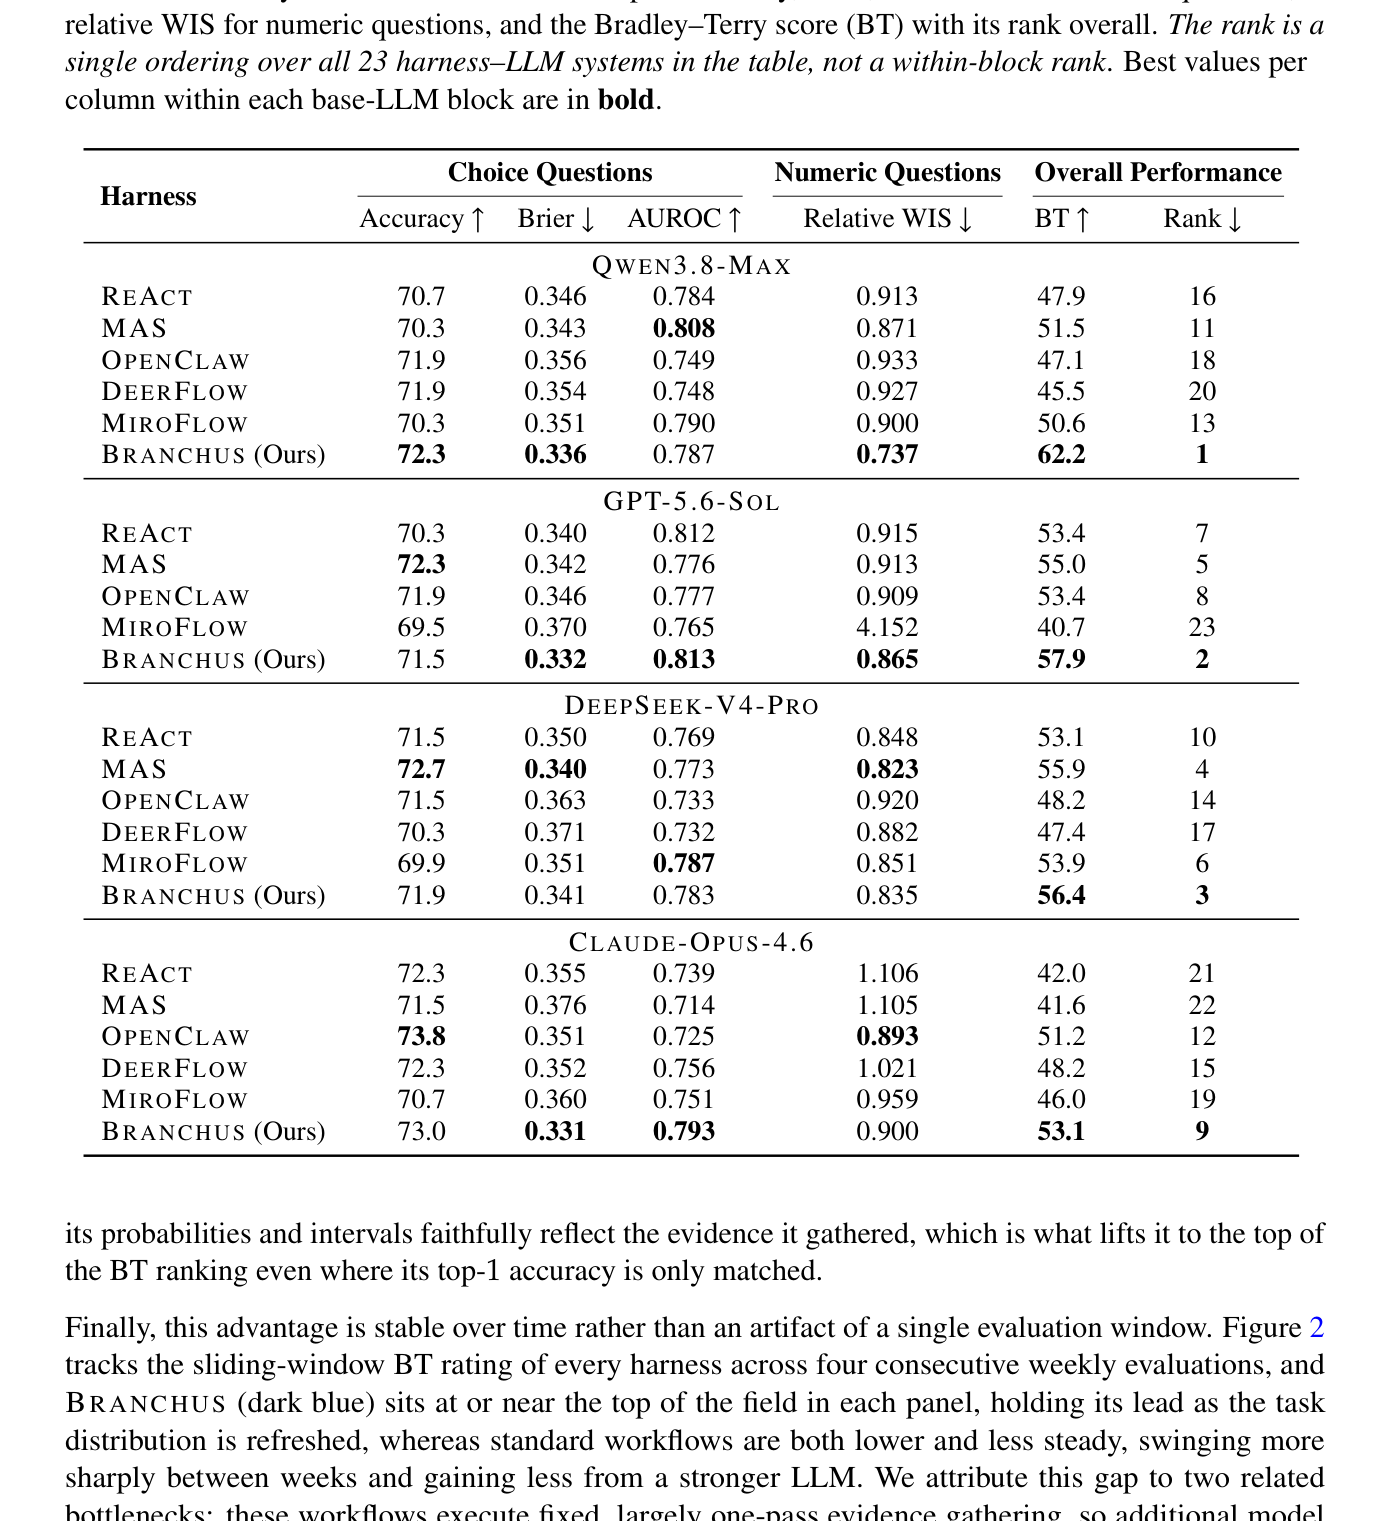
Table 1 — 다양한 LLM 기반의 Baseline 시스템과 비교하여 BRANCHUS의 예측 성능을 Choice Questions, Numeric Questions, Overall Performance 지표로 정량적으로 보여주는 핵심 결과 테이블입니다.
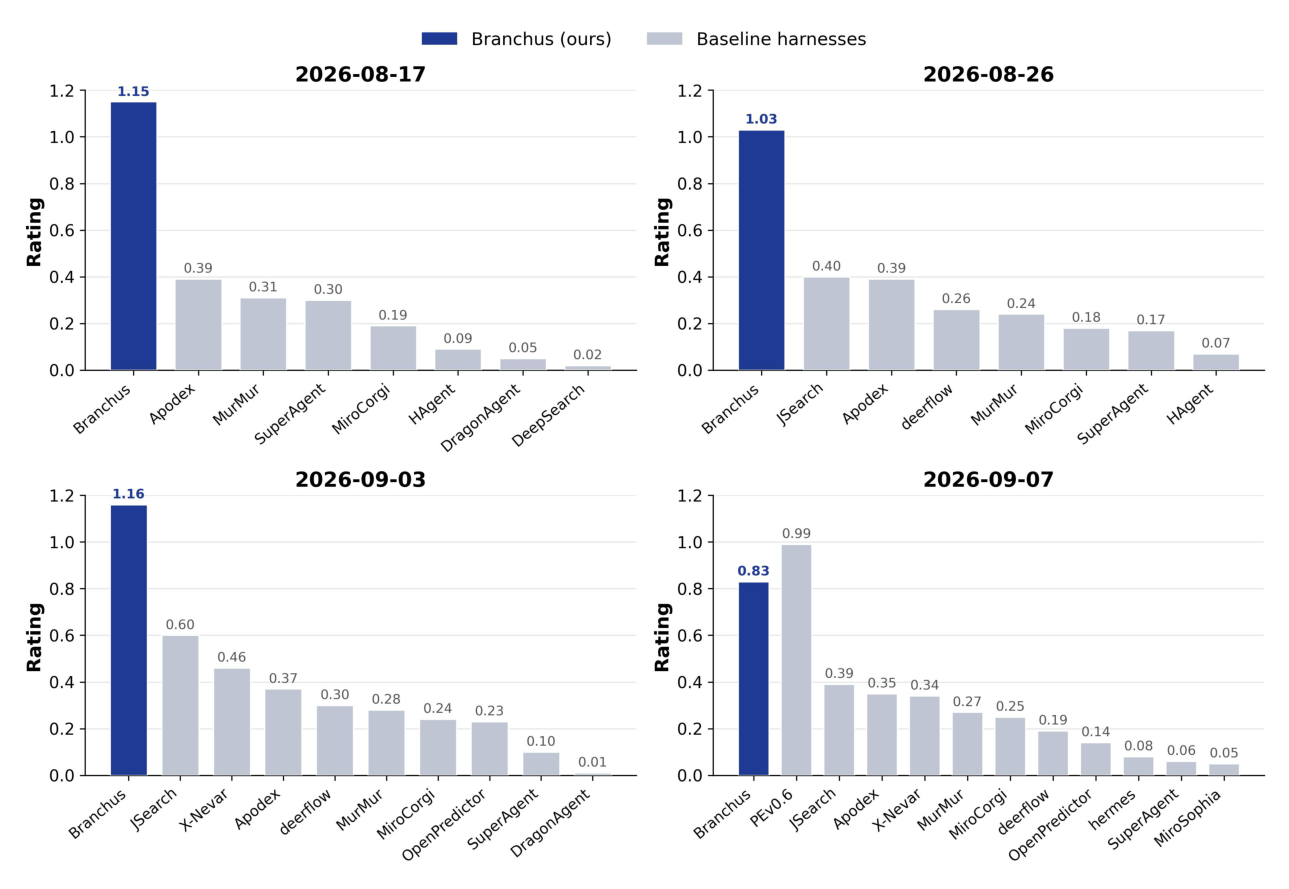
Figure 2 — 4주간의 FutureX 벤치마크 평가에서 BRANCHUS가 Baseline 시스템들에 비해 지속적으로 높은 순위를 유지하며 성능 우위를 보여주는 그래프입니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 DEEPEVOLVE라는 프레임워크를 통해 실제 세계 이벤트 예측 환경에서 Recursive Self-Improvement (RSI)가 실현될 수 있음을 구체적으로 보여주었습니다. 정적인 모델 훈련 방식에서 벗어나, 에이전트가 살아있는 환경과 공동 진화(co-evolution)하며 자신의 경험을 통해 지속적으로 강해지는 새로운 AI 패러다임을 제시했습니다. 파라미터 업데이트, 스킬 증류, 그리고 적응형 환경 진화라는 세 가지 축이 유기적으로 결합하여, 시스템의 역량이 단순한 일회성 개선이 아니라 라운드별로 누적 성장하는 것을 입증했습니다. 이는 AI 개발의 초점이 고정된 데이터셋 기반의 정적 모델 훈련에서, 성장하는 에이전트를 육성하는 방향으로 전환될 수 있음을 시사하며, AI의 진정한 지능은 특정 시점의 역량보다는 스스로 성장하는 능력에 있음을 강조합니다. 이 연구는 자율 에이전트와 발견 도구로서 AI의 잠재력을 실현하기 위한 필수적인 단계를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
- [논문리뷰] Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
- [논문리뷰] Grounded Skill Synthesis from Code at Scale for Agentic Intelligence
- [논문리뷰] SPADE: Self-Play in Adaptive Synthetic Executable Environments
- [논문리뷰] MBA: Multimodal Benchmark and Agents for Real-World Business Ideation
Review 의 다른글
- 이전글 [논문리뷰] Entertain, then Cancel: How Thinking Makes Reasoning Models Read Some and Or Literally
- 현재글 : [논문리뷰] Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
- 다음글 [논문리뷰] From RL Papers to Framework Code: Inclusion and Review in Seven Open-Source Training Frameworks
댓글