[논문리뷰] Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
링크: 논문 PDF로 바로 열기
메타데이터
저자: NVIDIA, Sérgio Agostinho, Maximilian Apodaca, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Foundation4D: 멀티 카메라 비디오 입력을 통해 Geometry estimation, 3D detection, Semantic occupancy, Gaussian reconstruction을 동시에 수행하는 통합 Feed-forward 모델입니다.
- Factorized Spatiotemporal Attention: 카메라 뷰 간의 정보와 시간적 흐름(Temporal context)을 효율적으로 결합하기 위해 사용되는 핵심 아키텍처 모듈입니다 [Figure 2].
- PAI–Foundation4D: 1,253개의 드라이빙 클립으로 구성된, Geometry, Detection, Occupancy 평가를 위한 통합 벤치마크 데이터셋입니다.
- 3D Gaussian Splatting (3DGS): 장면을 명시적인 Anisotropic primitives로 표현하여 Novel-view rendering을 가능하게 하는 기술입니다.
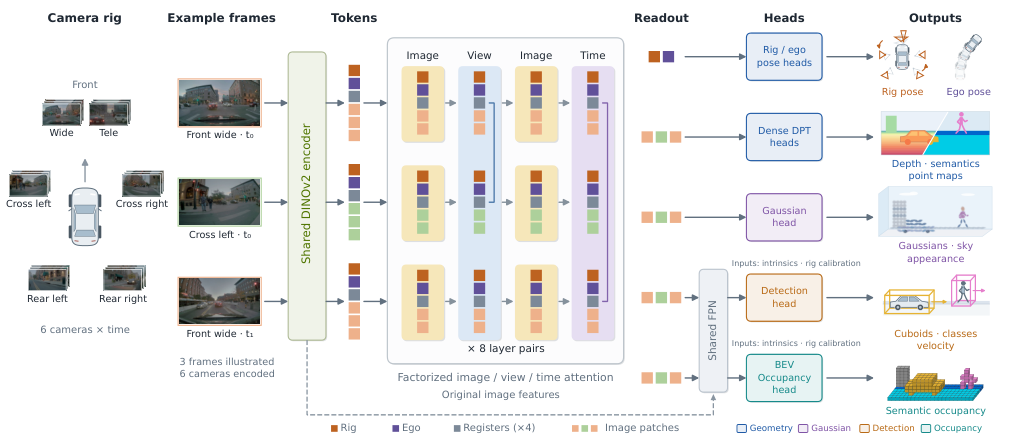
Figure 2 — Foundation4D 전체 아키텍처
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 자율주행 시스템에서 환경 이해와 시뮬레이션을 위한 장면 재구성을 단일 모델로 통합하여 해결하고자 합니다. 기존 연구들은 각 작업을 개별 네트워크로 처리하여 동일한 입력에 대해 중복된 연산이 발생하거나, 모델 간의 파이프라인 통합이 어렵다는 한계가 있었습니다. 특히, 고품질 재구성을 위해서는 Geometry, 객체 탐지, Occupancy, 장면 외형 정보를 모두 확보해야 하는데, 이를 효율적으로 처리할 통합 모델이 부족한 실정입니다. 따라서 저자들은 공유된 Spatiotemporal 표현을 활용하여 이러한 복합적인 작업을 단일 패스로 처리하는 효율적인 프레임워크를 제안합니다 [Figure 2].
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 공유 백본(Shared backbone)에서 추출된 특징을 기반으로 Geometry, 3D 객체, Semantic occupancy, Gaussian 속성을 추론하는 Feed-forward 구조를 제안합니다 [Figure 2]. 모델은 Factorized spatiotemporal attention을 사용하여 연산 효율성을 극대화하며, 비디오 단위의 추론을 위해 Pose graph optimization 기반의 카메라 궤적 정제와 객체 트래킹 파이프라인을 도입했습니다.
주요 실험 결과, Foundation4D는 Waymo 및 nuScenes 벤치마크에서 SOTA 수준의 Depth AbsRel 성능을 달성하였으며, nuScenes의 3D 객체 탐지 mAP와 OpenOccupancy의 mIoU에서도 비교 모델 대비 우수한 성능을 보였습니다. 특히, 다중 작업 동시 학습(Co-training)의 이점이 명확하게 나타났습니다:
- 탐지와 Geometry를 공동 학습할 경우, 탐지 전용 모델 대비 top-class mAP가 1.2점 상승하였습니다.
- Geometry와 탐지를 함께 학습할 경우, Geometry 전용 학습 대비 Camera-to-rig translation error가 13.4% 감소하는 정량적 개선을 보였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 자율주행의 핵심 인식 작업들과 장면 재구성 기술을 단일 Feed-forward 모델로 성공적으로 통합하였습니다. 이 연구가 제안하는 파이프라인과 PAI–Foundation4D 벤치마크는 학계와 산업계에 표준화된 평가 도구를 제공하며, 다중 작업 학습(Multi-task learning)이 자율주행 모델의 성능 향상에 미치는 시너지 효과를 입증했습니다. 궁극적으로 본 모델은 실시간 환경 이해뿐만 아니라, Lidarless 시뮬레이션 환경 구축에 필수적인 Geometry 및 궤적 Priors를 제공함으로써 차세대 자율주행 인식 시스템 개발에 중요한 기술적 이정표를 제시합니다.
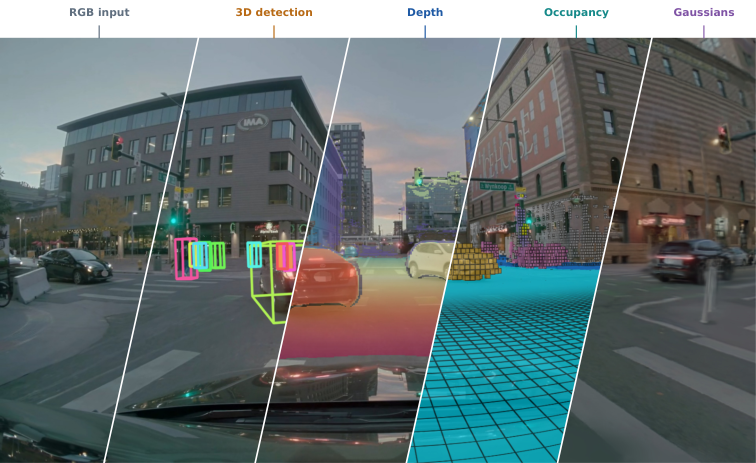
Figure 1 — 모델의 입출력 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SplatLab: Autonomous Scientific Discovery for 3DGS Research
- [논문리뷰] RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
- [논문리뷰] CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
- [논문리뷰] FineSplat: Fine Patches, Local Groups, Detailed Splats
- [논문리뷰] InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
Review 의 다른글
- 이전글 [논문리뷰] FilmFlow: Agentic System for 3D Virtual Film Cinematography
- 현재글 : [논문리뷰] Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
- 다음글 [논문리뷰] Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
댓글