[논문리뷰] AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
링크: 논문 PDF로 바로 열기
저자: Yuesheng Huang, Hoi Fan Au, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- AV-FABLE: 오픈 씬(open-scene)의 롱폼 오디오-비주얼(long-form audio-visual) 비디오에서 희소한 조작(sparse manipulations)을 위한 듀얼-타임라인(dual-timeline) 벤치마크. 독립적인 오디오 및 비주얼 타임라인을 제공하여 모달리티-특정(modality-specific) 시간적 지역화(temporal localization)를 가능하게 한다.
- NFSR (Native Forensics via Separated Readouts): AV-LLM(audio-visual large language models)의 Frozen Perception Features를 활용하여 모달리티-특정 시간적 지역화(modality-specific temporal localization)를 수행하는 제안된 방법론. 호스트-컨디셔닝(host-conditioning)과 분리된 시간적 디코더(separated temporal decoders)를 특징으로 한다.
- Native-track evaluation: AV-FABLE의 주요 지역화 프로토콜로, 예측이 동일한 모달리티의 ground-truth 이벤트와 일치해야 한다. 오디오 예측은 비주얼 이벤트와 매칭될 수 없다. AV-mAP(mean Average Precision for Audio-Visual)를 통해 성능을 측정한다.
- Joint-timeline evaluation: 오디오 및 비주얼 ground-truth 이벤트를 병합하고, 예측이 모달리티 레이블과 무관하게 일치하는 경우를 평가하는 보조 프로토콜이다.
- Frozen Perception Features: 사전 훈련된 AV-LLM의 인코더에서 추출된 고정된 피처(features)로, 조작 증거를 강력하게 인코딩하고 있지만, zero-shot 언어 출력으로는 효과적으로 드러나지 않는 것으로 나타났다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 롱폼 비디오(long-form videos) 내에서 발생하는 로컬라이즈된 AI 조작(localized AI manipulations)의 포렌식 분석에 있어 기존 방법론의 한계를 명확히 제시한다. 기존의 오디오-비주얼 딥페이크 벤치마크(audio-visual deepfake benchmarks)는 주로 짧은 토킹-헤드(talking-head) 클립에 초점을 맞추고 있으며, 롱폼(long-form) 시간적 포렌식(temporal forensics)은 주로 비주얼 영역에 국한되어 있었다. 이러한 기존 벤치마크들은 오디오와 비주얼 조작이 독립적으로 발생하거나, 비동기적이거나, 또는 한 가지 모달리티에만 영향을 미칠 수 있는 시나리오를 제대로 다루지 못했다. 결과적으로 비디오-레벨(video-level) 분류만으로는 조작이 어디에서 발생했는지 또는 어떤 모달리티가 영향을 받았는지에 대한 충분한 정보를 제공하지 못하는 문제가 있었다. 저자들은 이러한 한계를 극복하기 위해, 오픈-씬(open-scene) 롱폼 오디오-비주얼 비디오에서 발생하는 희소한 조작(sparse manipulations)을 독립적인 오디오 및 비주얼 타임라인에서 정확히 지역화할 수 있는 새로운 접근 방식과 벤치마크의 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 롱폼 오디오-비주얼 비디오의 희소한 조작 포렌식을 위한 AV-FABLE이라는 듀얼-타임라인 벤치마크를 제안한다. 이 벤치마크는 16,650개의 pristine–manipulated twin pairs (998시간)와 27가지 편집 구성(editing configurations)을 포함하며, SEE-Forge 파이프라인(pipeline)을 통해 이벤트-중심(event-driven)으로 구축되었다 [Figure 1]. AV-FABLE의 특징은 독립적인 오디오 및 비주얼 타임라인 어노테이션(annotations)으로, 이는 기존의 joint-timeline 평가에서 간과될 수 있는 오류들을 드러낸다.
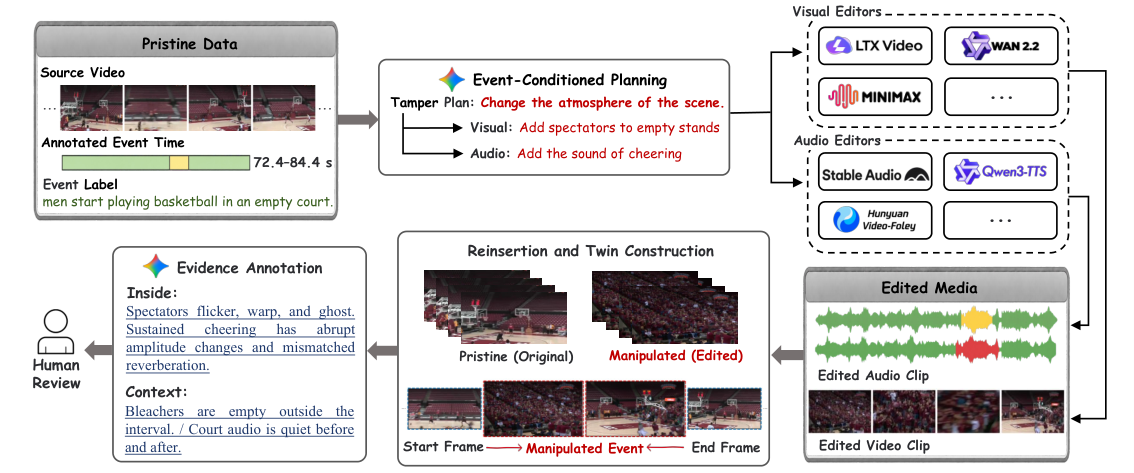
Figure 1 — AV-FABLE 구축 파이프라인
연구 결과, Qwen2.5-Omni 및 Qwen3-Omni와 같은 AV-LLM(audio-visual large language models)의 zero-shot 프롬프팅(prompting)은 AV-FABLE에서 51–52 detection AUROC 및 최대 0.30 mAP의 낮은 성능을 보였다. 그러나 동일한 AV-LLM의 frozen perception features에 대한 supervised readouts는 90.8 (audio) AUROC 및 80.8 (visual) AUROC를 달성하며 강력한 포렌식 신호(forensic signals)를 복구할 수 있음을 입증했다. 이러한 관찰을 바탕으로 저자들은 NFSR (Native Forensics via Separated Readouts)이라는 새로운 방법론을 제안한다 [Figure 2]. NFSR은 frozen AV-LLM 피처(features)를 사용하여 host-conditioned feature modulation과 독립적인 모달리티-분리(modality-separated) 시간적 디코더(temporal decoders)를 통해 오디오 및 비주얼 조작을 지역화한다.
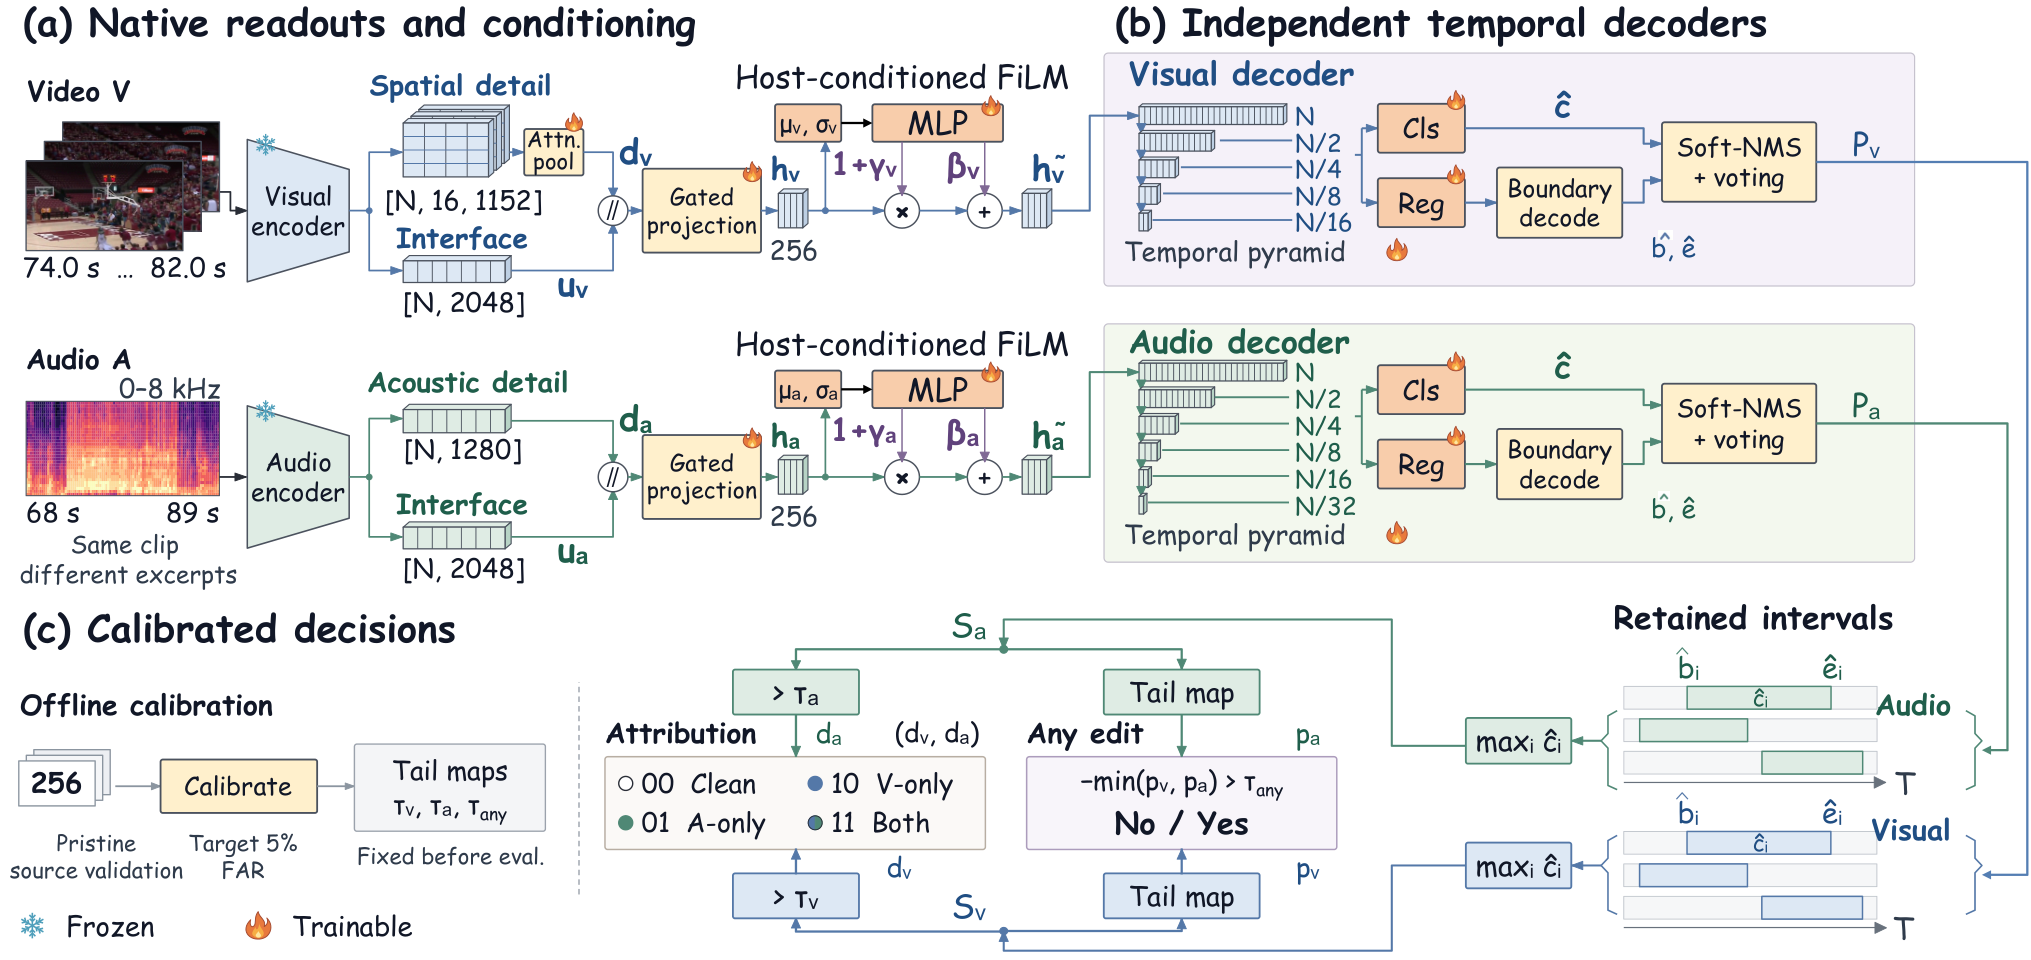
Figure 2 — NFSR 모델 개요
실험 결과, NFSR은 in-domain 평가에서 91.30 AV-mAP 및 96.04 detection AUROC를 달성하여, 동일한 frozen features를 사용하는 UMMAFormer의 84.76 AV-mAP 대비 우수한 성능을 보였다. 특히, NFSR은 source transfer, held-out generators, held-out TI2V를 포함한 세 가지 OOD (out-of-distribution) 설정 전반에서 가장 높은 AV-mAP를 기록하며 탁월한 일반화 능력(generalization capability)을 입증했다. 이는 NFSR이 내부 표현에 인코딩된 조작 증거를 효과적으로 활용하여 모달리티-특정 시간적 지역화의 성능을 크게 향상시켰음을 시사한다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 오픈 씬 롱폼 비디오에서 발생하는 희소한 오디오 및 비주얼 조작을 지역화하기 위한 AV-FABLE 듀얼-타임라인 벤치마크를 성공적으로 도입했다. AV-FABLE은 시간적 경계(temporal boundaries)와 모달리티 정체성(modality identity)을 모두 보존함으로써, 기존의 joint-timeline 평가로는 발견하기 어려웠던 오류들을 효과적으로 드러낼 수 있음을 보여주었다. 연구 결과는 현재 AV-LLM이 zero-shot 프롬프팅(prompting) 시 조작 탐지에서 낮은 성능을 보이지만, 그들의 frozen perception features는 강력한 포렌식 신호(forensic signals)를 인코딩하고 있다는 중요한 간극(gap)을 밝혀냈다. 이 통찰력을 바탕으로 제안된 NFSR 방법론은 in-domain 및 모든 OOD(out-of-distribution) 설정에서 가장 높은 AV-mAP를 달성하며, 롱폼 오디오-비주얼 포렌식 분야에서 모달리티-분리 시간적 리드아웃(modality-separated temporal readouts)의 효과성을 확고히 했다. 이 연구는 딥페이크 탐지 및 포렌식 분석의 정밀도를 향상시키는 데 크게 기여하며, 특히 실제 환경에서의 복잡하고 미묘한 조작을 식별하는 데 중요한 발판을 마련할 것으로 기대된다.
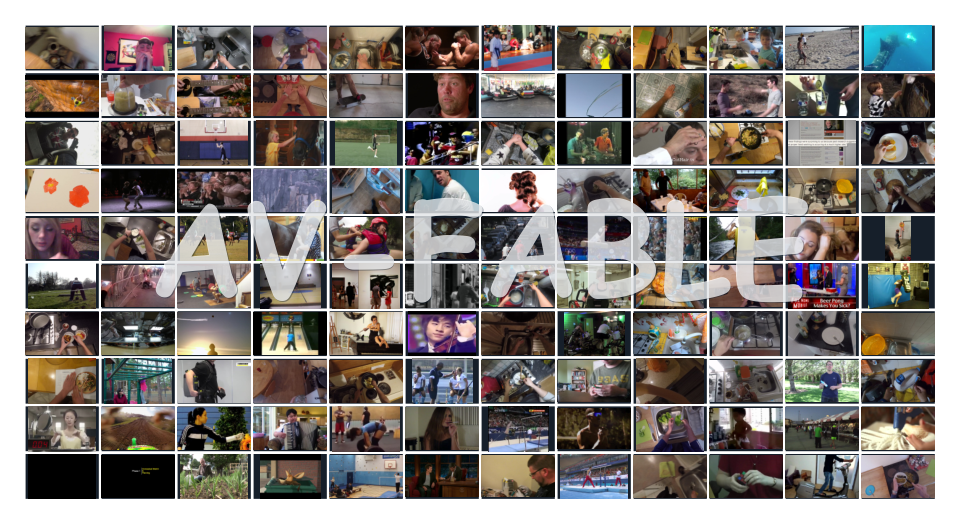
Figure 3 — AV-FABLE 장면 다양성
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
- [논문리뷰] TextReg: Mitigating Prompt Distributional Overfitting via Regularized Text-Space Optimization
- [논문리뷰] Certification of Real Images through Calibrated Content Authentication
- [논문리뷰] World Action Modeling with Progressive Visual Planning
- [논문리뷰] DF26: We Cannot Tell Fake From Real Anymore
Review 의 다른글
- 이전글 [논문리뷰] UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
- 현재글 : [논문리뷰] AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
- 다음글 [논문리뷰] AgentProofBench: Benchmarking Reusable Verifiers for Web Agents
댓글