[논문리뷰] RoboColosseum: Evaluating Physical Intelligence at Scale In-The-Wild
링크: 논문 PDF로 바로 열기
저자: Tan Sang Nguyen, Yi Ru Wang, Shailesh Shailesh, et al.
1. Key Terms & Definitions
- ROBOCOLOSSEUM: 일반 목적 로봇 정책의 실제 환경(in-the-wild) 평가를 위한 분산형 프레임워크로, 통합된 정책 serving과 표준화된 프로토콜을 통해 다양한 환경의 로컬 운영 로봇 네트워크를 연결합니다.
- Fine-tune Track: ROBOCOLOSSEUM 내의 평가 트랙으로, task-specific demonstration(task당 100개) 고정 예산 내에서 사전 학습된 정책이 새로운 task에 얼마나 효율적으로 적응하는지 측정합니다.
- Open Track: ROBOCOLOSSEUM 내의 평가 트랙으로, task-specific adaptation 없이 다양한 실세계 task 및 환경에서 정책의 zero-shot generalization 능력을 평가합니다. 정책들은 blind 처리된 pairwise trial을 통해 비교됩니다.
- Vision-Language-Action (VLA) policies: 시각 및 언어 이해를 기반으로 로봇 동작을 생성하는 정책으로, general-purpose robot learning의 주요 접근 방식 중 하나입니다.
- Difficulty-Calibrated Rasch (DCR) model: Open Track에서 사용되는 통계 모델로, 물리적 성공 결과로부터 정책의 능력(ability)과 task의 난이도(difficulty)를 jointly하게 추정하여 Elo-style 랭킹을 산출합니다.
2. Motivation & Problem Statement
일반 목적 로봇 정책(general-purpose robot policies)은 다양한 로봇, task, 환경에서 작동해야 하지만, 실세계(real-world) trial의 변화성은 재현성을 어렵게 하고 신뢰할 수 있는 평가를 방해합니다. 기존의 시뮬레이션 기반 평가와 달리, 물리적 세계에서의 로봇 평가는 센싱, 캘리브레이션, 동역학, 시각적 외형의 차이로 인해 시뮬레이션 성능이 실세계 결과와 잘 일치하지 않는 한계가 있습니다. 대규모 언어 모델(LLM) 및 비전 모델 분야에서는 인간 선호도를 반영한 대규모 벤치마크가 발전을 주도했지만, 물리적 세계와 상호작용하는 로봇 정책에 대한 신뢰성 있는 대규모 평가는 여전히 근본적인 도전 과제입니다. 특히, 로봇 평가의 결과는 정책, 로봇 설정, 초기 조건, 주변 환경에 따라 복합적으로 달라지므로, 의미 있는 비교를 위한 충분한 통제와 견고성 평가를 위한 충분한 환경 다양성을 동시에 충족시키기 어렵습니다. 본 연구는 이러한 문제점을 해결하기 위해 분산형 실세계 로봇 평가 프레임워크인 ROBOCOLOSSEUM을 제안하며 [Figure 1], 로봇 정책의 capabilities와 limitations를 체계적으로 평가할 수 있는 scalable하고 sustainable한 solution을 제공하고자 합니다.
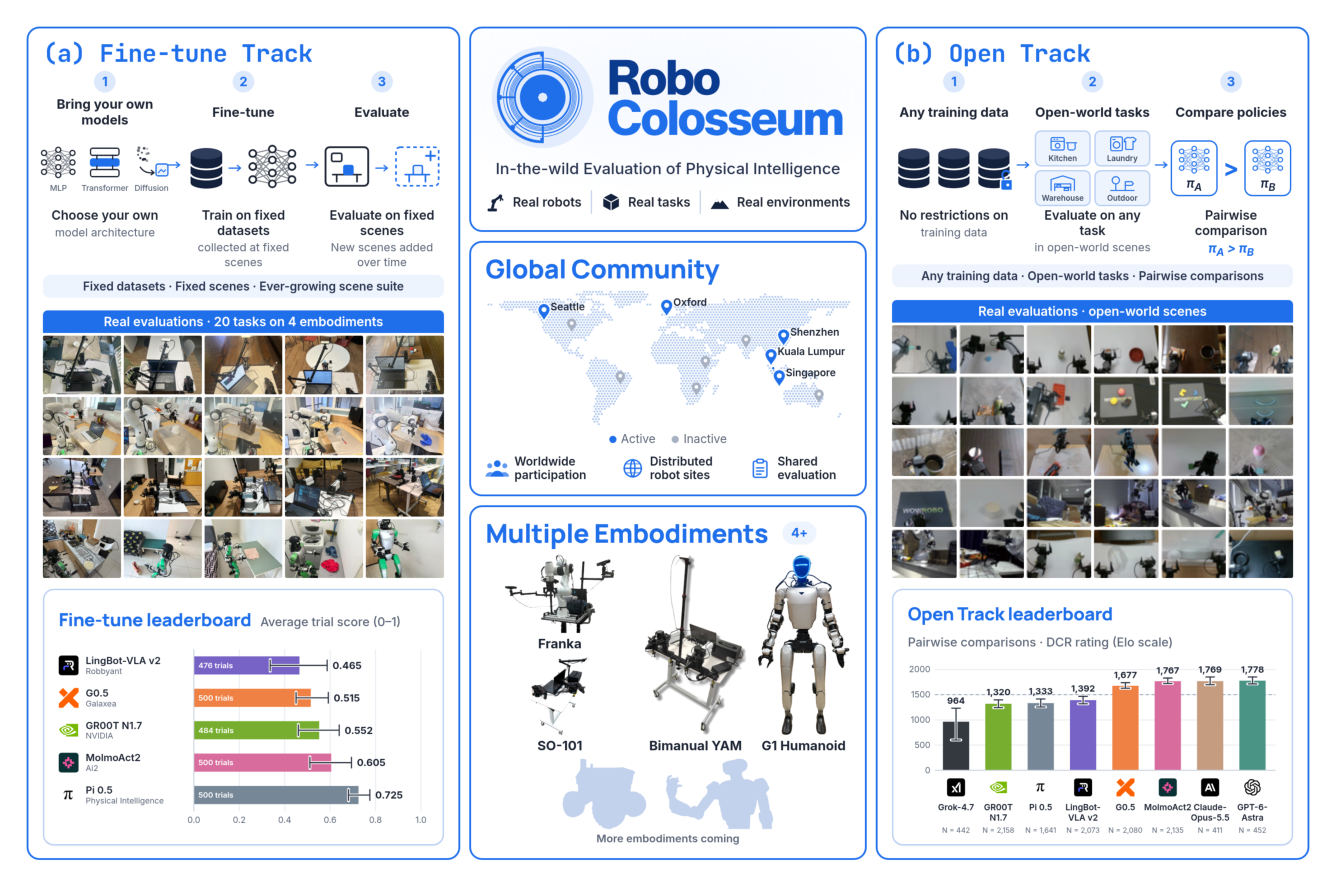
Figure 1 — ROBOCOLOSSEUM 프레임워크의 전체 구조와 두 가지 주요 평가 트랙(Fine-tune Track, Open Track)을 시각적으로 설명하는 핵심 다이어그램.
3. Method & Key Results
본 논문은 일반 목적 로봇 정책의 generalization 및 adaptation capabilities를 평가하기 위한 분산형 실세계 벤치마킹 프레임워크인 ROBOCOLOSSEUM을 제안합니다. 이 프레임워크는 공유 로봇 인터페이스, 정책 serving 인프라, 표준화된 평가 프로토콜을 통해 지리적으로 분산된 평가 site들을 연결합니다. ROBOCOLOSSEUM은 task-specific adaptation 없이 out-of-the-box capabilities를 평가하는 Open Track과 고정된 task-specific demonstration 예산 하에 새로운 조작 기술을 습득하는 능력을 측정하는 Fine-tune Track의 두 가지 보완적인 트랙으로 구성됩니다 [Figure 1]. 본 연구의 초기 평가는 4개의 embodiment(SO-101, Franka, Bimanual-YAM, G1 Humanoid)에 걸쳐 5개의 VLA 정책과 3개의 frontier AI 에이전트를 대상으로 진행되었습니다.
Open Track의 결과, frontier AI 에이전트들은 specialized VLA 정책들과 경쟁적인 조작 성능을 달성했습니다. 예를 들어, GPT-6 Astra는 DROID/Franka에서 가장 높은 DCR rating을 기록했으며, Claude Opus 5.5는 SO-101과 Bimanual-YAM에서 선두를 차지했습니다 [Figure 3]. 하지만, 모든 시스템은 open-world task를 reliably하게 완료하는 데 어려움을 겪었습니다. Task 난이도에 따른 성공률을 보면, 가장 쉬운 task(rated 1-4)에서도 30.7%의 성공률을 보였고, 가장 어려운 task(rated 9-10)에서는 0.4%로 급격히 감소했습니다 [Figure 6].
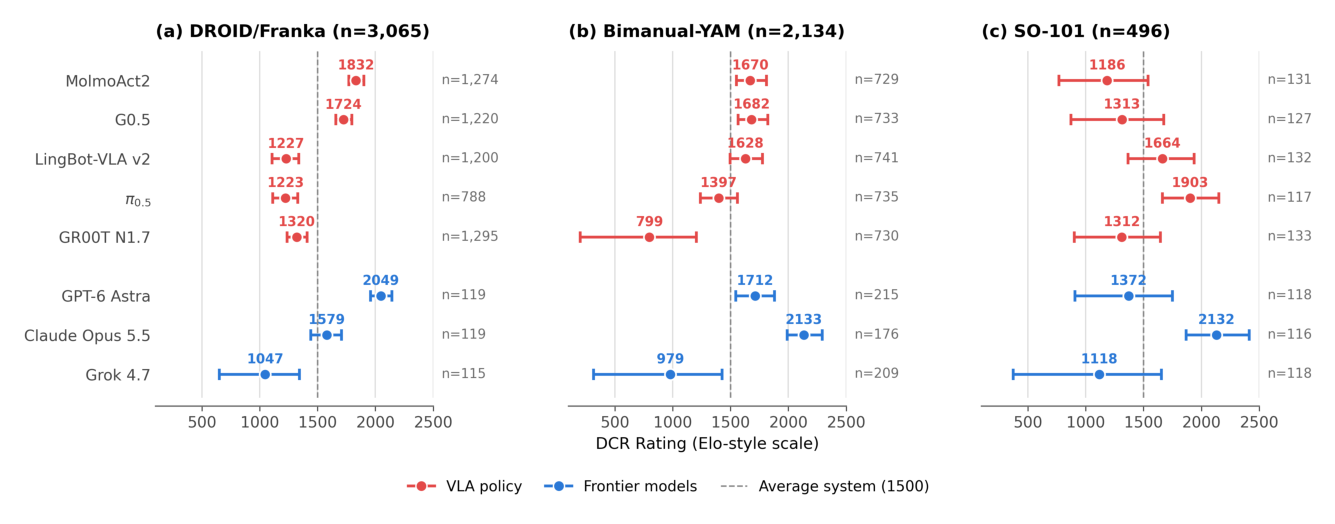
Figure 3 — Open Track에서 각 embodiment별 모델들의 DCR rating (Elo scale)을 비교하여 핵심적인 정량적 성능 결과를 보여주는 그래프.
Fine-tune Track에서는 GR00T N1.7이 SO-101에서, π0.5가 Franka와 Bimanual-YAM에서 탁월한 성능을 보였습니다. Fine-tuning 후 π0.5는 Bimanual-YAM의 5개 task 중 4개에서 96-100%의 success rate를 달성했습니다 [Table 2]. 정책 랭킹의 일관성을 분석한 결과, Open Track과 Fine-tune Track 간에는 상당한 rank reversal이 관찰되었으며, Spearman의 ρ 값은 SO-101에서 -0.20, DROID/Franka에서 -0.40, Bimanual-YAM에서 +0.20로 나타나, 두 트랙 간 랭킹의 제한적인 일치도를 보여주었습니다 [Figure 9]. Task success 만으로는 놓칠 수 있는 behavioral difference를 파악하기 위해 partial progress를 측정한 결과, G1 Humanoid의 경우 어떤 정책도 5개 task 중 하나도 완료하지 못했지만, 평균 progress는 정책별로 13.3%에서 23.2%까지 다양하게 나타났습니다 [Figure 7]. 또한, active matchmaking 전략은 uniform sampling 대비 현저히 적은 물리적 trial(약 400-500회)로도 full-data 랭킹과 유사한 90%의 랭킹 agreement를 달성하여 평가 효율성을 크게 향상시켰습니다 [Figure 11].
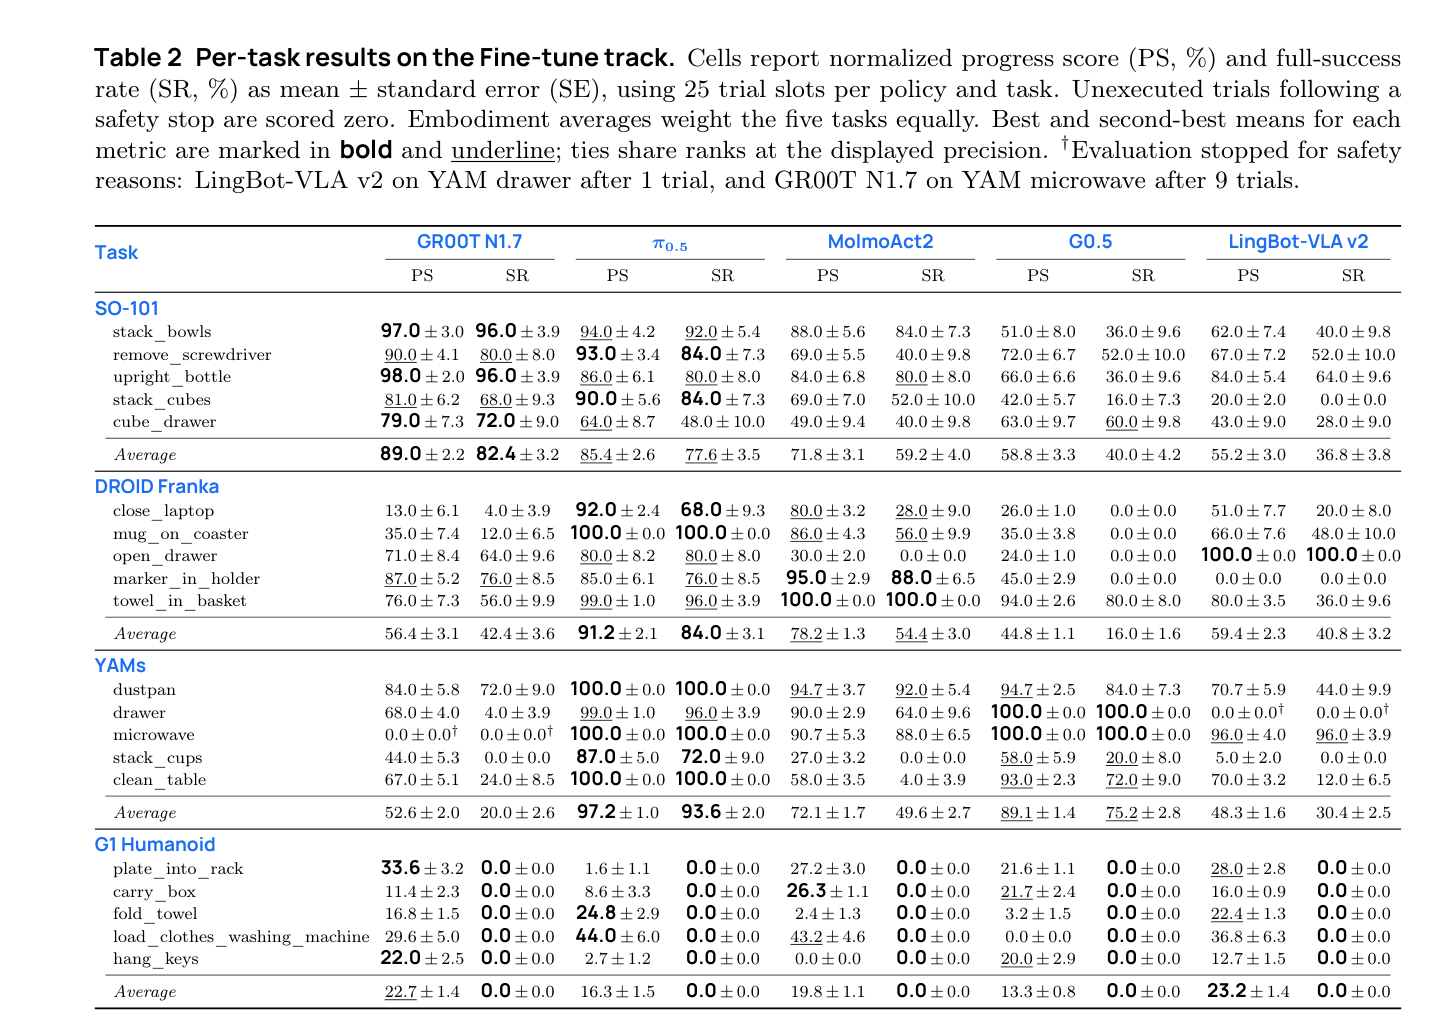
Table 2 — Fine-tune Track에서 각 task 및 embodiment별 모델들의 PS (Progress Score)와 SR (Success Rate)을 상세히 비교하는 핵심 정량적 결과 테이블.
4. Conclusion & Impact
ROBOCOLOSSEUM은 실제 로봇, 다양한 task, 환경, 평가 설정을 포괄하는 분산형 프레임워크를 통해 로봇의 물리적 지능을 측정합니다. 본 연구의 결과는 단일 평가 방식으로는 로봇 모델의 capabilities를 완전히 포착할 수 없음을 명확히 보여줍니다. Frontier AI 에이전트들이 task-specific adaptation 없이도 specialized VLA 정책들과 경쟁적인 성능을 보인다는 점과, fine-tuned 정책들이 task 및 embodiment에 따라 강점이 크게 달라진다는 점은 주목할 만합니다. 나아가, relative model ranking은 평가 트랙과 로봇 플랫폼에 따라 일관성이 없게 변동될 수 있음이 밝혀졌습니다. 이 프레임워크는 이진 task success만으로는 감춰질 수 있는 의미 있는 행동적 차이를 partial progress 측정으로 드러내며, 로봇 정책이 어떻게 generalization하고, 새로운 task에 얼마나 잘 적응하며, 실패한 task에서 얼마나 진전을 보이는지에 대한 critical한 통찰력을 제공합니다. 이는 general-purpose robot learning 모델의 scalable한 개발과 실제 환경에서의 신뢰성 있는 배포를 위한 중요한 scientific insights를 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Robots Need More than VLA and World Models
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] PerturBot: Breaking Shortcut Priors in Vision-Language-Action Models with Perturbative Training
- [논문리뷰] RoboFollow: Unveiling the Instruction Following Mirage in Embodied Agents
Review 의 다른글
- 이전글 [논문리뷰] Recursa: Toward Recursively Self-Improving Foundation Model Systems
- 현재글 : [논문리뷰] RoboColosseum: Evaluating Physical Intelligence at Scale In-The-Wild
- 다음글 [논문리뷰] RoboTryOn: Synthesizing Dexterous Robot Demonstrations from Human Videos via Virtual Try-On
댓글