[논문리뷰] Video-Coder: Reinforcing Agentic Coding for Video Generation
링크: 논문 PDF로 바로 열기
저자: Chaoyang Wang, Sicheng Gao, Junan Hu, Kunyang Li, Dongyang Chen, Yiyang Zhou, Huaxiu Yao, Yong Jae Lee, Radu Timofte, Yuzhang Shang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Draft Video (White-model Video): Agent가 작성한 Blender Python 코드를 실행해 만든 3D scene을 렌더링한 영상입니다. Texture가 없는 회색 clay shading을 쓰며, 고정된 resolution과 frame rate로 렌더링됩니다. 구조(structure)와 움직임(motion) 정보만 담고 있으며, downstream video generator에 guidance로 입력됩니다.
- Video-Coder Harness: 코드 실행, 3D scene rendering, 실행 feedback을 하나로 묶은 interactive sandbox 환경입니다.
check_script(static check)와run_blender(실행 및 렌더링)라는 두 tool을 제공합니다. Feedback은 Execution feedback, Content checks, Visual feedback의 세 종류입니다. - Dual Reward (R_exe / R_video): RL 학습에 쓰이는 두 reward입니다. R_exe는 tool call format이 올바르고 프로그램이 성공적으로 실행되는지를 보는 binary reward(0/1)입니다. R_video는 Qwen3.8-omni-flash가 최종 영상이 text prompt 및 reference video와 얼마나 일치하는지 평가한 점수이며, [0,1]로 정규화됩니다.
- Annealing Reward Schedule: 최종 reward를 R = α·R_video + e^(−steps/T)·R_exe로 정의합니다. 학습이 진행될수록 execution reward의 비중이 지수적으로 줄어드는 time-based 전략입니다(α = 0.5).
- Video-Coder-SFT / Video-Coder-RL Datasets: 자체 pipeline으로 구축한 학습 데이터입니다. SFT용은 prompt, multi-turn agentic trajectory, ground-truth video로 구성되고, RL용은 prompt와 reference video 쌍으로 구성됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 기존 video generation model이 정확한 spatial structure, 일관된 motion dynamics, 제어 가능한 scene composition을 만들어내지 못한다는 문제를 다룹니다. 이를 해결하기 위해 저자들은 실행 가능한 code로 3D scene을 직접 구성하는 coding agent를 학습시킵니다.
- 기존 생성 모델의 한계: Diffusion이나 autoregressive 기반 모델은 pixel 또는 latent space에서 video distribution을 학습할 뿐, 밑바탕의 3D world를 명시적으로 모델링하지 않습니다. 그 결과 다음과 같은 오류가 자주 나타납니다.
- 잘못된 object count와 위치
- 일관되지 않은 occlusion
- 물리적으로 부자연스러운 trajectory
- 형태가 변하거나 사라지는 object
- 편집과 재현의 어려움: End-to-End로 생성된 영상은 편집하거나 재현하기 어렵습니다. 그래서 사용자는 trial-and-error로 prompt를 다시 써야 합니다.
- 기존 code-driven 접근의 한계: GPT4Motion이나 Video-CoCo처럼 LLM으로 Blender code를 생성하는 연구가 있었습니다. 그러나 대부분 frozen(주로 proprietary) model을 고정된 pipeline에서 single-turn으로 prompting하는 데 그쳤습니다. 실행 feedback으로 코드를 고치거나 최종 video quality를 직접 최적화하지는 않았습니다.
- 필요한 데이터의 부재: 이런 agent를 학습하려면 prompt, multi-turn coding trajectory, grounded video를 동시에 갖춘 데이터가 필요합니다. 하지만 이런 데이터는 자연적으로 존재하지 않습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
Video-Coder는 video generation을 agentic programming task로 정의합니다. Agent는 text prompt를 받아 Blender 코드를 작성·실행해 Draft Video를 만들고, 이를 downstream generator의 structure 및 motion guidance로 넘깁니다 [Figure 1].
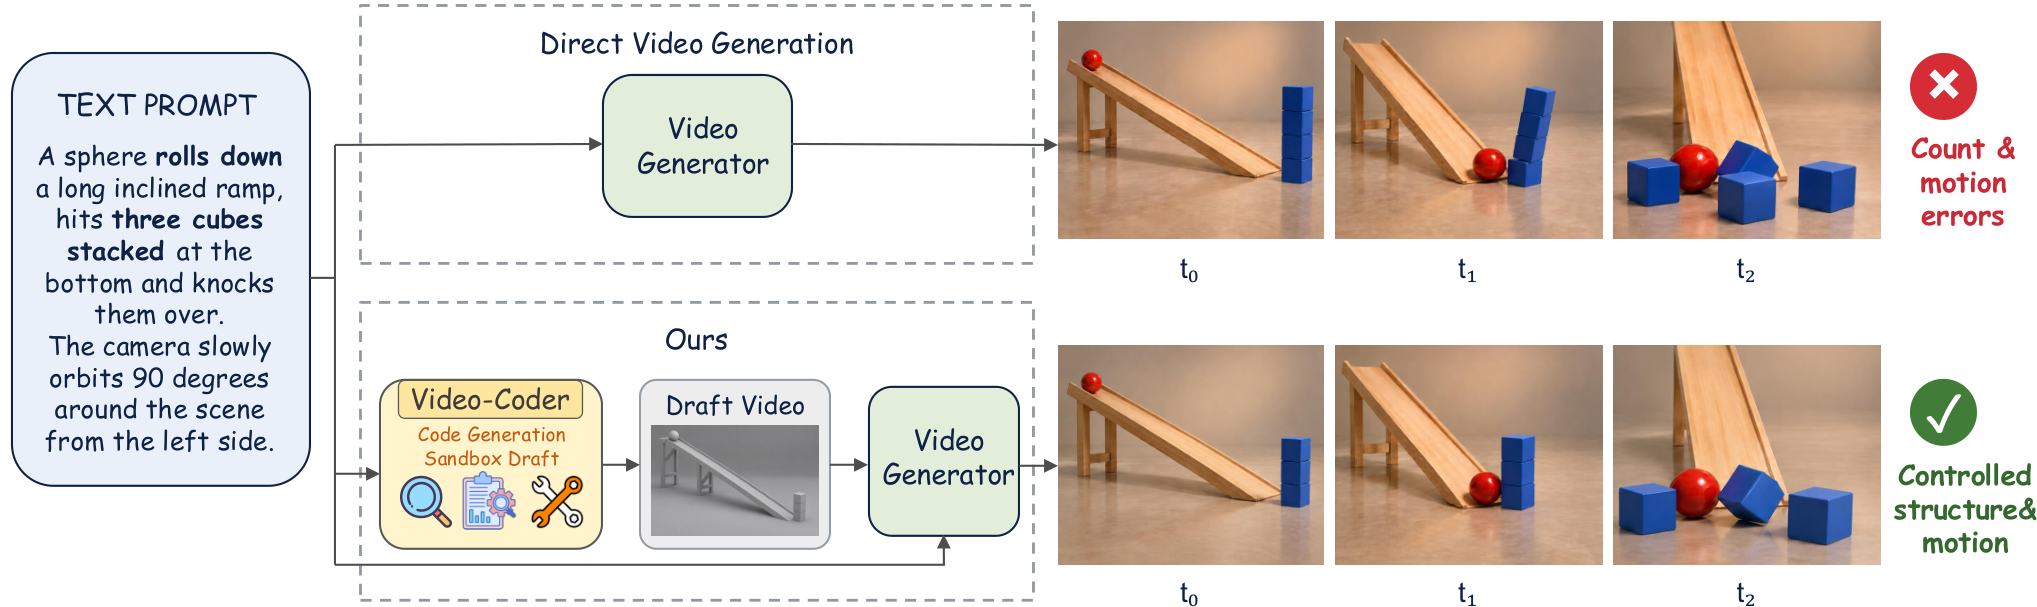
Figure 1 — Video-Coder 전체 개요
방법론
- 데이터 구축 pipeline (4단계) [Figure 2]
- Text prompt 구성: LLM이 공개 dataset의 caption을 scene-centric description으로 다시 씁니다.
- Trajectory 생성: Gemini 3.8 Flash를 Harness에 연결해 multi-turn trajectory를 생성합니다.
- Ground-truth video 합성: MiniMax-H3로 ground-truth video를 합성합니다.
- Filtering: Seed2.0 기반 prompt–video consistency 판정 등을 포함한 3단계 filtering을 적용합니다.
- 결과 데이터셋: 본문 3.1절과 abstract 기준으로 Video-Coder-SFT-6k와 Video-Coder-RL-2k를 얻습니다. 단, 실험 설정과 결론에서는 SFT-10k / RL-4k로 표기되어 있어 수치가 일치하지 않습니다.
- Harness의 검증 방식: Agent가 결과를 제출하면, Harness는 최종 script를 깨끗한 디렉터리에서 처음부터 다시 실행합니다. 이 재실행이 모든 check를 통과해야만 episode를 인정하므로 결과의 reproducibility가 보장됩니다.
- 학습: Qwen3.5-9B를 base로 2단계 학습을 진행합니다.
- SFT: scene-programming과 tool-calling 능력을 학습합니다.
- Agentic RL: harness-native 방식으로 GRPO를 적용합니다.
- 주요 설정은 group size 8, 최대 100 turn, context length 120K입니다.
- Video generator는 학습 중 고정되어 있습니다.
- 학습은 policy용 H100 8대와 rollout용 MiniMax-H3 서빙 H100 16대를 사용해 약 3일이 걸렸습니다.
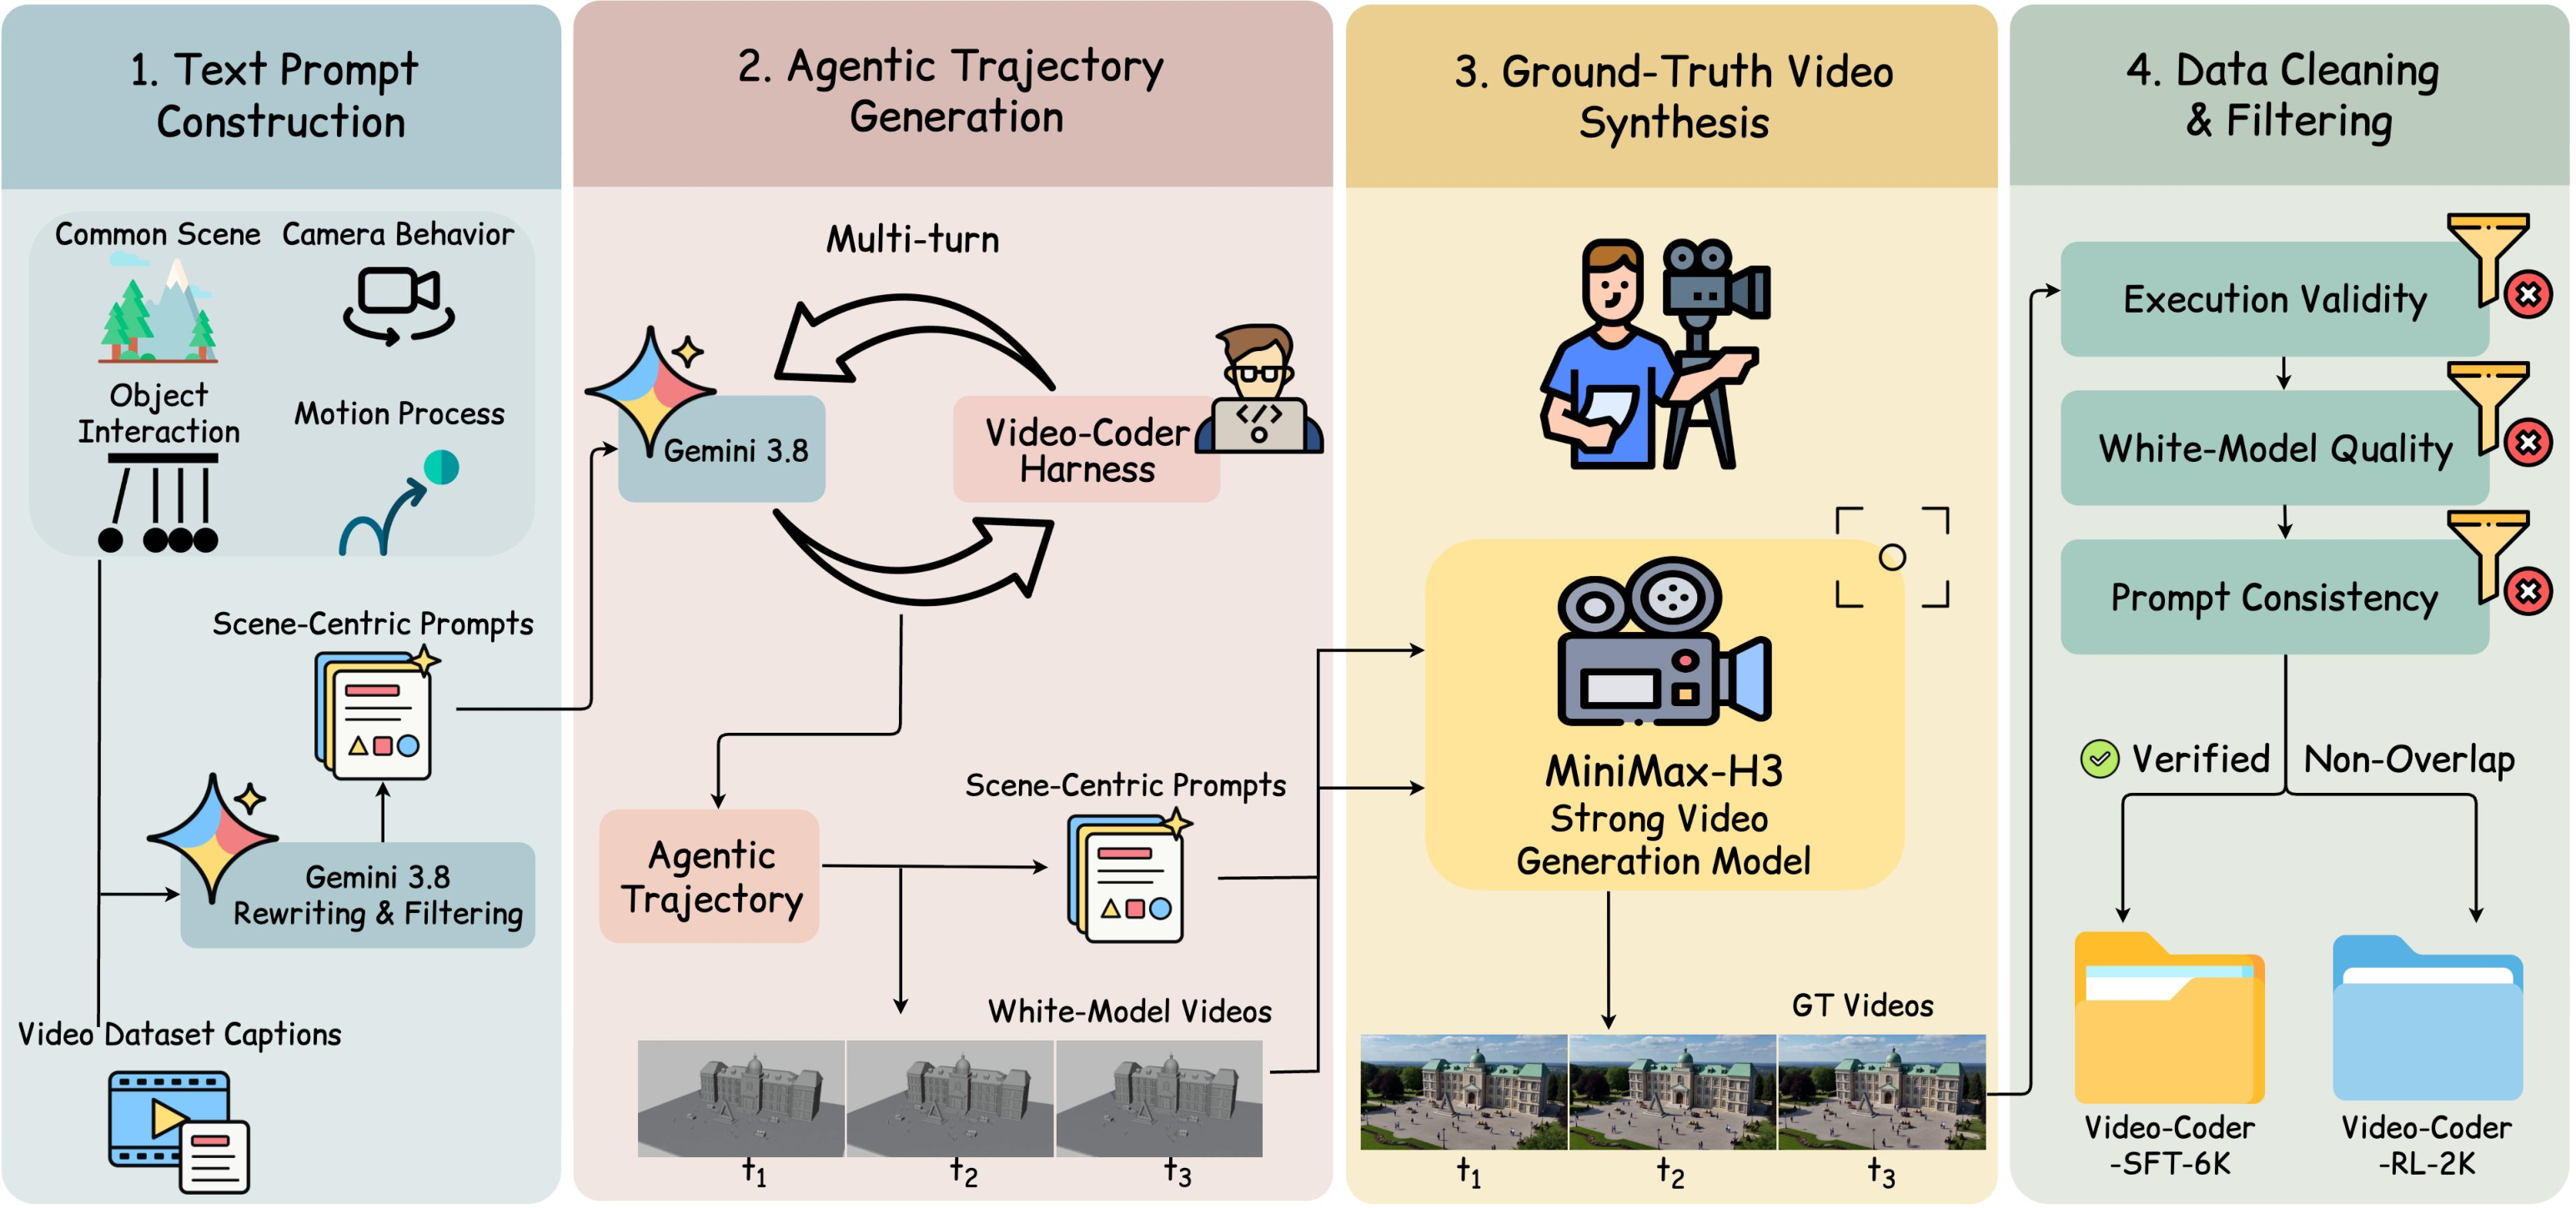
Figure 2 — 데이터 구축 pipeline
핵심 결과
-
PhyGenBench: Video-Coder-9B + MiniMax-H3가 average 0.67로 비교 대상 중 최고 점수를 기록했습니다.
- MiniMax-H3 단독(0.61) 대비 향상입니다. 논문은 abstract에서 "약 7 points", ablation에서 "6 points"로 서로 다르게 서술합니다.
- Mechanics 0.68, Optics 0.79, Thermal 0.60, Material 0.61로 4개 category 모두 1위입니다.
- Wan2.2-TI2V-5B(0.54), Gen-3(0.51), Kling(0.49)도 앞섭니다.
-
Generator 간 일반화: RL 학습 때 쓰지 않은 OmniWeaving에 적용해도 0.48 → 0.51로 향상되었습니다. 다만 논문 본문은 이를 "16.28 points 향상"이라고 표기하고 있어, 표의 수치와 맞지 않습니다.
-
VBench-2.0 (physical dimensions): Average plausibility 78.19%로, CogVideoX-1.5(77.04%)를 앞서는 최고 점수입니다.
- MiniMax-H3(54.58%) 대비 약 24 points 향상입니다.
- 특히 Mechanics에서 88.67%를 기록해 MiniMax-H3보다 21.08 points 높았습니다.
- 반면 Material은 75.02%로 CogVideoX-1.5(83.19%)에 뒤집니다. 저자들은 그 이유로 Draft Video가 appearance나 material 정보를 담지 않는다는 점을 듭니다.
-
Ablation (PhyGenBench): 아래 결과는 SFT, RL, 두 reward, annealing이 각각 성능에 기여함을 보여줍니다.
설정 PhyGenBench average MiniMax-H3 단독 0.61 SFT only 0.63 Video reward 제거 0.64 Execution reward 제거 0.63 Annealing 제거 0.65 Full model 0.67 -
α sensitivity: α = 0.5~0.6에서 성능이 안정적이었고, 0.4와 0.7에서는 소폭 하락했습니다.
-
정성적 결과: Draft Video가 object count(예: 차 세 대, 보트 세 척), layout, camera framing을 명시적으로 고정합니다. 최종 영상은 이 구조를 유지하면서 사실적인 appearance를 더합니다 [Figure 3].
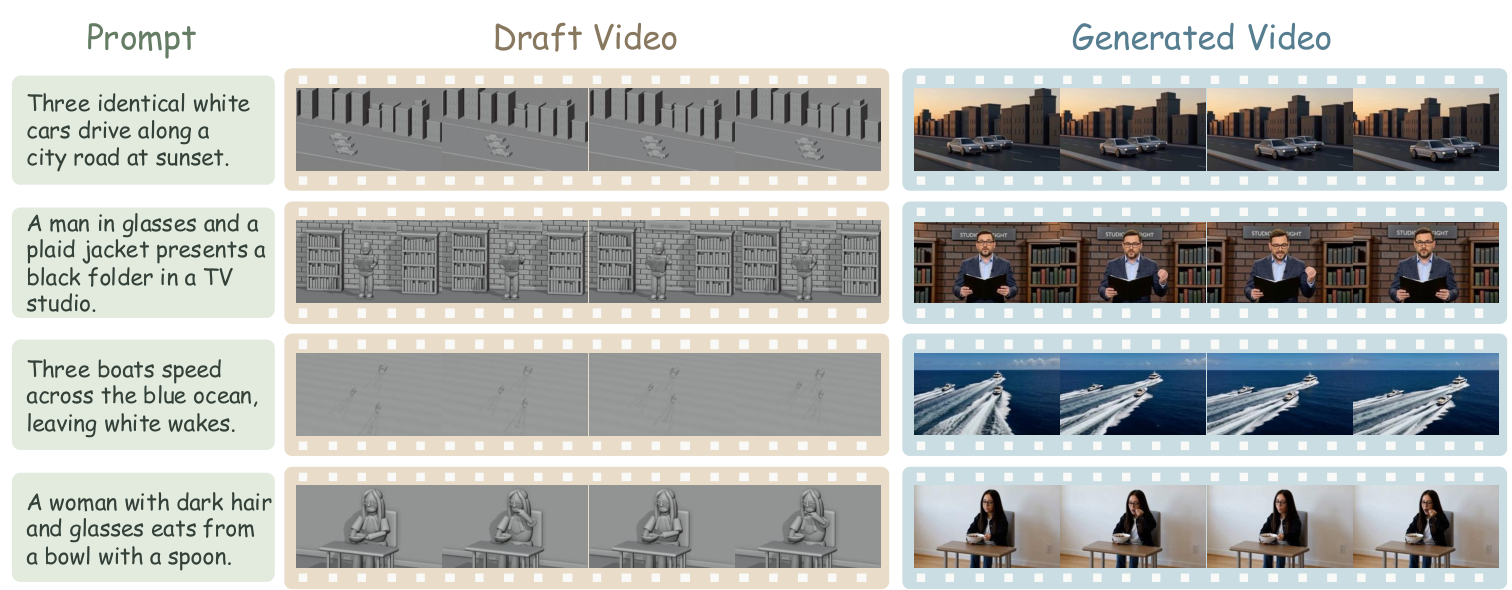
Figure 3 — 정성적 생성 예시
4. Conclusion & Impact (결론 및 시사점)
Video-Coder는 multimodal coding agent를 SFT와 agentic RL로 학습시켜 video generation의 physical consistency를 크게 높인 최초의 시도라고 저자들은 주장합니다. 두 벤치마크(PhyGenBench, VBench-2.0)에서 base generator 대비 큰 향상을 보였고, RL 학습에 쓰지 않은 generator에도 이전되는 transferability를 확인했습니다.
시사점
- 역할 분리: 구조와 움직임은 executable code가, appearance는 video generator가 맡는 decoupled 패러다임을 제시합니다. 이를 통해 controllability, interpretability, reproducibility를 동시에 확보할 수 있음을 보였습니다.
- Agentic RL의 확장: Agentic RL을 visual generation 영역으로 넓혔습니다. 특히 execution reward에서 video reward로 비중을 옮기는 annealing 설계는 multi-turn tool-use agent 학습에 일반적으로 참고할 만한 reward 설계 사례입니다.
- 오픈 소스: 데이터, 모델, 코드를 모두 공개해 code-driven video generation 연구의 open foundation이 될 것으로 기대됩니다.
- 한계: Material처럼 appearance에 의존하는 현상에는 한계가 남아 있습니다.
- 수치 확인 필요: 논문 안에서 데이터셋 크기(6k/2k vs 10k/4k)와 일부 향상 폭(PhyGenBench 6 vs 7 points, OmniWeaving의 "16.28 points")이 서로 다르게 표기되어 있습니다. 인용할 때는 원문 수치를 확인하는 것이 좋습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
- [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
- [논문리뷰] 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
- [논문리뷰] CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
- [논문리뷰] Code-as-Room: Generating 3D Rooms from Top-Down View Images via Agentic Code Synthesis
Review 의 다른글
- 이전글 [논문리뷰] The Last Mile to the Real World: Agent-Native Primitives as Reusable Building Blocks for Solving Real-World Tasks
- 현재글 : [논문리뷰] Video-Coder: Reinforcing Agentic Coding for Video Generation
- 다음글 [논문리뷰] Where to Connect? Boosting MLLMs via Dynamic Gated Pathways across ALL ViT and LLM Layers
댓글