[논문리뷰] G-CAST: Governed Continual Self-Training for E-Commerce Agents under Evolving Demands
링크: 논문 PDF로 바로 열기
저자: Yuechun Yu, Wenzheng Kong, Xiaofeng Mao, Jin Zhang (Alibaba Group)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Capability Contract: 에이전트가 쓸 수 있는 정보, 취할 수 있는 action, 따라야 하는 interaction protocol을 한데 묶은 개념이다. tool, skill, operating procedure가 추가되면 이 contract도 함께 확장된다.
- Model / Data / Reward Mismatch: harness가 확장될 때 함께 발생하는 세 가지 불일치이다. Model mismatch는 모델이 새 capability를 인식하거나 호출하지 못하는 경우이다. Data mismatch는 이전 harness에서 모은 trajectory에 새 capability에 대한 evidence가 없는 경우이다. Reward mismatch는 기존 reward가 새 contract에 맞는 행동을 제대로 평가하지 못하는 경우이다.
- Reward-Routed, Entropy-Prioritized Data Orchestration: query마다 8개 rollout을 생성한 뒤 결과에 따라 데이터를 나눈다. 모두 실패한 query는 SFT, 성공과 실패가 섞인 query는 RL, 모두 성공한 query는 regression monitoring으로 보낸다. 이렇게 나눈 각 pool 안에서는 token-level entropy(90th percentile)로 우선순위를 매긴다.
- Governed Checkpoint Transition: 학습 job 하나를 끝내는 것이 아니라 checkpoint 교체를 adaptation의 단위로 본다. candidate checkpoint는 새 task와 이전에 accept된 모든 task에 대한 cumulative evaluation을 통과해야만 승격된다.
- Contract-Driven Reward Evolution: executable reward를 versioned component의 묶음으로 관리하는 방식이다. reward update는 target-case validation, regression check, offline rescoring, trajectory replay 등의 gate를 통과한 뒤에만 학습에 반영된다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 문제는 배포된 e-commerce agent의 성능 저하이다. 사용자 수요가 바뀌는 Demand drift와 tool·skill이 계속 추가되는 Harness evolution이 동시에 일어나면서, 한 번 학습한 모델이 점점 뒤처진다. 실제로 고정된 checkpoint를 Period 1부터 4까지 그대로 쓰면 cumulative base reward가 0.9065에서 0.6354로 떨어지고, 새로 추가된 Period 4에서는 0.1877까지 하락한다 [Figure 2].
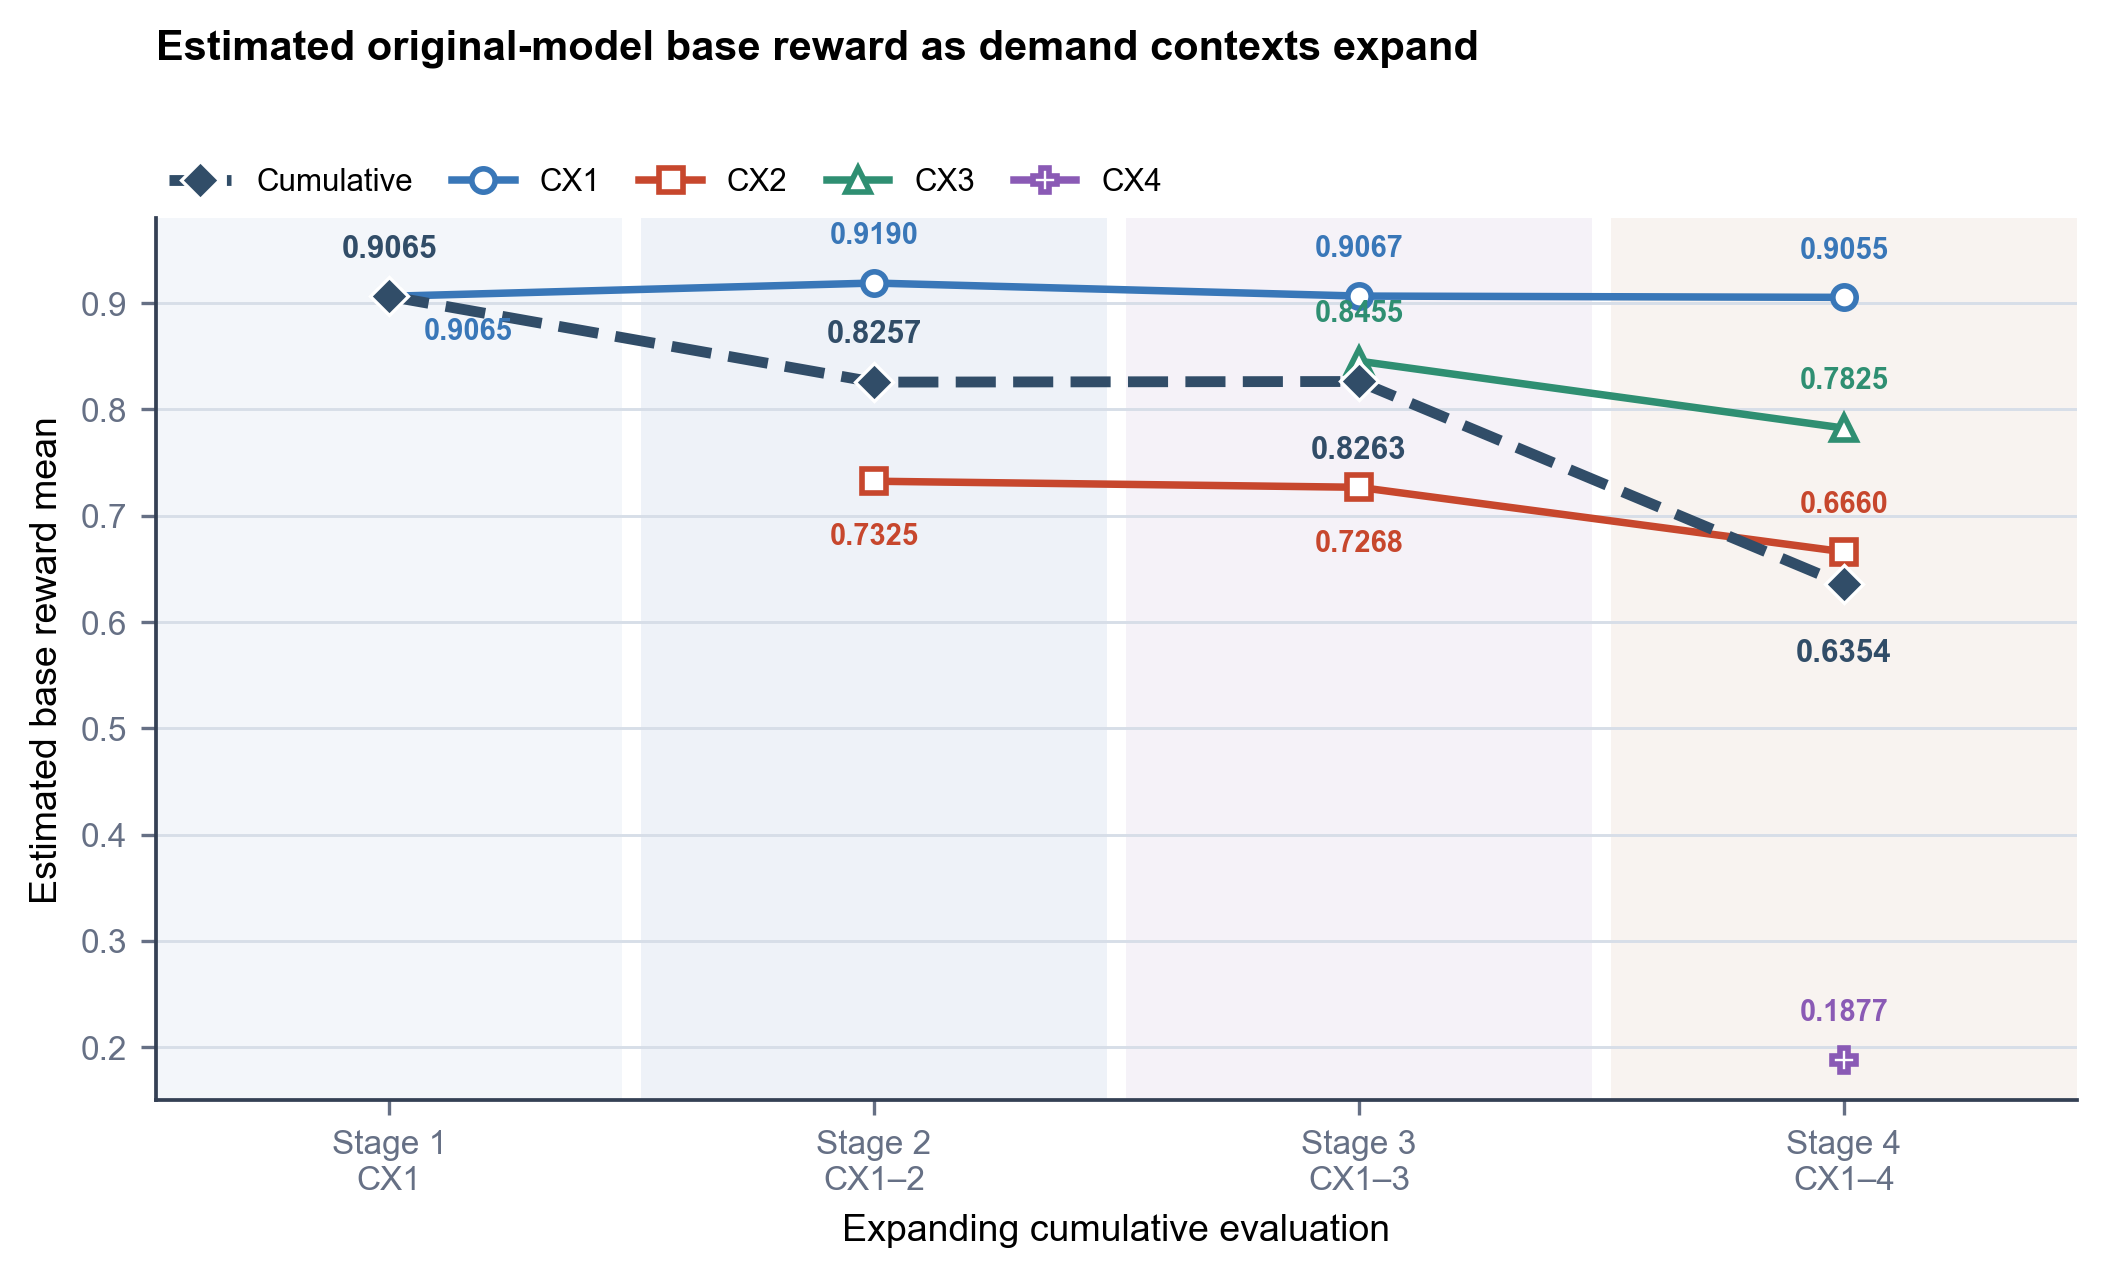
Figure 2 — 고정 모델 성능 저하
주기적인 수동 재학습은 반영이 너무 늦고 인력도 많이 든다. 기존 self-evolution 연구들은 이 문제의 일부만 다룬다.
- ACE: 모델을 고정한 채 context playbook만 진화시킨다.
- Q-Evolve: task-specific environment feedback에 의존한다.
- SIA: harness와 weight를 함께 업데이트하지만, task specification과 verifier가 고정되어 있다고 가정한다.
- AutoTrainess와 같은 autonomous post-training 기법: 미리 정해진 objective를 최적화할 뿐, contract가 바뀔 때 reward 자체가 여전히 유효한지는 검증하지 않는다.
결국 model, data, reward 세 가지 mismatch를 함께 다루면서 이전 capability도 보존하는 체계적인 방법이 필요하다는 것이 저자들의 문제의식이다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 G-CAST를 제안한다. 매일 쌓이는 production evidence를 reward-routed 학습 데이터와 governed reward update로 바꾸는 continual self-training 시스템이다 [Figure 1].
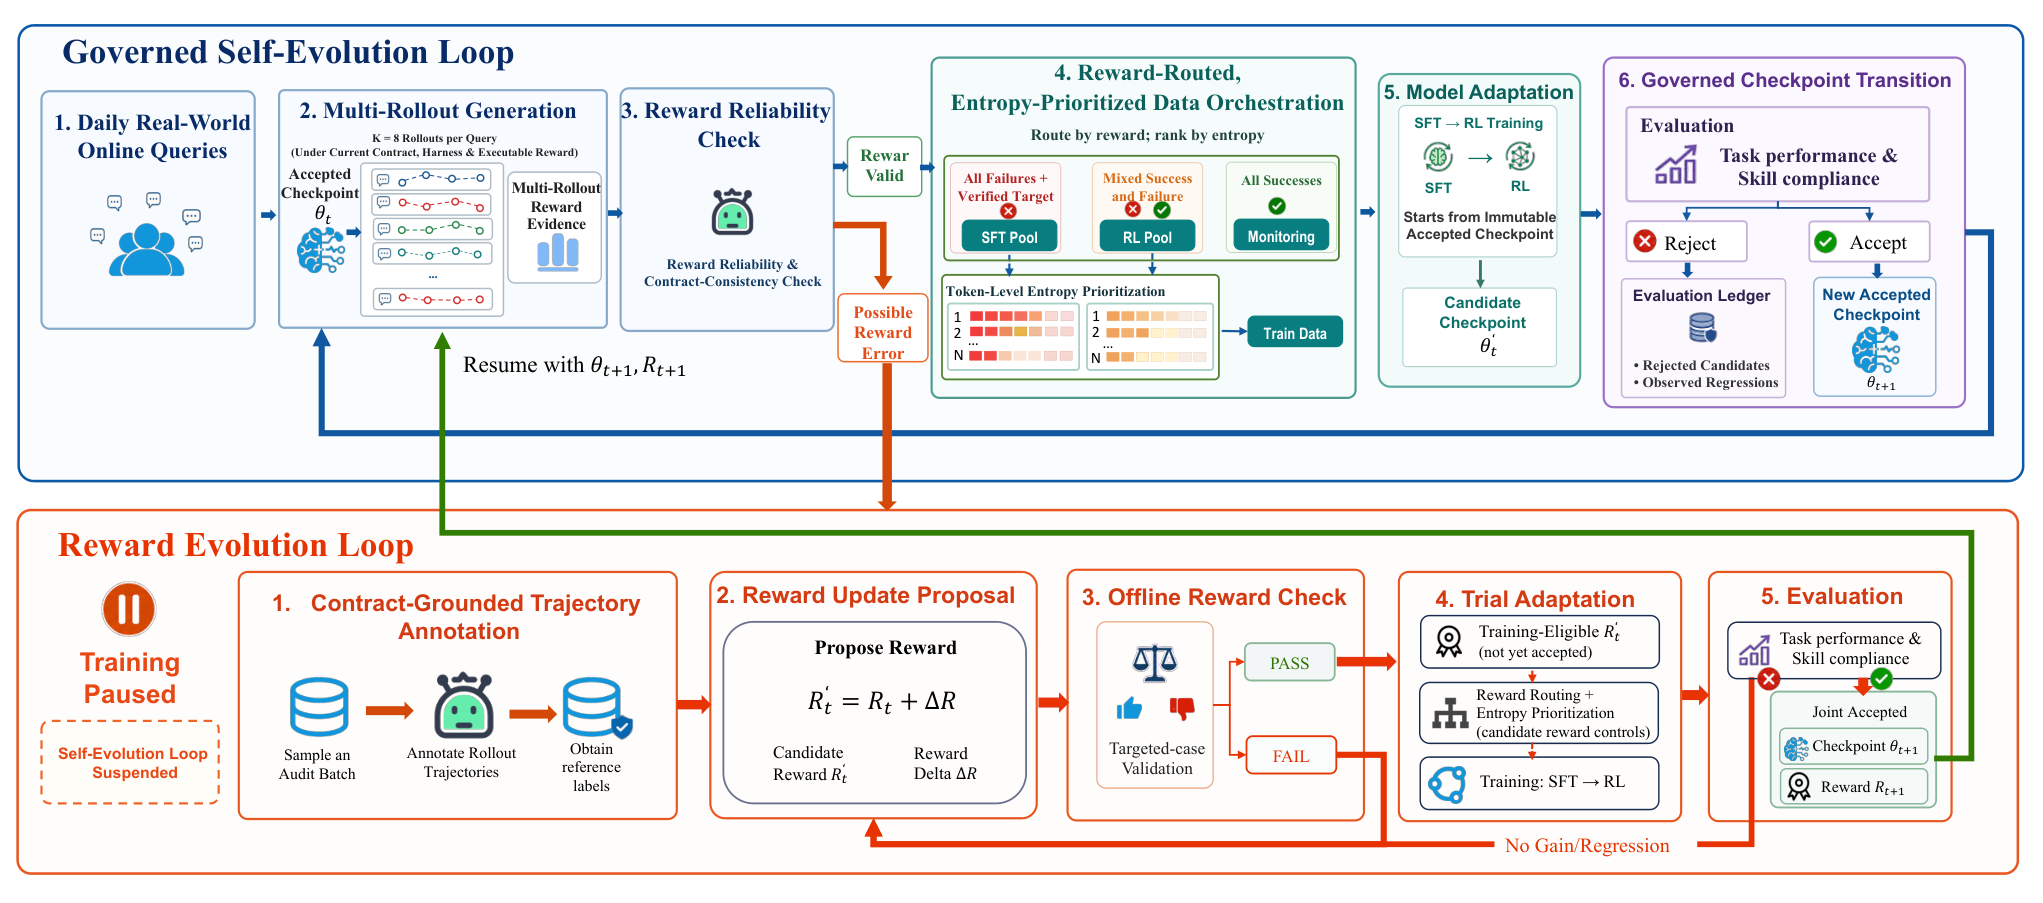
Figure 1 — G-CAST 전체 구조
동작 방식
- 매 round는 변경 불가능한(immutable) accepted checkpoint에서 시작한다. production query마다 rollout 8개를 생성하고 reward reliability check를 수행한다.
- Routing 기준: 상·하위 5%를 trimming한 mean reward를 reference로 쓴다. 모든 rollout이 reference 미만이면 SFT pool(검증된 target이 있는 경우), 결과가 섞여 있으면 RL pool, 모두 reference 이상이면 regression monitoring으로 보낸다. 즉 reward는 각 query의 학습 역할을 정하고, entropy는 pool 안에서 학습 budget을 어디에 쓸지 정한다.
- Reward 진화: reward가 오류를 일으킨 것으로 의심되면 학습을 멈추고 reward-evolution loop로 넘어간다. 이 loop는 contract-grounded annotation → reward update proposal → offline validation → trial adaptation → joint evaluation의 5단계로 구성된다.
- reward는 contract 확장에 따라 누적적으로 커진다: R_fmt → +P_gd, P_retrieval → +R_skill-sel, R_skill-adh.
- 실험 설정: base model은 Qwen3-4B-Thinking-2507이다. 4개 period 각각에 2,000-query rollout pool과 별도의 100-query evaluation slice를 두었고, 사용 가능한 tool 수는 period별로 4 → 7 → 17 → 23개로 늘어난다.
주요 결과
- AutoTrainess 대비: Iteration 1–2에서 G-CAST는 더 적은 데이터로 경쟁력 있는 성능을 냈다. 예를 들어 Iteration 1에서는 SFT 94 + RL 500 query로 cumulative reward를 0.9065에서 0.9240으로 올렸고, AutoTrainess는 1,200 query로 0.9360에 도달했다. skill이 필요한 Iteration 3–4에서는 순위가 뒤집혔다. Iteration 3에서 0.9288 vs. 0.9210, Iteration 4에서 0.8078 vs. 0.7911로 G-CAST가 앞섰다.
- Retention: Iteration 4에서 G-CAST는 retained reward를 +0.012 올렸다(0.8712→0.8833). 반면 AutoTrainess는 −0.017(0.8907→0.8739)로 forgetting이 나타났다. 같은 iteration의 skill-selection accuracy는 0.7625 vs. 0.6875였다.
- Data orchestration ablation: Post-RL cumulative reward 기준으로 Reward + Entropy가 0.7930, Reward + Random이 0.7721, Random이 0.7334였다. reward routing과 entropy prioritization이 각각 독립적으로 성능을 높인다는 뜻이다.
- Reward evolution ablation (Period 1–3):
| 방식 | Cumulative reward | Skill-selection accuracy |
|---|---|---|
| Gated (G-CAST) | 0.9288 | 0.8667 |
| Ungated | 0.8926 | 0.6956 |
| Static | 0.8810 | 0.6867 |
- reward 항목을 단순히 추가하는 것(Ungated)만으로는 부족하고, gate를 거친 governed evolution이 필요하다는 결과이다.
- 높은 reward를 받은 trajectory를 감사한 결과, search-result misuse는 84%, hallucinated entity는 82%의 false-positive rate를 보였다. 이것이 grounding penalty를 도입한 근거가 되었다.
4. Conclusion & Impact (결론 및 시사점)
결론은 다음과 같다. 수요가 계속 바뀌는 환경에서 continual adaptation은 고정된 objective로 반복 학습하는 문제가 아니라, model·data·reward mismatch를 함께 풀어야 하는 문제이다. checkpoint transition을 단위로 하는 G-CAST는 새 capability를 학습하면서도 기존 capability를 보존한다.
운영 측면에서도 성과가 보고되었다. 1688 플랫폼의 B2B procurement agent인 Yuancai에 배포된 이후 다음과 같은 변화가 있었다.
- reward-audit 인력: round당 약 2 person-day → 30분
- 수요 발생부터 acceptance까지의 turnaround: 약 1주 → 2일
- gate가 checkpoint 3개와 reward version 2개를 reject했다.
이 연구는 산업 현장에서 LLM agent를 운영할 때 reward 자체를 버전 관리와 검증의 대상으로 다뤄야 한다는 실무적 근거를 제시한다. 다만 하나의 production application과 하나의 model family만으로 검증했기 때문에, 다른 agent setting으로 일반화할 수 있는지는 아직 확인되지 않았다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MetaClaw: Just Talk -- An Agent That Meta-Learns and Evolves in the Wild
- [논문리뷰] Can Coding Agents Sustain Continual Evolution without Forgetting?
- [논문리뷰] On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
- [논문리뷰] Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design
- [논문리뷰] UniSkill: Learning Actor-Aligned Skill Proposals for an Evolving Policy
Review 의 다른글
- 이전글 [논문리뷰] Evidence-Governed Adoption of Self-Generated Updates in Autonomous AI Agents
- 현재글 : [논문리뷰] G-CAST: Governed Continual Self-Training for E-Commerce Agents under Evolving Demands
- 다음글 [논문리뷰] GH-AWTrace: A Large-Scale Dataset of GitHub Agentic Workflow Execution Logs
댓글