[논문리뷰] CARE: Experience-Guided Atomic Corrective Execution for Vision-Language-Action Policies
링크: 논문 PDF로 바로 열기
저자: Junlan Xiao, Junwei Jiang, Zaibin Zhang, Yifan Wang, Zhongbo Zhang, Huchuan Lu, Lijun Wang
1. Key Terms & Definitions
- Vision-Language-Action (VLA) Policies: 시각 및 언어적 입력을 활용하여 로봇의 행동을 생성하는 로봇 정책을 지칭합니다.
- Atomic Corrective Execution: 긴 작업(long-horizon task)을 더 작은, 독립적인 atomic stage로 분해하고, 이러한 스테이지 내 또는 후에 발생하는 편차(deviation)를 수정하는 프레임워크입니다.
- Experience-Guided Corrective Data Synthesis: 로봇의 실제 실행 과정에서 발생하는 실패 분포를 모델링하여 수정(corrective) 학습 데이터를 생성하는 방법론으로, 무작위 교란(random perturbations) 방식과 대비됩니다.
- 3D Geometric Monitor: 물리적으로 grounding된(physically grounded) point-cloud 기반 시스템으로, 기하학적 술어(geometric predicates)를 활용하여 편차를 감지하고 수정 행동을 유발합니다.
- Failure State Recovery Benchmark (FSR-Bench): 로봇 조작 작업에서 중간 실패 상태(intermediate failure states)로부터의 Recovery 능력을 평가하기 위해 새롭게 도입된 벤치마크입니다.
2. Motivation & Problem Statement
본 논문은 Vision-Language-Action (VLA) Policies가 로봇 조작에서 강력한 성능을 보임에도 불구하고, 실행이 nominal trajectory에서 벗어날 경우 취약하다는 핵심 문제를 제기합니다. 기존 VLA Policies는 주로 성공적인 expert demonstration으로 학습되며 nominal initial states에서 평가되기 때문에, 실제 배포 시 발생할 수 있는 객체 미끄러짐, 전복, 또는 잘못된 배치와 같은 execution-induced deviation 상태에 대한 학습이 부족합니다. 이러한 편차는 빠르게 작업 실패로 이어질 수 있으므로, 로버스트한 조작을 위해서는 nominal behavior 실행뿐만 아니라, execution 과정에서 발생하는 중간 실패 상태로부터의 recovery 능력이 필수적입니다.
기존 recovery 방법론은 주로 실패를 제거해야 할 예외로 간주하여 시스템을 롤백(rollback)하거나 초기 상태에서 재계획(replanning)하는 방식 또는 임의의 교란(random perturbations)을 통해 corrective demonstration을 수집하는 방식을 사용합니다. 그러나 이러한 방법들은 실제 policy execution에 의해 유발되는 post-failure deviation을 명시적으로 모델링하지 못하며, 이로 인해 학습된 corrective behavior의 효과가 제한적일 수 있습니다. 또한, 기존 로봇 조작 벤치마크들은 주로 nominal initial states에서의 task execution 성공률을 측정하므로, 중간 실패 상태로부터의 recovery 능력을 평가하기에는 적합하지 않습니다.
3. Method & Key Results
본 논문은 로봇 조작의 Failure Recovery 능력을 향상시키기 위해 CARE (Corrective Atomic Robotic Execution) 프레임워크를 제안하며, 이는 Experience-Guided Corrective Data Synthesis와 Atomic Corrective Execution의 두 가지 핵심 구성 요소로 이루어집니다 [Figure 2].
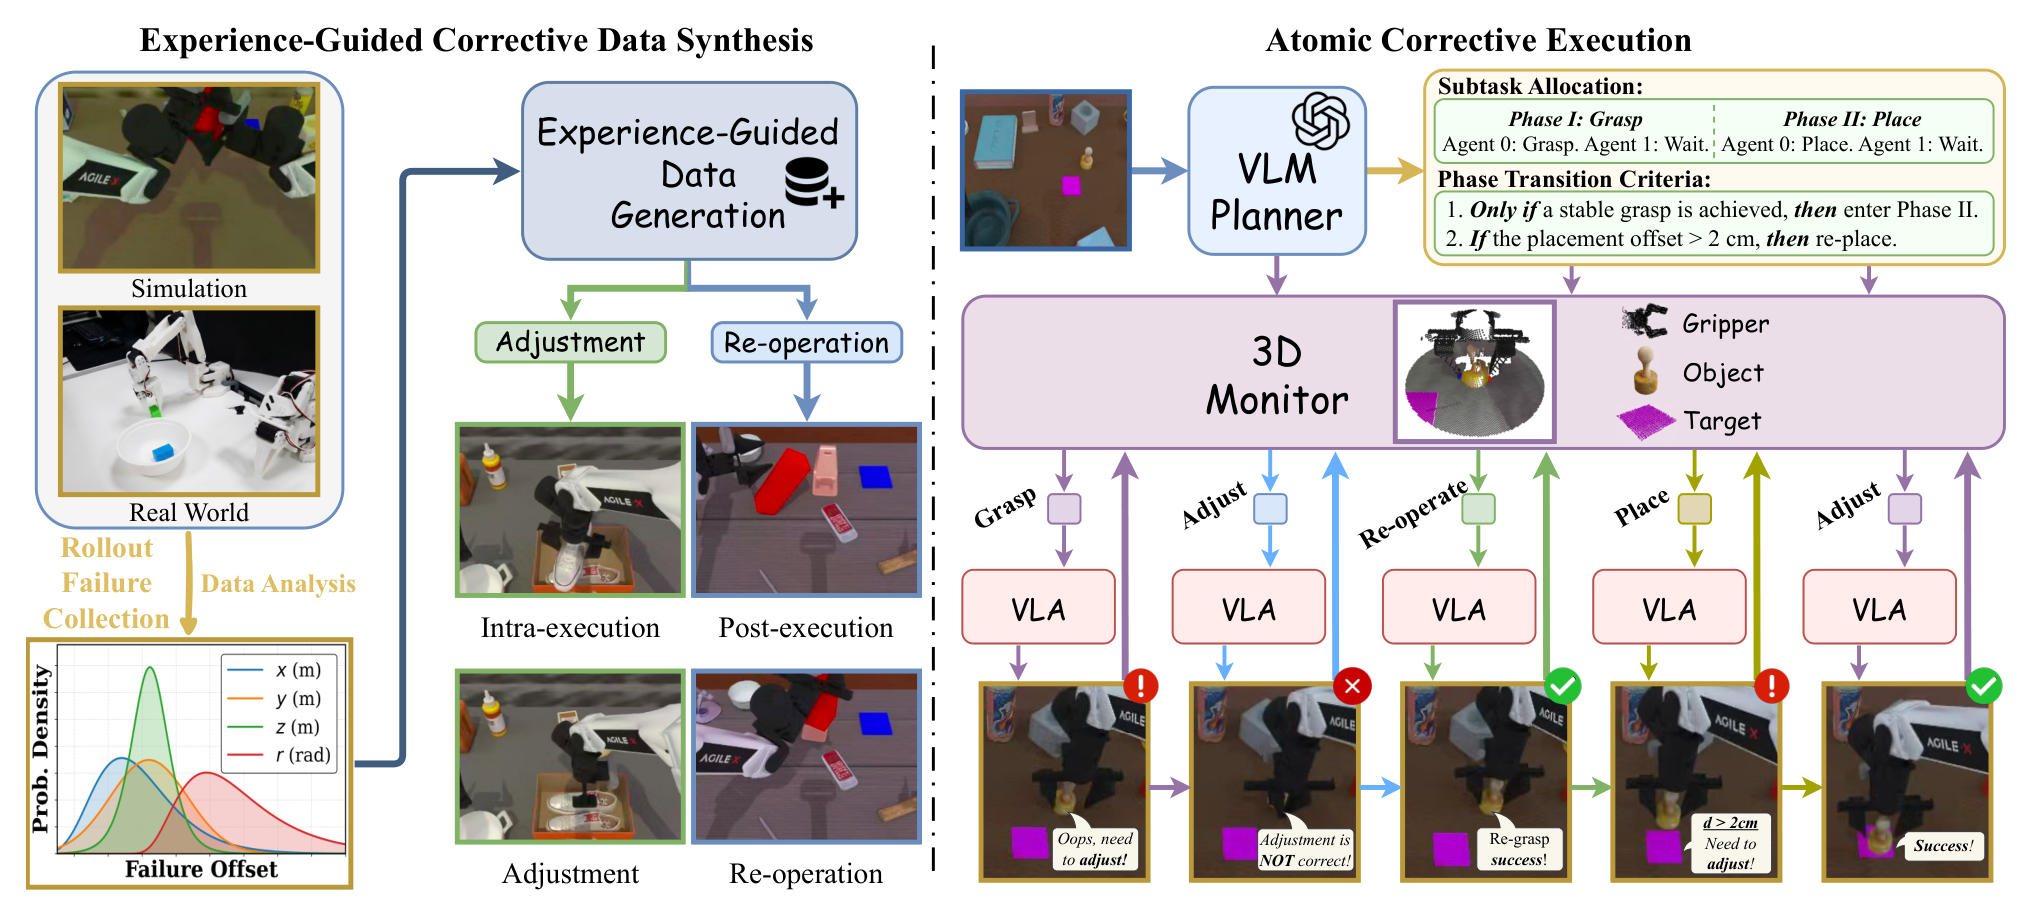
Figure 2 — CARE 전체 프레임워크
첫째, Experience-Guided Corrective Data Synthesis는 정책의 실패 경험을 corrective supervision으로 전환합니다. CARE는 nominal atomic plan을 실행하면서 발생하는 실패 롤아웃(failed rollouts)을 수집하고, 각 atomic stage에서 발생하는 translational 및 rotational deviation과 같은 stage-conditioned geometric deviation을 모델링합니다. 이 empirical failure distribution을 활용하여 실제와 유사한 failure state를 합성하고, 해당 상태에서 필요한 corrective demonstration을 수집합니다. 이 과정에서 Gaussian, Beta, Gamma, Weibull, Log-Normal, Uniform 등 다양한 후보 분포를 AIC 및 KS test를 통해 최적 피팅하여 실제 발생 가능한 failure mode를 효과적으로 반영합니다.
둘째, Atomic Corrective Execution Framework는 VLM Planner와 3D Geometric Monitor를 결합하여 corrective behavior를 언제, 어떻게 실행할지 결정합니다. VLM Planner는 상위 레벨의 지시(high-level instruction)를 여러 atomic stage로 분해하고, 각 stage에 대한 nominal instruction, recovery 관련 geometric cues, stage termination predicate, 그리고 intra-execution adjustment 및 post-execution re-operation을 위한 corrective instruction들을 정의합니다. 3D Geometric Monitor는 SAM 3와 Depth Anything 3를 활용하여 생성된 point cloud 기반으로 gripper-object misalignment, object-target displacement와 같은 stage-relevant geometric condition을 실시간으로 추적합니다 [Figure 5]. 편차가 감지되면, monitor는 local correction을 위한 intra-execution adjustment 또는 atomic stage의 반복을 위한 post-execution re-operation을 트리거합니다. 동일한 VLA Executor가 nominal 및 corrective instruction을 모두 처리하므로, 별도의 recovery policy로 전환할 필요 없이 seamless한 recovery를 가능하게 합니다.
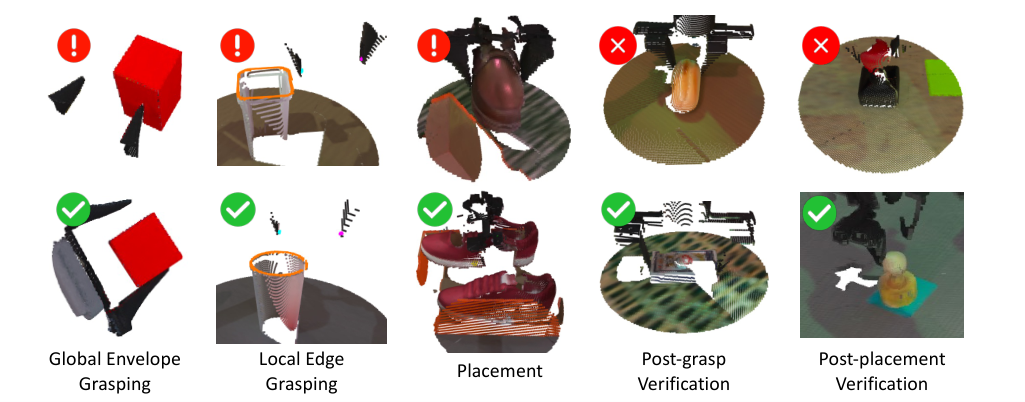
Figure 5 — 3D Geometric Monitor 시각화
저자들은 중간 실패 상태로부터의 recovery를 평가하기 위해 Failure State Recovery Benchmark (FSR-Bench)를 도입했습니다 [Figure 3]. FSR-Bench는 local deviation을 포함하는 "Easy" 시나리오와 multi-step correction 또는 multi-arm coordination이 필요한 "Hard" 시나리오로 구성되며, recovery 성공률(Recovery Success Rate, RSR)을 독자적으로 평가합니다.
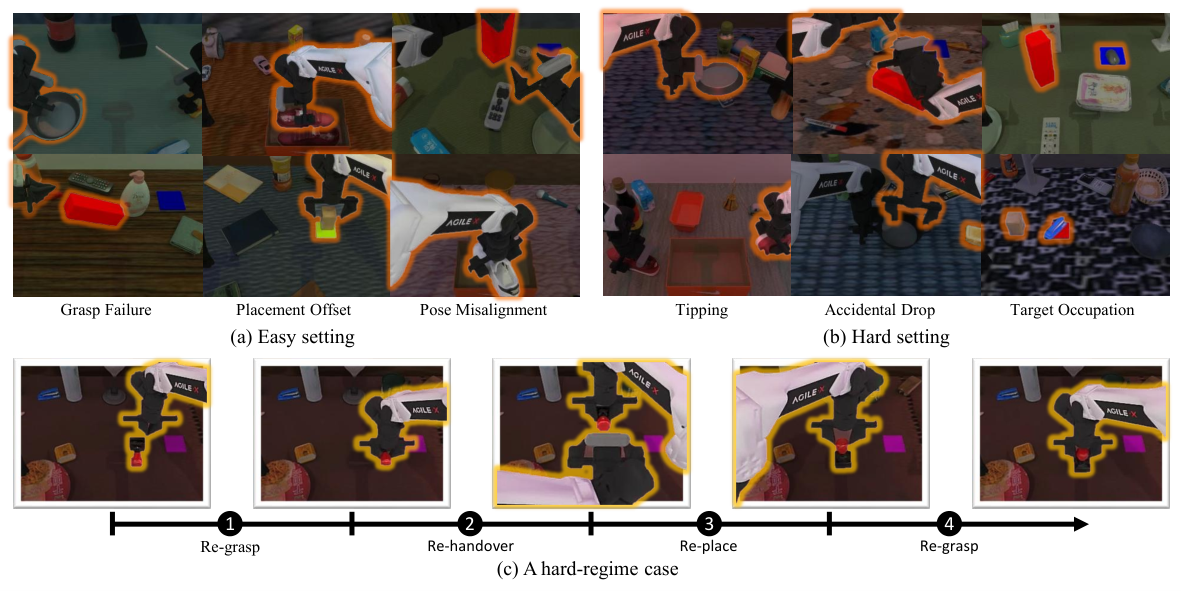
Figure 3 — FSR-Bench 시나리오 예시
실험 결과, CARE는 다양한 VLA backbone (π0, π0-FAST)과 벤치마크에서 일관된 성능 향상을 보였습니다. 시뮬레이션 환경(RoboTwin 2.0, RoboFactory)에서 CARE는 평균 14.5 points의 task-success rate 향상을 달성했으며, 특히 π0 backbone에서는 RoboTwin 2.0에서 평균 성공률이 39.6%에서 60.7%로 21.1 points 증가했습니다. FSR-Bench에서는 CARE가 평균 7.5 points의 RSR 향상을 기록했으며, π0 backbone은 Easy regime에서 38.8%에서 57.2%로, Hard regime에서 15.8%에서 21.2%로 RSR이 개선되었습니다. 실제 환경(real-world dual-arm SO-101 platform)에서는 CARE가 평균 15.9 points의 task-success gain을 보이며, 기존 FailSafe baseline 대비 13.7 points 더 높은 성능을 달성했습니다.
Ablation Study 결과, Experience-Guided Corrective Data Synthesis는 Uniform Random sampling 대비 π0 (CARE)에서 12.2 points, π0-FAST (CARE)에서 8.8 points의 평균 성공률 향상을 보이며, 실제 실패 분포를 따르는 것이 중요함을 입증했습니다. 또한, 3D Geometric Monitor는 VLM-based monitor 대비 평균 정확도 93.8% (vs. 71.4%) 및 latency 0.24s (vs. 3.40s)를 달성하여 더 정확하고 효율적인 모니터링 기능을 제공했습니다.
4. Conclusion & Impact
본 논문은 Vision-Language-Action (VLA) Policies의 실패 Recovery 능력을 획기적으로 향상시키는 CARE 프레임워크를 성공적으로 제안했습니다. CARE는 Experience-Guided Corrective Data Synthesis를 통해 실제 실행 실패를 구조화된 supervision으로 활용하고, 3D-monitor-driven Atomic Corrective Execution을 통해 적시에 효과적인 corrective behavior를 유발합니다. 또한, Recovery 능력을 전문적으로 평가하기 위한 FSR-Bench를 도입하여 해당 분야의 평가 프로토콜을 발전시켰습니다.
CARE는 시뮬레이션, Recovery-specific 벤치마크, 그리고 real-world 환경에서 다양한 VLA backbone에 걸쳐 일관된 Recovery 및 Robustness 향상을 입증했습니다. 이는 로버스트한 embodied intelligence가 강력한 nominal execution뿐만 아니라, 실패로부터 효과적이고 grounding된 Recovery 능력 또한 요구한다는 중요한 시사점을 제공합니다. 본 연구는 미래 로봇 시스템이 복잡하고 예측 불가능한 환경에서도 더욱 신뢰성 있게 작동할 수 있는 기반을 마련하며, 차후 reinforcement learning을 CARE에 통합하여 Recovery 능력을 더욱 강화할 계획을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DreamX-Phi 1.0: Action-Conditioned Video World Model for Robotic Manipulation
- [논문리뷰] RoboFollow: Unveiling the Instruction Following Mirage in Embodied Agents
- [논문리뷰] Attention-DP3: Spatially Object-aware 3D Diffusion Policy via Geometry-aligned Attentional Conditioning
- [논문리뷰] Agent as Policy for Robotic Manipulation
- [논문리뷰] Memory as Plans: World-Action Modeling with Memory-Grounded Planning
Review 의 다른글
- 이전글 [논문리뷰] A Lie Detector Test for Language Models: Reading Knowledge a Model Won't Reveal
- 현재글 : [논문리뷰] CARE: Experience-Guided Atomic Corrective Execution for Vision-Language-Action Policies
- 다음글 [논문리뷰] Complex KDA: Understanding and Enhancing the Expressivity of Kimi Delta Attention
댓글