[논문리뷰] Learning Heterogeneous Tactile Representation for General Dexterous Manipulation
링크: 논문 PDF로 바로 열기
저자: Bing Han, Yichuan Peng, Haoyu Dong, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- LingBot-Touch: piezoresistive, magnetic, visuotactile 센서를 하나의 encoder로 처리하는 tactile foundation model입니다. 모델 크기는 Tiny(5.46M)와 Small(21.76M) 두 가지입니다.
- Canonical Fingertip Space: 각 센서의 taxel 좌표를 unit-radius reference geometry 기반의 공통 finger-local 좌표계로 정렬한 공간입니다. 이 공간에서 각 token은 5D address (t, f, p)를 받습니다. t는 시간, f는 finger identity, p는 3D 위치입니다.
- Haptic Transformer (HaT): 모든 센서가 공유하는 Transformer backbone입니다. 위치 정보는 sensor-specific positional table 없이 5D RoPE로만 주입되므로, 서로 다른 taxel layout을 처리할 수 있습니다.
- Tactile-JEPA: masked taxel의 representation을 signal space가 아닌 latent space에서 예측하는 self-supervised objective입니다. EMA target encoder, multi-level target, mask warm-up(40%→80%)을 사용합니다.
- Layout-Agnostic Augmentation: layout을 nuisance variable로 취급하는 augmentation입니다. multi-density resampling과, 인접 taxel 간격의 0.5배 이내로 제한된 taxel position perturbation을 적용합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문의 핵심 문제는 tactile data가 이를 생성한 센서의 물리(sensor-specific physics)에 종속되어 있어, 이종 센서 데이터를 하나의 representation으로 학습·활용할 수 없다는 점입니다. 이로 인해 tactile 분야에는 vision과 language를 scaling 가능하게 만든 세 가지 요소가 모두 결여되어 있습니다.
- 공통 input format 부재: channel 구성, layout, resolution, sampling rate가 센서마다 다릅니다.
- 대규모 corpus 부재: 센서 간 데이터를 pooling할 수 없습니다.
- 표준 recipe 부재: 연구들이 특정 센서와 개별 task에 흩어져 있습니다.
기존 연구들은 대부분 optical 센서에 국한되거나, 새 하드웨어마다 sensor-specific encoder/adapter를 요구합니다(Sparsh, T3, AnyTouch, HTT, FTP-1). 저자들은 접촉(contact) 자체는 센서와 무관한 사건이므로, sensor physics를 제거하면 representation을 공유할 수 있다고 봅니다. 또한 tactile signal은 대부분 0에 가까운 sparse signal이고 label이 없기 때문에, signal reconstruction보다 latent prediction이 적합하다고 주장합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
LingBot-Touch는 canonical fingertip space, modality-specific tokenizer, 공유 HaT, Tactile-JEPA를 결합한 구조입니다 [Figure 1].
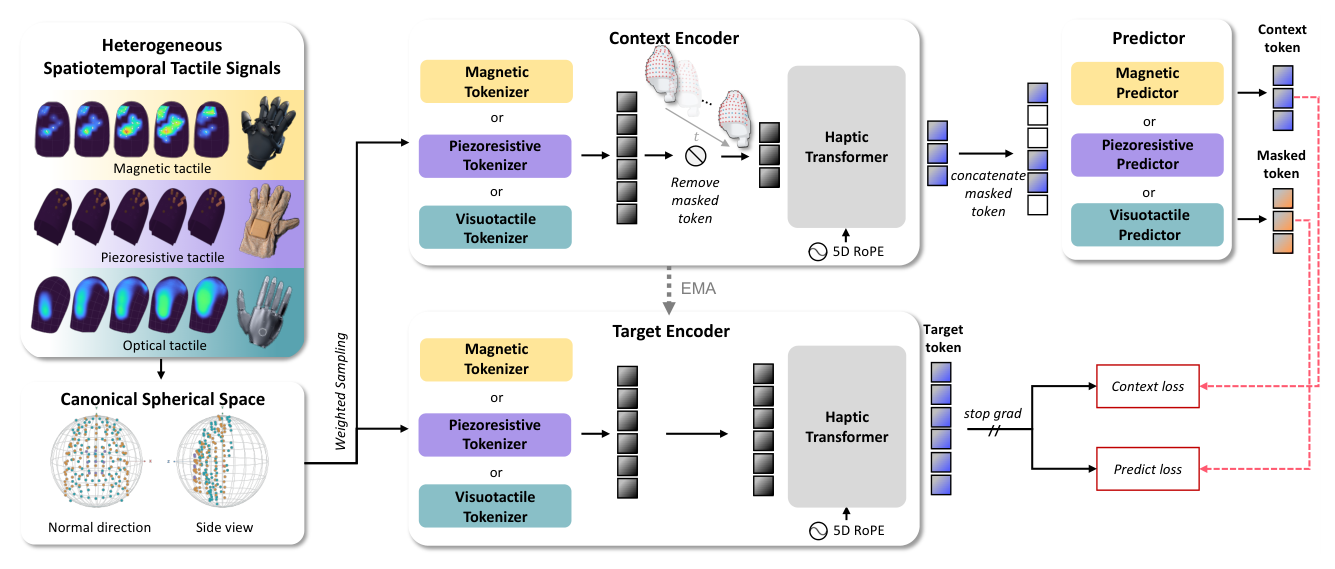
Figure 1 — 전체 아키텍처와 Tactile-JEPA 학습 구조를 보여주는 핵심 다이어그램
데이터와 학습 구조
- Corpus: human tactile glove(piezoresistive, magnetic)와 Sharpa Wave teleoperation(visuotactile)에서 수집한 4,983시간, 464K episodes, 1.33B frames 규모이며, 24개 task category를 포함합니다.
- Tokenizer: 2-layer MLP가 한 taxel의 연속 2 frame(6개 값)을 하나의 token으로 embedding합니다. sensor-specific parameter는 이 얕은 tokenizer와 predictor projection에만 존재합니다.
- Masking: 동일한 spatial mask를 clip 전체 시간 축에 확장해, masked taxel을 다른 time step에서 copy하는 shortcut을 차단합니다.
- Loss: masked 위치에 대한 prediction loss와 visible 위치에 대한 context loss(λ=0.5)를 L1으로 결합합니다.
- Mask warm-up: sparse signal에서는 접촉 정보가 모두 가려지는 경우가 생겨 gradient explosion이 발생합니다. 이를 막기 위해 처음 300 step 동안 masking ratio를 40%에서 80%로 선형 증가시킵니다.
Probing 결과 (frozen encoder + attentive probe)
- Sharpa Wave (pretraining에서 본 센서): FTP-1 대비 다음과 같이 개선되었습니다.
| Task | FTP-1 | LingBot-Touch |
|---|---|---|
| force error | 2.31 N | 0.81 N |
| contact center error | 2.19 mm | 0.12 mm |
| retrieval top-5 recall | 16.5% | 72.6% |
- XHand1 (pretraining에서 보지 못한 magnetic 센서): parameter update 없이 1.32 N / 0.16 mm / 47.1%를 기록했습니다. XHand1 전용 adapter를 학습시킨 FTP-1은 3.72 N / 5.89 mm / 6.0%에 그쳤습니다.
- Data scaling: Small 모델은 1K→5K시간 구간에서 모든 task가 단조 개선되거나 유지됩니다. Tiny 모델은 약 4K시간에서 포화됩니다.
- Multi-source 효과: 다른 센서의 데이터를 추가하면 8개 sensor-task pair 중 7개가 개선됩니다. 반면 동일한 총 data budget에서는 spatial precision 측면에서 single-source 모델이 유리합니다.
- Objective 비교: VAE와 MAE 대비 latent prediction이 모든 task에서 best 또는 tied-best입니다. VAE는 데이터가 늘수록 오히려 성능이 저하되었습니다(center error 3.03→4.08 mm).
Real-robot 결과 (26 tasks) [Table 2]
- frozen Tiny encoder를 추가했을 때 각 policy의 평균 success rate는 다음과 같습니다.
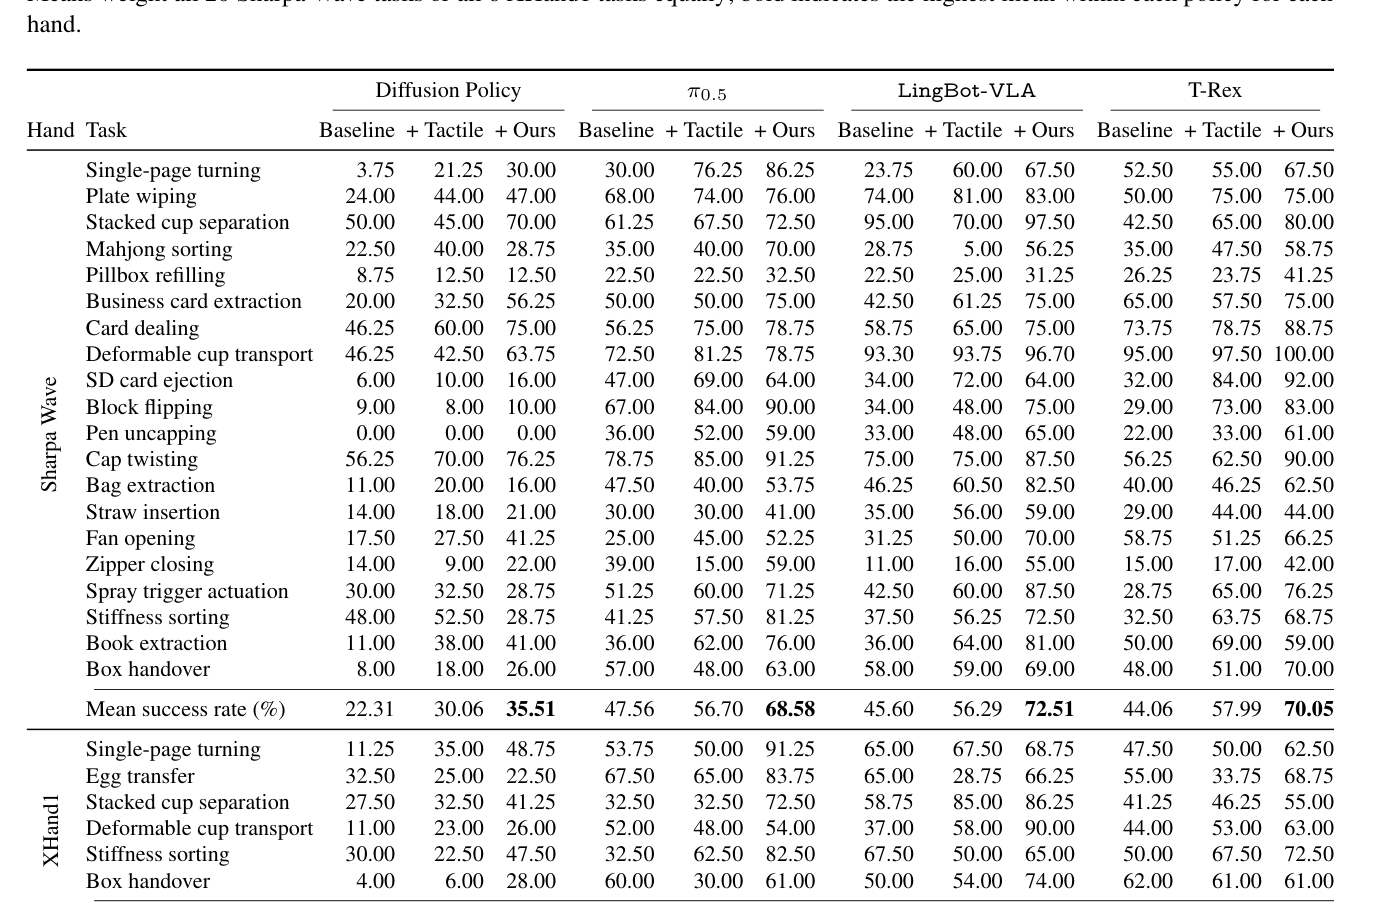
Table 2 — 26개 real-world task에서 baseline, raw tactile, LingBot-Touch 비교 핵심 결과
| Policy | Baseline | + LingBot-Touch | Gain |
|---|---|---|---|
| Diffusion Policy | 21.6% | 35.6% | +13.9pp |
| π0.5 | 48.1% | 69.9% | +21.8pp |
| LingBot-VLA | 48.3% | 73.1% | +24.8pp |
| T-Rex | 45.4% | 68.6% | +23.2pp |
- 추가 parameter는 policy 대비 0.13~0.16%에 불과합니다.
- raw tactile signal을 직접 추가하면 개선폭이 최대 약 절반에 그치고, 104개 task-policy pair 중 22개에서는 오히려 성능이 떨어졌습니다.
- XHand1에서 raw signal은 사실상 효과가 없었던 반면(−1.7~+4.6pp), LingBot-Touch는 +13.8~24.5pp를 더했습니다.
Simulation RL 결과 (12 tasks, PPO, 3 seeds)
- 평균 success rate는 LingBot-Touch 69.0%, Tactile CNN 45.6%, raw signal 38.5%, no touch 21.4%였습니다.
- seed 간 standard deviation도 평균 3.9로 매우 낮았습니다.
4. Conclusion & Impact (결론 및 시사점)
LingBot-Touch는 transducer가 아니라 contact 자체를 표현하는 tactile representation을 학습하며, 이는 unseen 센서로의 zero-adaptation transfer와 policy 성능 향상으로 입증되었습니다. 핵심 발견은 세 가지입니다.
- policy 성능 향상은 tactile modality를 추가했다는 사실이 아니라 pretrained representation에서 비롯됩니다.
- intensity와 dynamics 정보는 센서 간에 transfer됩니다.
- latent prediction은 signal reconstruction과 달리 데이터 규모에 따라 scaling됩니다.
이 결과는 tactile data scaling 전략에 실질적인 시사점을 줍니다. 가장 고성능인 센서보다 수집이 쉬운 센서(예: 하루 종일 착용 가능한 glove)로 데이터를 모으고, 실제로는 다른 hand에 배포하는 방식이 가능하다는 것입니다. 또한 plug-and-play tactile token으로서 VLA 등 기존 policy에 최소한의 비용으로 통합할 수 있어 산업적 활용도가 높습니다.
한계점도 명시되어 있습니다. 실험에 사용된 hand embodiment의 다양성이 제한적이고, capacitive 센서가 포함되지 않았으며, palm 등 fingertip 외 영역을 다루지 못합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] LCM-Promo: An LLM-Based Uplift Model for Promotion Allocation
- 현재글 : [논문리뷰] Learning Heterogeneous Tactile Representation for General Dexterous Manipulation
- 다음글 [논문리뷰] Longtail-SWE: High-Quality SWE Tasks for Underrepresented Languages
댓글