[논문리뷰] The Surprising Effectiveness of Deleting Weights in LLM Post-Training
링크: 논문 PDF로 바로 열기
저자: Jack Lu, Zhenbang Yang, Mike Lasby, Tejas Pote, Yani Ioannou, Mengye Ren (Jack Lu와 Zhenbang Yang은 Equal contribution)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Deletion Tuning: 이 논문이 제안한 post-training 방법입니다. pretrained weight는 그대로 freeze하고, transformer block의 gate projection weight마다 trainable logit을 하나씩 둡니다. 학습하는 것은 "어떤 weight를 0으로 지울지"를 정하는 binary mask뿐입니다. 새로운 값은 전혀 쓰지 않으며, 일종의 learned unstructured pruning이라고 볼 수 있습니다.
- Soft mask / Hard mask & Mask Sharpening: 학습 중에는 soft mask σ(α(t)·G)로 gradient를 흘리고, deployment 시에는 hard mask 1[G>0]를 적용합니다. 학습이 진행되면서 sharpness α를 10³ → 10⁴로 선형 증가시켜 sigmoid를 step function에 가깝게 만드는데, 이를 mask sharpening이라고 부릅니다.
- Wanda prior initialization: logit G를 Wanda pruning score(weight magnitude × input activation norm)로 초기화합니다. 기본값 η=1/2048에서는 초기 hard mask 기준으로 gate-projection weight의 약 0.18%가 0이 됩니다.
- Forward KL (forgetting predictor): 새 task에서 fine-tuned policy와 base policy 사이의 forward KL입니다. 선행 연구(Shenfeld et al.)에 따르면 이 값이 forgetting 정도를 예측합니다.
- Update geometry metrics: weight update ΔW의 기하학적 특성을 보는 세 가지 지표입니다.
- Stable rank: update가 몇 개의 direction을 쓰는지 나타냅니다.
- Spectrum drift: singular value가 얼마나 이동했는지 나타냅니다.
- Principal-weight overlap: 변경된 위치 중 rank-128 근사의 top-50% weight에 속하는 비율입니다. 무작위로 분포하면 0.5가 기준값입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 질문은 "pretrained LLM이 어떤 weight를 0으로 만들지만 학습해서 새로운 capability를 얻을 수 있는가?"입니다. 기존 방법은 모두 weight에 새 값을 씁니다. FFT는 모든 parameter를 수정하고, LoRA는 low-rank float update를, MTH·SHiRA는 선택된 위치에 float delta를 학습합니다. 반면 기존의 weight deletion(Wanda, SparseGPT 같은 pruning)은 이미 학습된 능력을 보존하면서 inference를 효율화하는 데에만 쓰였습니다. 최근 연구에서 RL fine-tuning이 일부 subnetwork만 바꾸고(530% parameter), task expert가 pretrained weight 주변에 조밀하게 분포한다는 사실이 밝혀졌습니다. 저자들은 이 관찰을 극단까지 밀어붙여, deletion만으로 post-training이 가능한지 검증하고자 합니다. 기존 baseline에는 실용적 한계도 있습니다. FFT checkpoint는 수 GB수백 GB에 달해 저장 비용이 크고, FFT·LoRA·random sparse fine-tuning은 모두 prior-task 성능을 잃는 catastrophic forgetting 문제를 안고 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
Deletion Tuning은 pretrained weight W를 freeze하고, 같은 shape의 logit matrix G만 학습합니다 [Figure 1].
- 학습 시: W̃ = W ⊙ σ(α(t)G) 형태의 soft mask로 forward/backward를 수행합니다.
- 평가·rollout 시: hard mask W ⊙ 1[G>0]를 사용합니다. 학습이 끝난 시점에 두 mask의 accuracy 차이는 최대 0.08 point입니다.
- 적용 위치: SwiGLU MLP에서 intermediate channel을 곱셈으로 제어하는 gate projection만 masking합니다.
- Objective: 각 regime의 loss(GRPO, SFT, SDFT)에 MaskLLM의 sparse weight regularizer(λ=10⁻⁵, SDFT에서는 0)를 더합니다. sparsity level은 고정하지 않고 학습이 스스로 정하도록 둡니다.
- 저장 방식: 결과 mask를 bit-pack한 뒤 zstd로 압축하므로, adapter 크기는 weight당 약 0.03 bits에 불과합니다.
- 평가 범위: Llama와 Qwen 두 model family, 0.5B~30B의 8개 backbone에서 FFT, LoRA(r=1, 4), MTH(99%, 99.95%)와 비교했습니다.
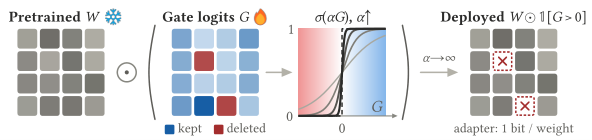
Figure 1 — Deletion Tuning 개요
주요 결과:
-
GRPO에서 FFT와 동등: 모든 run에서 전체 weight의 0.05% 미만만 삭제했는데도 FFT와 비슷하거나 약간 높은 성능을 보였습니다.
Backbone (Task) Deletion Tuning FFT Llama8B (GSM8K) 83.55% 83.24% Qwen7B (SimpleRL-Zoo) 52.32% 51.89% Qwen14B 55.43% 54.87% Qwen3-30B-A3B (MoE) 58.54% 58.43% 작은 모델에서는 FFT accuracy의 90~99%를 회복하며, 모델이 커질수록 gap이 줄어듭니다.
-
Adapter 크기: Qwen0.5B에서 0.5 MB, Llama8B에서 8.4 MB로, FFT checkpoint보다 3,600~4,700× 작고 비교한 모든 adapter 중 가장 작습니다.
-
새 capability 획득: pass@k 평가에서 k=128에서도 base 모델보다 높았습니다(Llama8B +4.3, Qwen7B +6.1 point). 즉 base 모델이 128번 시도해도 풀지 못한 문제를 풉니다.
-
Mask 학습이 핵심: Wanda one-shot pruning을 8개 sparsity level에서 시도해 가장 좋은 결과를 골라도 base 대비 2.4 point 이내에 머물렀습니다. 같은 Wanda score에서 출발한 Deletion Tuning은 최대 +53.2 point를 얻었습니다. 성능 향상은 초기화가 아니라 학습된 mask에서 나온다는 뜻입니다.
-
Forgetting이 적음:
- Deletion Tuning: forward KL이 ≤0.05로 유지되고, prior-task accuracy(HellaSwag, MMLU, TruthfulQA, WinoGrande, IFEval, HumanEval 6개 benchmark 평균)가 학습 내내 base 대비 1 point 이내를 유지했습니다.
- FFT: forward KL이 1.0~1.5까지 올라가고, prior-task accuracy가 1.3~3.1 point 떨어졌습니다.
- LoRA/MTH: forward KL이 0.4~1.3까지 올라가고, prior-task accuracy가 최대 5.4 point 떨어졌습니다.
- MTH 99.95%는 Deletion Tuning과 비슷한 비율의 parameter를 수정합니다. 그런데도 forgetting이 크므로, retention의 원인은 수정된 weight 수가 적어서가 아니라 deletion이라는 방식 자체에 있는 것으로 보입니다.
-
Update geometry가 FFT와 가장 가까움:
지표 Deletion Tuning FFT LoRA MTH Stable rank 66~93 명시되지 않음 1~2 410~650 Spectrum drift FFT의 1.4× 이내 기준 r=1에서 최대 84× (Llama8B) 명시되지 않음 Principal-weight overlap 0.43~0.46 0.41~0.46 0.48~0.50 0.50 Deletion Tuning의 overlap은 FFT처럼 random 기준(0.5)보다 낮습니다. 이는 RLVR update의 특징과 일치합니다.
-
SFT / SDFT에서도 FFT와 동등:
- SFT, Llama3B: MMLU-Pro 22.28% vs FFT 21.19%, BBEH 11.39% vs 11.39%로 동등합니다. 단, Llama1B BBEH에서는 5.65% vs 8.35%로 뒤처졌습니다.
- SDFT, Qwen7B: ToolAlpaca 69.07% vs FFT 68.04%, Science 70.61% vs 71.20%입니다.
- 두 regime 모두 adapter가 FFT보다 600~4,700× 작습니다.
-
Hyperparameter robustness: η, learning rate, λ를 sweep했을 때 모든 설정이 best run 대비 Llama8B에서 1.6 point, Qwen7B에서 3.2 point 이내였습니다.
4. Conclusion & Impact (결론 및 시사점)
이 논문은 LLM post-training이 새 값을 쓰지 않고, 어떤 weight를 지울지 선택하는 것만으로도 FFT 수준의 성능을 낼 수 있음을 보였습니다. GRPO에서는 30B MoE까지, SDFT에서는 Qwen7B, SFT에서는 Llama3B에서 FFT와 동등했습니다. 결과 adapter는 rank-1 LoRA보다 작고 FFT checkpoint보다 수백~수천 배 작습니다. GRPO retention 실험에서는 baseline들과 달리 prior-task 성능을 거의 잃지 않았습니다.
산업계 시사점:
- task를 바꿀 때 작은 bitmask만 load해 base weight에 0을 scatter하면 되므로, multi-task serving과 adapter switching 비용을 크게 줄일 수 있습니다.
학계 시사점:
- forgetting이 적다는 점에서 continual learning의 유력한 후보가 됩니다.
- 이산적이고 작은 mask이므로 interpretability(task별로 어떤 weight가 삭제되는지 비교), mask union을 통한 skill merging, N:M structured mask를 통한 adaptation과 compression 동시 달성 같은 후속 연구로 이어질 수 있습니다.
한계:
- weight마다 logit을 하나씩 학습하므로 training memory가 FFT보다는 적지만 LoRA보다는 많이 듭니다.
- 작은 모델에서는 FFT와의 gap이 남아 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Dense Supervision, Sparse Updates: On the Sparsity and Geometry of On-Policy Distillation
- [논문리뷰] On the Geometry of On-Policy Distillation
- [논문리뷰] On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
- [논문리뷰] On the Direction of RLVR Updates for LLM Reasoning: Identification and Exploitation
- [논문리뷰] Drift-Constrained Optimization: Only Direction Matters in Fine-Tuning Instruct Models
Review 의 다른글
- 이전글 [논문리뷰] Test-Time Scaling for Diffusion Language Models with Frequency-Aware Remasking
- 현재글 : [논문리뷰] The Surprising Effectiveness of Deleting Weights in LLM Post-Training
- 다음글 [논문리뷰] TorchCurves: Differentiable Parametric Curves
댓글