[논문리뷰] TraceForge: Distilling with Your Own Thinking
링크: 논문 PDF로 바로 열기
저자: Yan Wang
1. Key Terms & Definitions
- Reasoning Trace: Large Language Model (LLM)이 최종 답변에 도달하기 전에 생성하는 상세한 단계별 사고 과정 또는 중간 단계들을 의미합니다.
- Family-Native Trace: 특정 모델 패밀리의 스타일로, 주어진 Context와 Teacher 모델의 최종 Answer를 기반으로 Student 모델 패밀리 내에서 자체적으로 생성된 Reasoning Trace를 지칭합니다.
- Generator: Context와 최종 Answer를 입력받아, 해당 모델 패밀리 고유의 Reasoning Trace를 재구성하도록 훈련된 모델입니다.
- Critic: 실제 (Authentic) Reasoning Trace와 생성된 (Synthesized) Reasoning Trace를 구별하도록 훈련된 모델입니다.
- Adversarial Co-training: Generator와 Critic이 서로 대립하며 훈련되는 두 단계 학습 프로세스로, Generator는 현실적인 Trace를 생성하고 Critic은 가짜 Trace를 식별하도록 목표합니다.
2. Motivation & Problem Statement
본 논문은 Frontier LLM들이 상세한 Reasoning Trace를 공개하지 않아 발생하는 문제인 "Moat"를 해결하고자 합니다. 현재 최신 LLM들은 Safety 및 Intellectual Property 문제로 인해 최종 Answer 또는 간략한 Summary만을 제공하며, 이는 효과적인 Knowledge Distillation에 필수적인 상세 Reasoning Trace의 접근을 제한합니다. 기존 연구들은 암호화된 Reasoning Block을 재사용하여 숨겨진 Reasoning을 복구하려 시도했으나, 이는 API Provider의 Terms of Service를 위반하여 장기적인 솔루션이 될 수 없습니다. 이러한 한계는 강력한 Proprietary 모델의 풍부한 Reasoning Pathway를 활용하여 더 작고 Open-Source 모델을 훈련시키는 것을 어렵게 하며, 필드의 발전을 저해합니다.
3. Method & Key Results
저자들은 Provider의 Terms of Service를 위반하지 않고 "Family-Native" Reasoning Trace를 생성하는 대안적인 방법인 TraceForge를 제안합니다. 제안된 방법론은 두 단계의 훈련 프로세스로 구성됩니다 [Figure 2]: 첫째, Generator 모델 (Student 모델과 동일한 패밀리, 예: Qwen)은 Context와 최종 Answer가 주어졌을 때 Family-Native Reasoning Trace를 재구성하도록 Supervised Training됩니다. 둘째, Generator와 Critic 간의 Adversarial Co-training이 진행됩니다. 여기서 Critic은 실제 Family Trace와 생성된 Trace를 구별하도록 학습하고, Generator는 Critic을 속일 수 있는 Trace를 생성하도록 추가 훈련됩니다.
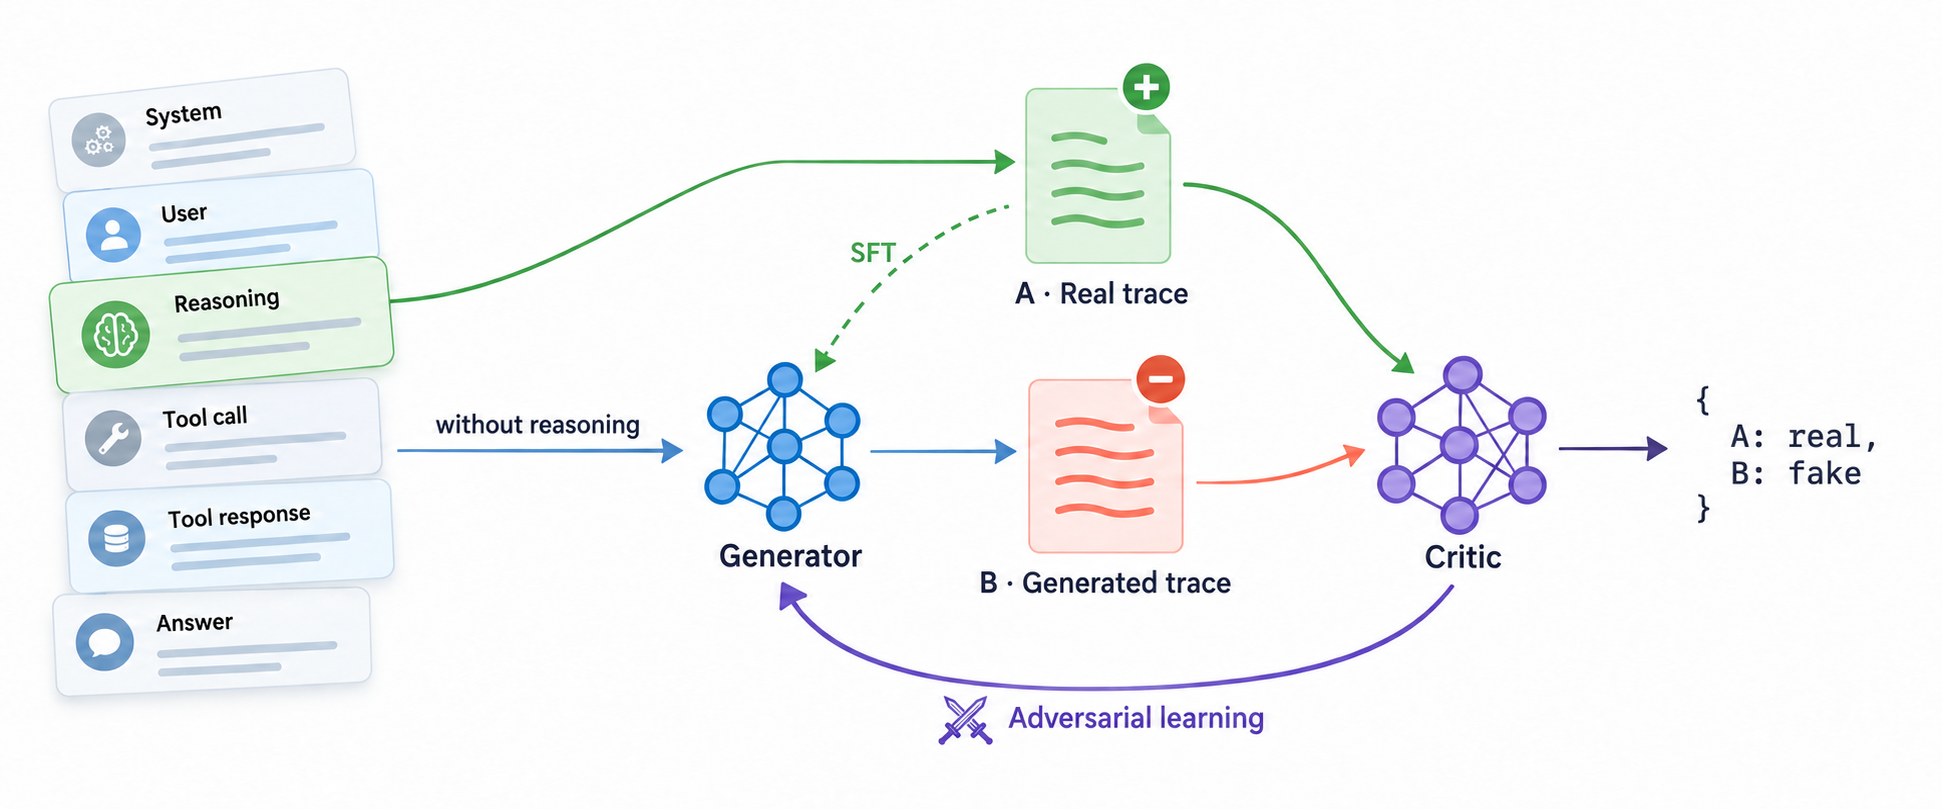
Figure 2 — 제안 방법론의 전체 파이프라인
평가 결과, 독립적인 Judge 모델인 GPT-6.1-SOL은 생성된 Family-Native Trace에 68%의 실제성 점수를 부여했으며, 이는 실제 Trace의 66%보다 높은 수치이고, Critic이 4개의 후보 중 최적의 Trace를 선택했을 때는 82%까지 향상되었습니다. 코드 벤치마크에서 Qwen3.5-9B-Base Student 모델을 Family-Native Trace (S2)와 Fable 5의 Answer로 훈련했을 때, Fable 5의 자체 Reasoning Trace (S1)로 훈련했을 때보다 최종 체크포인트에서 HumanEval+ pass@1이 3.7점 (64.63% → 68.29%), MBPP+ pass@1이 7.1점 (52.38% → 59.52%) 향상되었습니다. 또한, GPT-6.1-SOL의 Answer에 기반한 Family-Native Trace (S5)로 훈련된 모델은 HumanEval+에서 59.15%, MBPP+에서 60.05%를 달성하여, 동일한 데이터셋에서 TraceInversion 방법 (S4)의 3.66% 및 6.61%를 크게 능가했습니다. 이 방법은 Student 모델의 자체 패밀리 내에서 가장 강력한 모델(Qwen3.8-Max)의 Reasoning Trace로 직접 훈련하는 것(S3)보다 HumanEval+에서 21점, MBPP+에서 35점 더 높은 성능을 보였습니다. 이는 Family-Native Trace가 Knowledge 흡수 효율성을 높이고 Catastrophic Forgetting을 줄이는 데 기여함을 시사합니다.
4. Conclusion & Impact
본 논문은 TraceForge가 강력한 Proprietary LLM으로부터 Knowledge를 효과적으로 Distill하기 위한 합법적이고 효율적인 방법을 제공함을 입증합니다. 이 접근 방식은 Teacher Trace의 직접적인 복구와 관련된 법적 및 지적 재산권 문제를 회피할 뿐만 아니라, Teacher의 Original Trace나 Student 패밀리 내의 가장 강력한 모델을 사용하는 것보다 더 우수한 Student 모델을 생성합니다. 이 연구는 LLM 커뮤니티에 중요한 영향을 미치며, Open-Source 모델이 State-of-the-Art Closed-Source 모델로부터 명시적인 허가 없이도 더 효과적으로 학습할 수 있도록 합니다. 이는 Open-Source LLM의 발전을 가속화하고, 고품질 Reasoning Capability를 학술 연구 및 다양한 산업 응용 분야에 더 널리 제공함으로써 보다 공정하고 혁신적인 AI 생태계를 조성하는 데 기여할 수 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Code2Video: A Code-centric Paradigm for Educational Video Generation
- [논문리뷰] PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis
- [논문리뷰] SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
- [논문리뷰] AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
- [논문리뷰] Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
Review 의 다른글
- 이전글 [논문리뷰] ToM2Vec: Continuous Theory-of-Mind Tokens for Multi-Agent Coordination
- 현재글 : [논문리뷰] TraceForge: Distilling with Your Own Thinking
- 다음글 [논문리뷰] Which Agent's Skill Should Change? Group-Relative Credit Assignment for Evolving Multi-Agent Teams
댓글