[논문리뷰] Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds
링크: 논문 PDF로 바로 열기
저자: Xinjie Lin, Qingle Liu, Wenyi Li, et al. (Navers Lab, Einsia.AI, Tsinghua University)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Coding Agent: 이미지와 instruction을 이해하고 실행 가능한 프로그램을 작성·실행해 3D content를 만드는 agent입니다. 이 논문은 모델과 그 개발사의 agent harness를 묶은 model–harness configuration 단위로 평가합니다. 예를 들어 GPT 계열은 Codex, Claude는 Claude Code, Kimi는 Kimi CLI에서 실행됩니다.
- L1 / L2 / L3 Hierarchy: 만드는 단위에 따라 나눈 세 가지 construction level입니다.
- L1 (Objects): 단일 asset이나 mechanical assembly를 다루며 Blender를 사용합니다.
- L2 (Scenes): 여러 object로 이루어진 layout, lighting, composition을 다루며 Blender를 사용합니다.
- L3 (Open Worlds): 여러 functional region이 연결되고 상태가 유지되는 interactive world를 다루며 Unreal Engine을 사용합니다.
- Interaction Contract: L3 task에 포함되는 명세입니다. functional zone, entity, initial state, 사용 가능한 operation과 그 physical constraint, action prerequisite를 정의합니다.
- Reference Reconstruction vs. Text-driven Generation: 두 task 유형의 차이입니다. reference reconstruction은 주어진 이미지(multi-view, single-view, real photo)의 geometry, layout, 시각적 detail을 그대로 재현하는 task입니다. text-driven generation은 텍스트만 보고 그럴듯한 content를 만드는 task입니다.
- Interaction Correctness (H): L3 behavior를 평가하는 component로 세 sub-component로 구성됩니다.
- Local mechanism: 개별 장치가 작동하는지
- Motion clearance: 움직이는 부품이 막히지 않는지
- Stateful workflow: teleportation이나 reset 없이 activity 전체를 완수할 수 있는지
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 coding agent의 3D creation 능력을 objects, scenes, interactive worlds 전반에서 하나의 기준으로 측정할 benchmark가 없다는 문제를 해결하려 합니다. 기존 benchmark는 평가가 분절되어 있습니다.
- Object/scene authoring benchmark(예: BlenderWorld, Code4Scene)는 geometry, visual fidelity, editing에 집중합니다.
- Executable-world/game benchmark(예: ExeWorldBench)는 mechanical dependency와 gameplay completion에 집중합니다.
두 계열은 task scope와 evaluation protocol이 서로 달라 결과를 합쳐 agent 능력을 일관되게 설명하기 어렵습니다. 또한 aggregate score 하나만 보면 실패 원인을 구분할 수 없습니다. reference 재현에 실패했는지, scene 구성에 실패했는지, 요구된 behavior 구현에 실패했는지가 가려집니다. 저자들은 성공적인 3D creation에는 faithful appearance, coherent structure, functional behavior가 모두 필요하다고 보고, level별 전용 task와 visual·structural·behavioral check를 함께 쓰는 통합 benchmark가 필요하다고 주장합니다 [Figure 1].
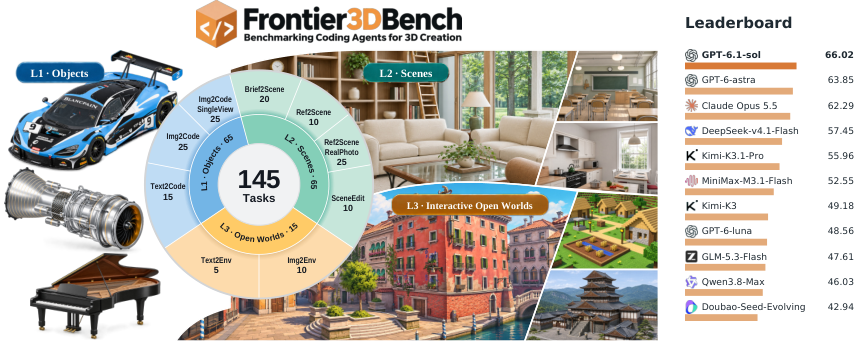
Figure 1 — 벤치마크 개요·순위
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 9개 category, 145개 task로 구성된 Frontier3DBench를 제안합니다.
Task 구성
- L1 (65개): Text2Code, Img2Code, Img2Code-SingleView
- L2 (65개): Brief2Scene, Ref2Scene, Ref2Scene-RealPhoto, SceneEdit
- L3 (15개): Text2Env, Img2Env
Task 정의 [Figure 2]
- 입력은 text instruction, optional reference image, starter code나 initial scene으로 구성되며
x = (d, I, a0)로 표기합니다. - agent는 이를 바탕으로 Blender 또는 Unreal Engine project file과 실행 가능한 code를 제출합니다.
- task instruction과 L3 environment specification은 GPT-6-astra로 확장해 작성했습니다.
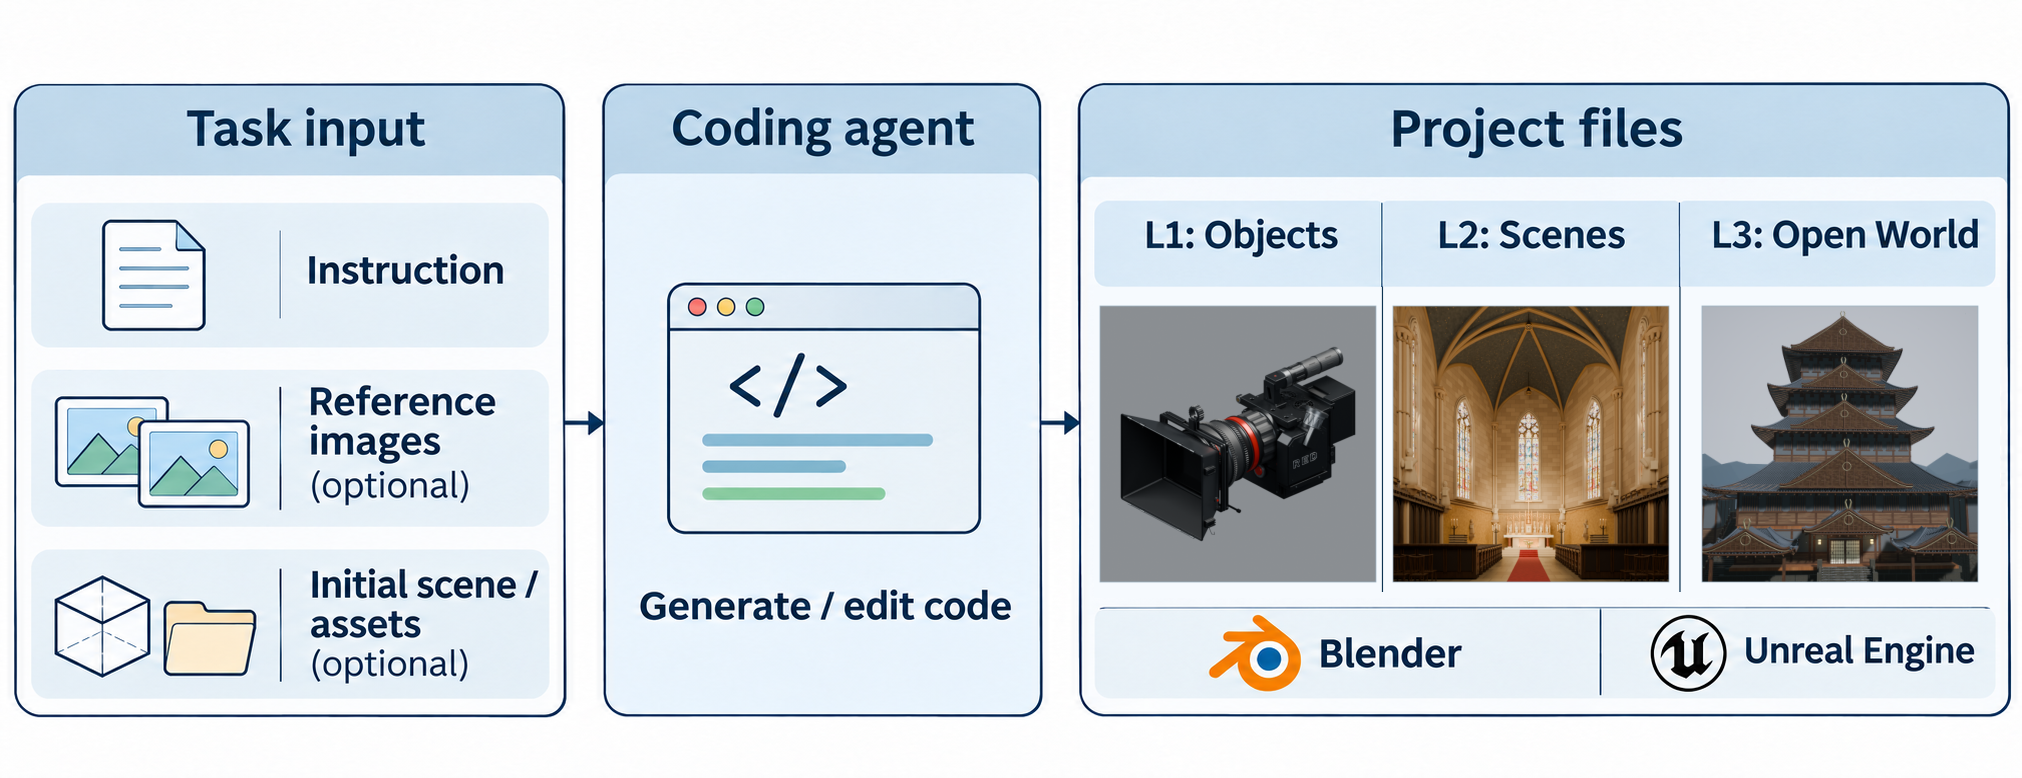
Figure 2 — Task 정의 구조
평가 방식
- L1/L2 component: visual fidelity (V), requirements (R), detail fidelity (D), image similarity (I), object localization (L), target modification (T), preservation (P)
- L3 component: visual quality (A), task fidelity (F), spatial layout (G), interaction correctness (H)
- visual judgment는 GPT-6-astra가 생성 모델이 누구인지 모르는 상태(identity hidden)에서 수행합니다.
- L3는 independent observer가 project를 다시 빌드한 뒤 character movement, action effect, state change를 runtime에서 테스트합니다.
- Overall score는 0.30·S_L1 + 0.30·S_L2 + 0.40·S_L3입니다.
핵심 결과
- Overall 1위: GPT-6.1-sol (Codex)이 66.02점을 받았습니다. level별로는 L1 71.21, L2 70.35, L3 58.89이며, 2위와의 격차는 2.17점입니다.
- Category별 1위는 모델마다 다릅니다.
- GPT-6-astra는 L3 평균 61.28로 open world 두 category를 모두 이끕니다.
- Claude Opus 5.5는 Text2Code에서 최고 점수 84.05를 기록했습니다.
- 모든 category에서 1위인 configuration은 없습니다.
- Reconstruction이 generation보다 어렵습니다. 모든 configuration이 object와 scene 모두에서 reference reconstruction 점수가 text-driven generation보다 낮습니다.
- Text2Code 점수 범위는 75.93–84.05입니다.
- 반면 multi-view 및 single-view reconstruction 최고점은 각각 69.61, 66.26에 그칩니다.
- Qwen3.8-Max는 Text2Code 81.98로 Sol의 82.10에 거의 근접하지만, reconstruction에서는 43.97 / 37.34로 떨어집니다.
- 개별 장치는 작동하지만 activity 전체 완수는 어렵습니다. 전체 165개 L3 submission 기준 H의 sub-component 평균은 다음과 같습니다.
- local mechanism: 83.08
- motion clearance: 20.82
- stateful workflow: 30.26
- Scene editing의 순위는 overall과 다릅니다. MiniMax-M3.1-Flash는 overall 6위지만 SceneEdit에서 78.70점으로 2위입니다.
- Cost efficiency [Figure 5]
- score–cost Pareto frontier는 Luna(48.56점, 약 $0.27/task), DeepSeek(57.45점, $0.45), Sol(66.02점, $1.01)로 구성됩니다.
- Opus는 $21.17/task로 Sol보다 훨씬 비싸지만 점수는 더 낮습니다.
- Human agreement: 8명의 rater가 360건을 판단한 결과, 자동 점수와의 mean Kendall τb = 0.727, top-one 일치율은 79.2%였습니다. 이는 human rater끼리의 일치도(0.679)와 같거나 더 높은 수준입니다.
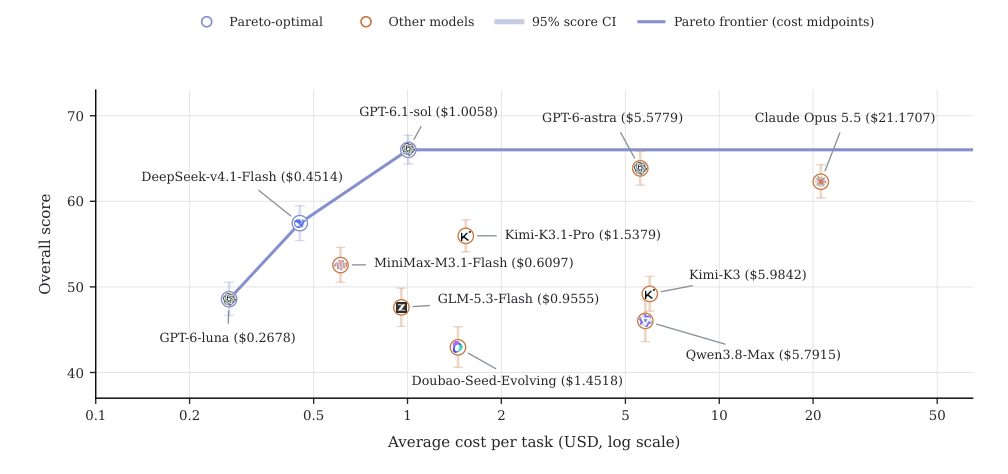
Figure 5 — 점수 대비 비용
4. Conclusion & Impact (결론 및 시사점)
이 논문의 결론은 현재 coding agent가 3D creation에서 겪는 핵심 병목이 두 가지라는 것입니다.
- Reference fidelity: 지정된 geometry와 layout을 정확히 재현하는 능력
- Coordinated activity completion: 움직이는 부품, action, persistent state를 조율해 activity 전체를 완수하는 능력
선두 모델은 level에 따라 바뀝니다. objects와 scenes에서는 GPT-6.1-sol, interactive worlds에서는 GPT-6-astra가 가장 높습니다. 그럴듯한 content를 만드는 것은 지정된 내용을 재현하는 것보다 쉽다는 경향은 모든 configuration에서 공통으로 나타났습니다.
학계 측면에서 Frontier3DBench는 지금까지 따로 평가되던 object, scene, world 수준의 능력을 하나의 protocol로 측정할 수 있게 합니다. 이를 통해 이후 연구가 reference fidelity와 stateful interaction을 개선하는 데 집중할 근거를 제공합니다. 산업 측면에서는 task별 profile과 cost 분석이 실제 3D content pipeline에 맞는 model–harness를 고르는 실용적 근거가 됩니다. 특히 비용을 더 쓴다고 성능이 항상 오르지는 않는다는 결과가 중요합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
- [논문리뷰] LEGO-Anything: Coding Agents for 3D Scene Reconstruction
- [논문리뷰] 3DCodeVerse: Exploring 3D Worlds as Code
- [논문리뷰] GameCraft-Bench: Can Agents Build Playable Games End-to-End in a Real Game Engine?
- [논문리뷰] 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
Review 의 다른글
- 이전글 [논문리뷰] Fast and Exact Relative-Position Attention via Structure-Aware Kernels
- 현재글 : [논문리뷰] Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds
- 다음글 [논문리뷰] Hierarchical Residuals: A Minimalist Decoupling of Residual Width from Compute Width
댓글