[논문리뷰] Continual-ARC: Measuring Skill Acquisition over a Working Lifetime
링크: 논문 PDF로 바로 열기
참고: 요청에는 저자가 Daniel Lenton, Yusha Arif, Haris Mahmood 세 명으로 되어 있습니다. 하지만 arXiv HTML 본문(v1)에 저자로 적힌 사람은 Daniel Lenton(unify) 한 명뿐입니다. Yusha Arif와 Haris Mahmood는 Acknowledgments에서 초기 작업과 초안 검토에 대한 감사 대상으로만 나옵니다. 아래 메타데이터는 논문 원문 기준으로 작성했습니다.
저자: Daniel Lenton (unify)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Continual-ARC: ARC-AGI 세 edition(ARC-AGI-1/2/3)으로 만든 lifelong stream benchmark입니다. 같은 task가 dormant gap을 거친 뒤 fresh instance로 다시 나오고, 새 task도 계속 추가됩니다.
- Feedback Budget (U): instance마다 demonstration 요청과 오답 제출에 각각 1의 비용이 듭니다. 실패하면 budget cap 전체인 C_max = 16이 부과되며, 사용한 budget 비율로 점수를 매깁니다.
- Share Learned (L): 매 instance 전에 state를 지우는 reset run과 비교합니다. learnable budget(Λ) 가운데 실제로 절약한 비율로, base capability를 정규화해 순수한 학습량만 측정합니다.
- S_seen / S_held: stream이 끝난 뒤 learner를 freeze하고 두 test를 실행해 reset 대비 절약한 비율입니다. 이미 만난 task의 새 instance에서 얻은 값(S_seen)은 memorization을, 처음 보는 evaluation task 100개에서 얻은 값(S_held)은 generalization을 나타냅니다.
- Collective Regime: 하나의 시스템이 2명 또는 4명의 user를 동시에 서비스하는 설정입니다. user마다 겹치지 않는 25개 task를 받고, 모든 user가 notes와 weights를 하나의 state로 공유합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 memory 기반 learner(agent harness)와 weight 기반 learner를 같은 척도로 비교할 수 있는 continual learning benchmark가 없다는 문제를 다룹니다. 저자는 기존 benchmark의 한계를 세 가지로 정리합니다.
- 단일 applied domain 의존: 대부분 coding이나 office work처럼 하나의 applied domain에 맞춰져 있습니다. 그래서 성능 향상이 실제 학습인지, pretraining 지식을 끌어낸 결과인지 구분하기 어렵습니다.
- instance 1회 노출: 각 instance를 한 번만 보여 주므로 같은 개념의 task가 새 input으로 돌아오지 않습니다. 그 결과 답을 외운 것인지, 추상적인 skill을 익힌 것인지 가려낼 수 없습니다.
- 단일 learner family 가정: fine-tuning suite는 gradient update만, agent benchmark는 prompting과 memory만 전제하는 경우가 대부분입니다.
원래 ARC는 single episode 안의 skill acquisition만 측정하고, 장기간에 걸친 유지와 전이는 묻지 않습니다. 저자가 검토한 약 200개 연구 가운데 다음 5가지 속성을 모두 갖춘 사례는 없었습니다.
- 노출될 때마다 fresh instance 제공
- 가변 gap 이후 task 재등장
- stream 동안 늘어나는 task set
- 비용이 부과되는 binary feedback
- 모든 learner 유형에 열린 protocol
3. Method & Key Results (제안 방법론 및 핵심 결과)
Benchmark 구성
- ARC-AGI-1 track은 Re-ARC generator로 training task 400개 중 25개를 뽑습니다. 이 25개 task에서 검증된 200개 instance를 stream으로 제공합니다 [Figure 2].
- 동시에 active한 task는 4개입니다. spell은 약 3 instance, rest는 약 30 instance이고, 새 task는 약 4 instance마다 하나씩 등장합니다.
- learner는 instance마다 demonstration 요청(최대 8회), 답안 제출(최대 8회 시도), harness 내부 action 중에서 선택합니다. task id와 input은 볼 수 있지만 stream 내 위치는 알 수 없습니다.
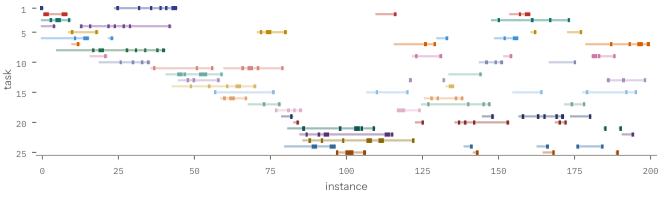
Figure 2 — ARC-AGI-1 stream 구조
비교 대상 learner (모델: Qwen3.5-9B, GLM-5.3 Flash, 추가로 GPT-6 Luna)
- Prompting floor: Stateless(C0)와 Demo-cache(C)
- Program library(P): Python program을 귀납적으로 만들고, demonstration으로 검증한 뒤 저장합니다.
- Agent harness: prime-agent를 주로 쓰고, GPT-6 Luna 실험에는 hermes-agent와 openclaw도 포함했습니다.
- Teacher-written notes(T): GLM이 notes를 작성해 Qwen에 제공합니다.
- DAgger(QDE): Qwen의 LoRA adapter를 GLM teacher를 imitate하도록 학습합니다.
핵심 결과 [Figure 3]
- Baseline: Demo-cache는 S_seen = 0.37 / 0.44(Qwen/GLM)를 기록했습니다. Program library는 0.65 / 0.81로 크게 앞섰지만, S_held는 두 방법 모두 측정 가능한 수준의 절약이 없었습니다.
- Shipped harness: harness 자체 prompting만으로는 어떤 harness도 demo-cache floor를 넘지 못했습니다. Qwen의 persistence 효과는 S_seen = −0.01로 사실상 0이었습니다. GLM의 prime-agent는 task마다 규칙을 저장했지만, harness가 instance마다 entry를 6개만 보여 주는 탓에 그 규칙이 실제로 전달된 것은 return 154회 중 40회에 그쳤습니다.
- Expert guidance: program을 작성·검증·저장·재사용하라고 명시적으로 지시하자 GE의 S_seen이 0.74로 올랐습니다. GPT-6 Luna 위의 세 harness도 0.62–0.72를 기록했습니다 [Figure 5]. 반면 Qwen은 teacher가 notes를 쓰고 teacher와 student 모두 guidance를 받은 경우(QETE)에만 S_seen = 0.34를 달성했습니다.
- Generalization: harness 기반 방법 중 S_held에서 유의미한 개선을 보인 것은 하나도 없었습니다. 반대로 DAgger(QDE)는 S_held = 0.29, S_seen = 0.57을 기록했습니다. held-out task 해결 수도 47–52개로, untrained Qwen(Q0) 18개와 stateless loop(QC0) 31개를 모두 넘었습니다.
- Collective regime: user가 늘수록 DAgger의 S_held는 0.40(2 users), 0.39(4 users)였습니다. 2 users를 넘어서면 diminishing returns가 나타났습니다.
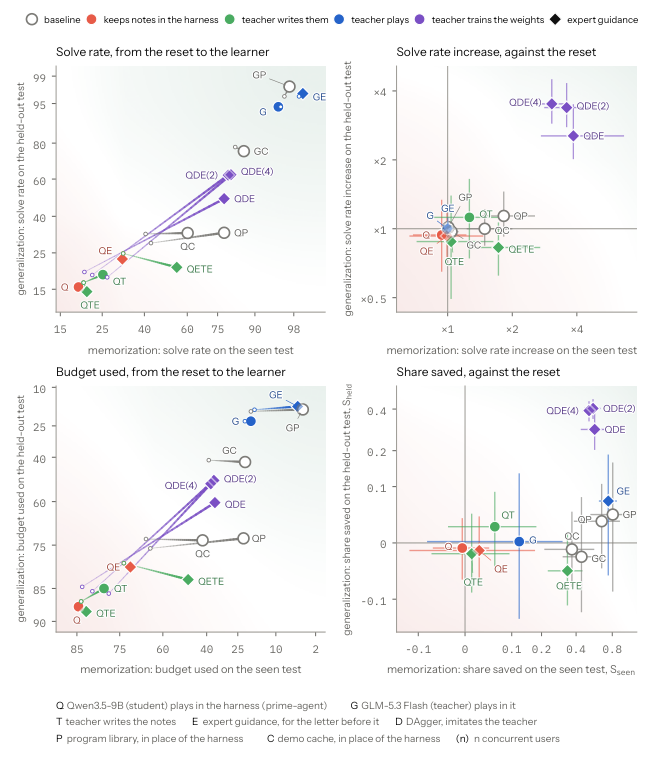
Figure 3 — Seen/held-out 결과
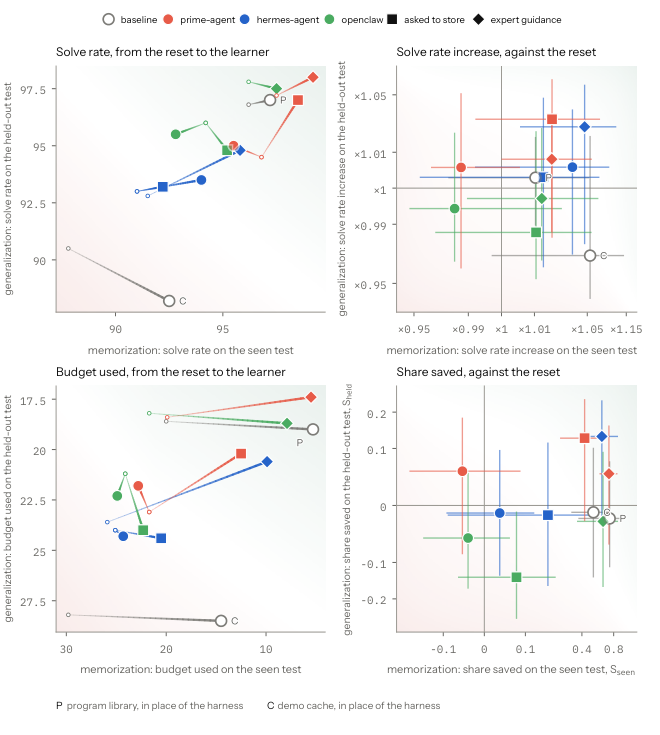
Figure 5 — GPT-6 Luna 결과
4. Conclusion & Impact (결론 및 시사점)
이 논문은 Continual-ARC를 통해 두 가지를 보여 줍니다. 기본 설정 그대로 배포된(off-the-shelf) agent harness는 domain 지식이 필요 없는 영역에서 거의 학습하지 못합니다. 반면 weight 기반 학습은 처음 보는 task로 실제 generalization을 이끌어 냅니다. harness의 실패는 능력이 부족해서가 아니었습니다. 무엇을 저장해야 하는지 판단하지 못한 model과, 이를 유도하지 못한 default harness prompt가 함께 원인이었습니다. 이는 expert guidance를 주자 memorization이 크게 개선된 결과로 확인됩니다.
시사점
- 저자는 장기적으로 harness가 시스템 자체보다는 inner model을 학습시키는 infrastructure로 바뀌어야 한다고 봅니다. 내용을 weights로 계속 distill하고, harness 자체는 얇게 유지하는 방향입니다.
- 후속 연구 방향으로 sparse data에서 학습하는 model-based RL, teacher 없이 sparse reward로 학습하는 RL, on-policy (self-)distillation, trust-region update를 제시합니다.
- 한계: 실험 대부분이 비교적 작은 model과 가장 쉬운 track인 ARC-AGI-1에서 이루어졌습니다. ARC-AGI-2/3 track과 frontier model 평가는 후속 과제로 남아 있습니다.
- 외부 제출은 공개되지 않은 private rule 50개로 검증합니다. 이를 통해 커뮤니티가 memory 기반 continual learning과 weight 기반 continual learning을 같은 기준으로 비교할 수 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] How Many Exposures Does a World Model Need? Learning Unseen Game Mechanics at Test Time
- [논문리뷰] World In-Context Learning for Agentic Robot Manipulation
- [논문리뷰] Experience-Handoff Reinforcement Learning for Recursive Self-Improvement
- [논문리뷰] G-CAST: Governed Continual Self-Training for E-Commerce Agents under Evolving Demands
Review 의 다른글
- 이전글 [논문리뷰] CANTraj: Recovering Vehicle Trajectories from CAN Signals in Naturalistic Driving
- 현재글 : [논문리뷰] Continual-ARC: Measuring Skill Acquisition over a Working Lifetime
- 다음글 [논문리뷰] Disen-Forcing: Disentangling Semantic Anchoring from Motion for Autoregressive Video Diffusion
댓글